מבוא ל-RAG
איזו בעיה RAG פותר
LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI. יודע רק את מה שהיה בנתוני האימון שלו, והידע הזה קפוא בנקודת זמן אחת: ה-knowledge cutoff. כל מה שקרה אחריה, וכל מה שמעולם לא היה ברשת הציבורית (מסמכים פנימיים של חברה, תיעוד מוצר, טיקטים, חוזים, קוד פרטי), פשוט לא קיים מבחינת המודל.
הבעיה החמורה יותר היא שהמודל לא יודע שהוא לא יודע. כשהוא נשאל על עובדה שלא ראה, הוא עדיין מייצר את הרצף הסביר ביותר סטטיסטית, ולכן מקבלים hallucination: תשובה רהוטה, בטוחה בעצמה ושגויה. אין לו מנגנון פנימי שמבדיל בין עובדה שנלמדה היטב לבין השלמה שנשמעת סבירה.
יש גם דרישה שלישית שקשה לענות עליה בלי RAG: ייחוס. במערכות ארגוניות לא מספיק שהתשובה נכונה. צריך לדעת מאיזה מסמך היא הגיעה, כדי שמשתמש יוכל לאמת אותה וכדי שאפשר יהיה לבדוק אותה בדיעבד.
RAG (Retrieval-Augmented Generation, מונח שטבעו Lewis ועמיתיו ב-2020) פותר את שלוש הבעיות באותו רעיון. לפני שהמודל עונה, שולפים (retrieve) מתוך מאגר ידע חיצוני את הקטעים הרלוונטיים לשאלה. מכניסים אותם לפרומפט (augment) ומבקשים מהמודל לייצר (generate) תשובה שמבוססת עליהם בלבד. הידע יושב מחוץ למודל: אפשר לעדכן אותו בכל רגע, להגביל גישה אליו, ולהצביע על המקור של כל טענה.
כבר נתקלנו ב-RAG בפרק הראשון של נושא ה-Vector Searchחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי., שם הוא הוצג כמניע המרכזי לחיפוש וקטורי: הדרך לתת ל-LLM גישה לידע עדכני או פרטי. שם הוא היה דוגמה לשימוש. בנושא הזה הוא עומד במרכז, ונפרק אותו לכל המנגנונים שצריך כדי לממש אותו.
חשוב להבין מה RAG לא עושה: הוא לא משנה את המשקלות של המודל ולא מלמד אותו שום דבר. הוא משנה רק את ה-input. לכן כל איכות התשובה תלויה בשני דברים: האם הקטעים הנכונים באמת נשלפו, והאם המודל השתמש בהם נאמנה. כל שאר הנושא עוסק בשני הדברים האלה.
RAG מול Fine-tuning מול Long Context
Fine-tuningאימון נוסף של מודל מאומן על דוגמאות ממוקדות (הוראות, שיחות, משימות ספציפיות) כדי שיתנהג כרצוי. מתוך LLM, איך בונים, מאמנים ומודדים LLM. מעדכן את משקלות המודל על דאטה נוסף. הוא טוב מאוד בלימוד התנהגות: פורמט פלט, טון, סגנון, שימוש עקבי בטרמינולוגיה של דומיין או משימה צרה שחוזרת על עצמה. הוא גרוע בהזרקת עובדות. העובדות נספגות במשקלות באופן לא אמין, אי אפשר לעדכן או למחוק עובדה בודדת בלי אימון מחדש, אי אפשר לדעת מאיזה מקור הגיעה תשובה, ואין דרך לאכוף הרשאות, כי כל מי שמשתמש במודל נחשף לכל מה שהוא ספג.
Long context, כלומר להכניס את כל המסמכים לפרומפט, נראה כמו פתרון פשוט עכשיו שחלונות הקונטקסט גדלו. בנושא ה-LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI., בסעיף 'Context Windowכל מה שהמודל "רואה" ברגע נתון: System Prompt, היסטוריית השיחה, קבצים, תוצאות כלים וההודעה הנוכחית. יש לו מגבלת טוקנים. מתוך LLM, יסודות ה-AI. — הזיכרון של ה-AI', ראינו שהחלון סופי. גם כשהוא גדול, יש לזה מחיר: עלות ו-latency עולים עם כל טוקןהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM. בכל קריאה, ומודלים נוטים לנצל פחות טוב מידע שקבור באמצע קונטקסט ארוך (נחזור לזה בפרק 8). מאגר ידע ארגוני של אלפי מסמכים גם פשוט לא נכנס.
RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG. נמצא באמצע. הידע עדכני ברמת המסמך הבודד (משנים מסמך ומאנדקסים אותו מחדש תוך שניות), העלות לשאלה קבועה פחות או יותר ולא תלויה בגודל המאגר, אפשר לסנן לפי הרשאות המשתמש לפני שהמידע מגיע למודל, וכל תשובה ניתנת לייחוס. המחיר הוא מורכבות הנדסית: pipeline שלם שכל שלב בו יכול להיכשל, וזה בדיוק מה שהנושא הזה מלמד לבנות.
בפועל אלה לא חלופות שמוציאות זו את זו. דפוס נפוץ: RAG אחראי על הידע, fine-tuning (אם בכלל) אחראי על ההתנהגות, למשל לענות תמיד בפורמט מסוים עם ציטוטים. Long context משמש כשהמאגר קטן מספיק, או ככלי משלים בשלב ה-generation, שבו מכניסים מסמכים שלמים במקום קטעים אחרי שה-retrieval כבר צמצם אותם.
כלל אצבע: אם השאלה היא 'המודל לא יודע X', הפתרון הוא כמעט תמיד RAG. אם השאלה היא 'המודל לא מתנהג כמו שאני רוצה', זה prompt engineeringניסוח הקלט למודל, למשל System Prompt שמגדיר תפקיד, טון ופורמט, ו-Few-Shot Examples שמדגימים את הפלט הרצוי. מתוך LLM, יסודות ה-AI. ואחר כך fine-tuning. אם כל הידע הרלוונטי הוא כמה עשרות עמודים שמשתנים לעתים רחוקות, שווה לבדוק קודם אם long context עם prompt caching לא מספיק.
הארכיטקטורה: שלב ה-Indexing (offline)
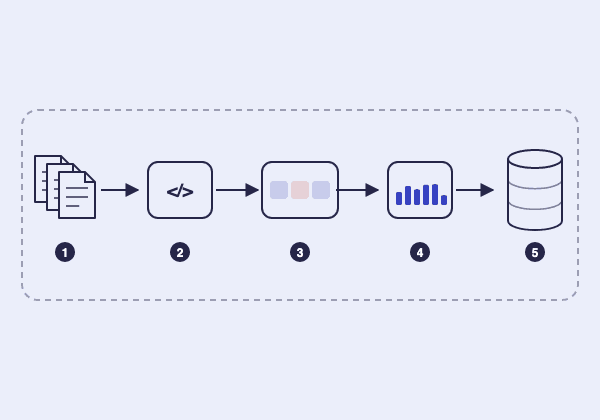
כל מערכת RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG. בנויה משני שלבים שרצים בזמנים שונים. הראשון הוא ה-indexing: תהליך offline (batch או streaming) שמכין את מאגר הידע לשליפה מהירה. הוא רץ כשמסמכים נוספים או משתנים, לא כשמשתמש שואל.
השלבים שלו: Ingest (משיכת מסמכים מהמקורות), Parse (המרת PDF, HTML ו-DOCX לטקסט נקי עם מבנה ו-metadata), Chunk (חלוקה לקטעים בגודל שמתאים לשליפה), Embed (הפיכת כל קטע לוקטור) ו-Index (שמירה במסד נתונים וקטורי ולרוב גם באינדקס טקסטואלי כמו BM25אלגוריתם הדירוג הלקסיקלי הסטנדרטי, שנותן משקל גבוה למונחים נדירים במאגר (IDF). מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים., יחד עם ה-metadata).
את הגרסה הבסיסית של השרשרת הזו כבר בנינו בנושא ה-Vector Searchחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי., בפרק 'בניית pipeline לחיפוש וקטורי'. כאן נעמיק בכל חוליה, כי ב-RAG ההחלטות בשלב הזה (איך מפרסרים טבלה, איפה חותכים קטע, איזה metadata שומרים) קובעות את התקרה של איכות המערכת. שום מודל חכם בשלב ה-generation לא יציל קטע שנחתך באמצע משפט או טבלה שהפכה לרצף מספרים חסר משמעות.
תכונה חשובה של השלב הזה היא שהוא יקר פעם אחת ולא בכל שאלה. אפשר להשקיע בו חישוב כבד (parsing עם מודל layout, קריאת LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI. לכל קטע כדי להוסיף לו הקשר, כמו שנראה בפרק 3), כי העלות מתחלקת על כל השאילתות העתידיות.
הארכיטקטורה: שלב ה-Query (online)
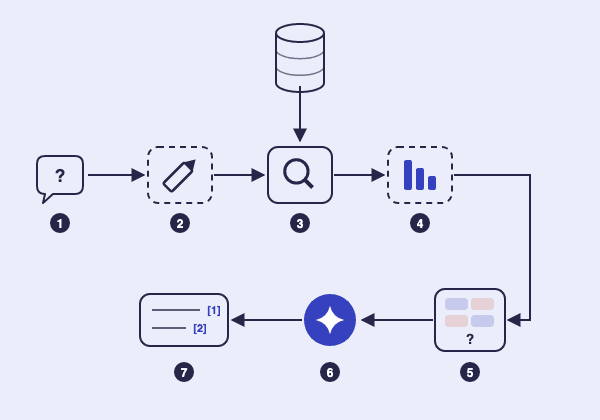
השלב השני רץ בכל פעם שמשתמש שואל, ולכן הוא רגיש ל-latency ולעלות לשאלה. השרשרת המלאה: Query → Transform (אופציונלי) → Retrieve → Rerankשלב שני אחרי השליפה: מודל מדויק ויקר יותר מדרג מחדש רק את המועמדים ובוחר את הטובים ביותר. מתוך RAG, Reranking — דירוג מחדש. (אופציונלי) → Augment → Generate → Cite.
Transform משכתב את השאלה לפני החיפוש: הופך שאלת המשך בשיחה לשאלה עצמאית, מפרק שאלה מורכבת לתתי-שאלות וכדומה. Retrieve שולף מועמדים מהאינדקס, בחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי., בחיפוש מילות מפתח או בשילוב שלהם. Rerank מדרג מחדש את המועמדים במודל מדויק ויקר יותר ומשאיר רק את הטובים ביותר.
Augment בונה את הפרומפט: הוראות, הקטעים שנבחרו עם מזהי מקור, והשאלה. Generate מפעיל את ה-LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI.. Cite ממפה את הציטוטים בתשובה חזרה למסמכים, ומוודא שכל מזהה שהמודל ציטט באמת היה בקונטקסט.
שני השלבים האופציונליים, Transform ו-Rerank, הם בדיוק מה שמבדיל בין 'naive RAGהמימוש המינימלי: chunking בגודל קבוע, חיפוש וקטורי בלבד, top-k קבוע ופרומפט פשוט. מתוך RAG, מבוא ל-RAG.' ל-RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG. שעובד בפרודקשן. כל אחד מוסיף latency ועלות, ולכן מוסיפים אותם כשמדידה מראה שהם נחוצים ולא כברירת מחדל. זה גם הסיבה שהפרק האחרון בנושא מוקדש להערכה.
Naive RAG בקוד: קו הבסיס
הנה המימוש המינימלי של שני השלבים. זה 'naive RAG': chunkingפיצול מסמכים ארוכים לקטעים (chunks) בגודל סביר לפני יצירת embeddings. מתוך Vector Search, בניית pipeline לחיפוש וקטורי. בגודל קבוע, חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. בלבד, top-kכמה קטעים שולפים מהאינדקס; k גדול משפר recall אבל מכניס יותר רעש ויותר טוקנים. מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים. קבוע ופרומפט פשוט. הוא עובד מפתיע טוב על שאלות פשוטות, ונכשל בדרכים צפויות. השאלות מנוסחות אחרת מהמסמכים, מזהים מדויקים כמו מק״ט או קוד שגיאה לא נמצאים בחיפוש סמנטי, הקטע הרלוונטי נחתך, או שה-top-5 מלא בקטעים דומים זה לזה.
שמות הלקוחות (embeddingClient, vectorStore, llmרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI.) גנריים בכוונה. כל ספק ו-SDK חושף ממשק קצת אחר, והמבנה הוא מה שחשוב. כל פרק בהמשך הנושא מחליף חוליה אחת בקוד הזה בגרסה חזקה יותר.
// ---------- Offline: indexing ----------
async function indexDocuments(docs: SourceDocument[]): Promise<void> {
  for (const doc of docs) {
    const chunks = chunkDocument(doc.text, { size: 500, overlap: 50 });
    const vectors = await embeddingClient.embedMany(chunks.map((c) => c.text));

    await vectorStore.upsert(
      chunks.map((chunk, i) => ({
        id: `${doc.id}#${i}`,
        vector: vectors[i],
        metadata: { docId: doc.id, title: doc.title, text: chunk.text },
      }))
    );
  }
}

// ---------- Online: query ----------
async function answer(question: string): Promise<string> {
  const queryVector = await embeddingClient.embed(question);
  const hits = await vectorStore.query({ vector: queryVector, topK: 5 });

  const context = hits
    .map((hit, i) => `[${i + 1}] ${hit.metadata.title}\n${hit.metadata.text}`)
    .join("\n\n");

  return llm.generate({
    system:
      "Answer only from the sources below. If the answer is not in them, say you don't know. Cite sources as [n].",
    prompt: `Sources:\n${context}\n\nQuestion: ${question}`,
  });
}
מפת הדרכים: איזה פרק מעמיק באיזו חוליה
שלב ה-indexing: פרק 2 (Ingestion ו-Parsing) עוסק בהפיכת מקורות אמיתיים לטקסט נקי עם metadata, ובשמירה על האינדקס מסונכרן. פרק 3 (Chunkingפיצול מסמכים ארוכים לקטעים (chunks) בגודל סביר לפני יצירת embeddings. מתוך Vector Search, בניית pipeline לחיפוש וקטורי.) עוסק באיפה ואיך חותכים. פרק 4 (Embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. ואינדוקס) עוסק בבחירת מודל ה-embedding, בתכנון הסכמה וב-multi-tenancyמערכת שמשרתת כמה לקוחות: אינדקס נפרד לכל tenant, או אינדקס משותף שבו כל שאילתה מסוננת לפי tenantId. מתוך RAG, Embeddings ואינדוקס עבור RAG..
שלב ה-query: פרק 5 (Retrieval) עוסק ב-dense, sparse ו-hybrid, ב-RRFאיחוד כמה רשימות תוצאות לפי הדירוג בלבד: כל מסמך מקבל 1/(k + rank) מכל רשימה, והציונים מסוכמים. מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים., בסינון וב-MMRMaximal Marginal Relevance: בחירת תוצאות אחת-אחת שמתגמלת רלוונטיות ומענישה דמיון למה שכבר נבחר. מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים.. פרק 6 (Query Transformation) עוסק בשכתוב שאלות, multi-queryשכתוב השאילתה כך שתתאים לשפת המסמכים, או יצירת כמה ניסוחים שונים שלה ואיחוד התוצאות. מתוך RAG, Query Transformation — שיפור השאילתה. ו-HyDEבמקום embedding לשאלה, מבקשים מ-LLM לכתוב פסקה היפותטית שעונה עליה ומחפשים לפיה. מתוך RAG, Query Transformation — שיפור השאילתה.. פרק 7 (Rerankingשלב שני אחרי השליפה: מודל מדויק ויקר יותר מדרג מחדש רק את המועמדים ובוחר את הטובים ביותר. מתוך RAG, Reranking — דירוג מחדש.) עוסק ב-cross-encodersמודל שמקבל את השאילתה והקטע יחד ומוציא ציון רלוונטיות, לעומת bi-encoder שמקודד כל אחד מהם בנפרד. מתוך RAG, Reranking — דירוג מחדש. וב-retrieval דו-שלבי. פרק 8 (Augmentation ו-Generation) עוסק בהרכבת הפרומפט, תקציב קונטקסט, ציטוטים וסירוב מבוסס.
מעבר ל-pipeline הלינארי: פרק 9 מציג ארכיטקטורות מתקדמות (Agentic RAGה-retrieval הופך לכלי שה-LLM מפעיל בעצמו: הוא מחליט אם לחפש, מנסח את השאילתה ומחפש שוב אם צריך. מתוך RAG, ארכיטקטורות RAG מתקדמות., Self-RAGארכיטקטורות שמוסיפות ל-RAG ביקורת עצמית: בדיקה אם צריך retrieval, אם הקטעים רלוונטיים ומה עושים כשהשליפה נכשלה. מתוך RAG, ארכיטקטורות RAG מתקדמות., CRAG, GraphRAGLLM מחלץ ישויות וקשרים מכל קטע לגרף ידע, כדי לענות על שאלות גלובליות על המאגר כולו. מתוך RAG, ארכיטקטורות RAG מתקדמות.). פרק 10 עוסק במדידה, כלומר איך יודעים שהשינוי שעשיתם באמת שיפר משהו, ובנושאי פרודקשן: caching, הרשאות ו-prompt injectionהתקפה שבה מישהו מכניס הוראות לטקסט שהמודל קורא, כדי לגרום לסוכן לעשות משהו שהמשתמש לא ביקש. מתוך AI Agents, Prompt Injection ואבטחת סוכנים. דרך מסמכים.
שאלות נפוצות
האם RAG מבטל לגמרי hallucinations?
לא. RAG מצמצם אותן משמעותית, אבל המודל עדיין יכול לפרש לא נכון קטע, לחבר שני קטעים למסקנה שאף אחד מהם לא אומר, או להשלים מהידע הכללי שלו כשהקונטקסט חלקי. לכן מערכות RAG בפרודקשן מוסיפות אימות ציטוטים, סירוב מבוסס ומדידת faithfulness, שנראה בפרקים 8 ו-10.
צריך מסד נתונים וקטורי ייעודי כדי להתחיל?
לא. מאגר קטן יכול לרוץ אפילו עם חיפוש מדויק בזיכרון, ומאגר בינוני מסתדר היטב עם תוסף וקטורי למסד שכבר יש לכם, כמו שראינו בנושא ה-Vector Search. כדאי לבחור משהו שתומך גם בחיפוש מילות מפתח ובסינון לפי metadata, כי שניהם יידרשו בהמשך הנושא.
במה RAG שונה מחיפוש רגיל עם LLM שמסכם את התוצאות?
ברעיון זה אותו דבר: שליפה, ואחריה generation על בסיס מה שנשלף. ההבדל הוא בדרישות. ב-RAG מקפידים שהתשובה תתבסס רק על המקורות, עם ציטוטים שאפשר לבדוק וסירוב כשאין מידע, ומשקיעים בשליפה כדי שהקטע הנכון באמת יגיע. חיפוש שמסכם תוצאות הוא נקודת התחלה טובה; הנושא הזה עוסק במה שצריך כדי שהוא יהיה אמין.