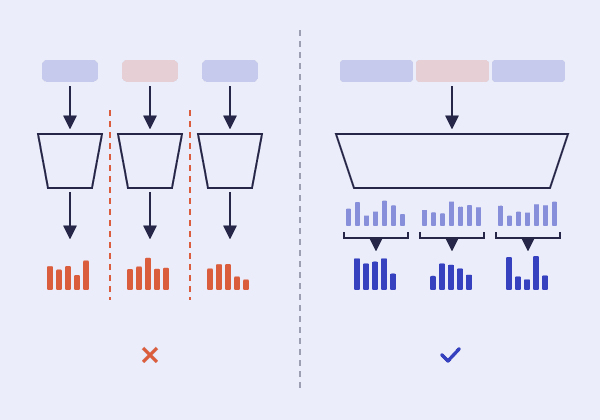
Chunking — חלוקת מסמכים לקטעים
גודל הקטע הוא trade-off, לא פרמטר
בנושא ה-Vector Search, בפרק 'בניית pipeline לחיפוש וקטורי', ראינו את הגרסה הבסיסית של chunking: חיתוך לפי גודל קבוע עם overlap. שם זה היה צעד אחד מתוך pipeline. ב-RAG זו אחת ההחלטות המשפיעות ביותר על האיכות, כי הקטע הוא גם יחידת השליפה וגם יחידת הקונטקסט שהמודל יקבל.
שני הכוחות מושכים לכיוונים הפוכים. קטע קטן מקבל embedding חד וממוקד: וקטור של פסקה אחת שעוסקת בנושא אחד מתאים היטב לשאלה על הנושא הזה. קטע גדול מערבב כמה נושאים לוקטור אחד ממוצע שלא דומה במיוחד לאף אחד מהם. מצד שני, קטע קטן מדי מאבד הקשר. משפט כמו 'המחיר עולה ל-40 ש״ח לחודש' חסר ערך אם נחתך ממנו לאיזה מוצר ומאיזה תאריך הוא מתייחס.
מודדים גודל קטע בטוקנים ולא בתווים, משתי סיבות. גם מודל ה-embedding וגם ה-LLM מוגבלים בטוקנים. בנוסף, היחס בין תווים לטוקנים משתנה מאוד בין שפות: טקסט עברי מתפרק בדרך כלל ליותר טוקנים לכל מילה מאשר אנגלית, כך ש-1,000 תווים בעברית ו-1,000 תווים באנגלית הם קטעים בגדלים שונים מאוד. משתמשים ב-tokenizer של מודל ה-embedding עצמו.
חשוב במיוחד: אם קטע ארוך מהמקסימום שמודל ה-embedding מקבל, הרבה APIs פשוט חותכים אותו בשקט. הסוף של הקטע לא מיוצג בוקטור בכלל, בלי שום שגיאה. לכן גודל הקטע המקסימלי נקבע גם לפי מגבלת הקלט של המודל.
אין גודל נכון אוניברסלי. טווח של כמה מאות טוקנים לקטע הוא נקודת פתיחה נפוצה, אבל הגודל הנכון תלוי בסוג המסמכים ובסוג השאלות. שאלות עובדתיות נקודתיות מעדיפות קטעים קטנים. שאלות שדורשות הסבר או סיכום מעדיפות גדולים. הדרך היחידה לדעת היא להריץ את אותו eval set (פרק 10) על כמה גדלים ולהשוות recall.
Fixed-size עם overlap
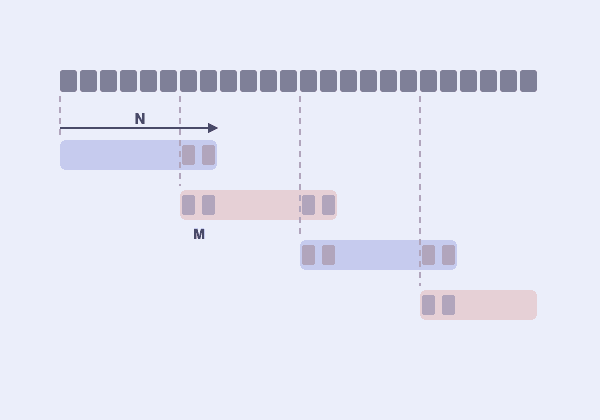
השיטה הפשוטה ביותר: חותכים כל N טוקנים, וכל קטע חוזר על M הטוקנים האחרונים של הקטע הקודם. ה-overlap קיים כדי שמשפט או רעיון שנפל על קו החיתוך יופיע שלם לפחות באחד משני הקטעים. ערכים נפוצים הם overlap של 10% עד 20% מגודל הקטע.
יש לשיטה הזו שני יתרונות אמיתיים: היא דטרמיניסטית, וכל הקטעים בגודל צפוי, מה שמקל על תקציב הקונטקסט. החיסרון הוא שהיא עיוורת לתוכן. היא חותכת באמצע משפט, באמצע רשימה ובאמצע טבלה, ומדביקה סוף של סעיף אחד לתחילת הסעיף הבא.
ל-overlap יש גם מחיר: הוא מגדיל את האינדקס (overlap של 20% הוא 20% יותר וקטורים לאחסן ולחפש), ומייצר קטעים שכנים שחולקים טקסט ולכן נשלפים יחד ותופסים מקומות ב-top-k. נטפל בזה ב-MMR בפרק 5 ובאיחוד קטעים חופפים בפרק 8.
Recursive splitting: לחתוך במקום הטבעי ביותר
Recursive splitting הוא ברירת המחדל הסבירה ברוב המערכות. מגדירים היררכיה של מפרידים, מהגס לעדין: כותרת, פסקה (שורה ריקה), שורה, סוף משפט ורווח. מנסים לחתוך לפי המפריד הגס ביותר. כל חלק שעדיין גדול מדי מפרקים שוב עם המפריד הבא ברשימה. חלקים קטנים סמוכים מאחדים חזרה עד שמגיעים לגודל המקסימלי.
התוצאה היא שהחיתוך קורה בגבול הטבעי הגבוה ביותר שאפשר: קטע מסתיים בסוף פסקה אם אפשר, בסוף משפט אם לא, ורק במקרה הגרוע באמצע משפט. התלות היחידה היא tokenizer, והשיטה עובדת טוב במיוחד על ה-Markdown המנורמל שייצרנו בפרק 2.
בקוד שלמטה המפריד נשמר בתחילת החלק שאחריו, כדי שכותרת Markdown לא תאבד את סימן ה-## שלה. שימו לב גם שה-overlap מתווסף אחרי הפיצול, ולכן קטע סופי יכול לעבור את maxTokens בגודל ה-overlap. צריך לתקצב את זה מול מגבלת מודל ה-embedding.
const SEPARATORS = ["\n## ", "\n### ", "\n\n", "\n", ". ", " "];

function recursiveSplit(text: string, maxTokens: number, separators = SEPARATORS): string[] {
  if (countTokens(text) <= maxTokens) return [text];

  const [sep, ...finer] = separators;
  if (sep === undefined) return hardSplitByTokens(text, maxTokens); // last resort

  // Keep the separator at the start of the piece that follows it
  const pieces = text.split(sep).map((p, i) => (i === 0 ? p : sep + p));
  const chunks: string[] = [];
  let current = "";

  for (const piece of pieces) {
    if (countTokens(current + piece) <= maxTokens) {
      current += piece;
      continue;
    }
    if (current) chunks.push(current);
    if (countTokens(piece) <= maxTokens) {
      current = piece;
    } else {
      chunks.push(...recursiveSplit(piece, maxTokens, finer)); // too big alone: go finer
      current = "";
    }
  }
  if (current) chunks.push(current);
  return chunks;
}

function addOverlap(chunks: string[], overlapTokens: number): string[] {
  return chunks.map((chunk, i) =>
    i === 0 ? chunk : lastTokens(chunks[i - 1], overlapTokens) + chunk
  );
}
Structure-aware chunking
Recursive splitting מכבד את המבנה רק ברמת המפרידים. Structure-aware chunking הולך צעד קדימה ומשתמש במבנה המסמך שחילצנו בשלב ה-parsing. כל קטע מתחיל בגבול של סעיף, ולא חוצה כותרת מסדר גבוה. כלומר סעיף 3.2 לא ימשיך לתוך 3.3, גם אם יש מקום.
יש יחידות שאסור לפצל בכלל, או שמפצלים אותן לפי כללים משלהן. טבלה נשמרת כיחידה אחת. אם היא גדולה מדי, מפצלים אותה לפי שורות וחוזרים על שורת הכותרות בכל חלק, כדי שכל חלק יהיה מובן לבד. בלוק קוד נחתך לפי פונקציות או מחלקות ולא לפי שורות. רשימה ממוספרת נשמרת עם המשפט שמציג אותה.
לכל קטע מצמידים את נתיב הכותרות שלו (sectionPath מהפרק הקודם), למשל ['מדריך התקנה', 'דרישות מערכת', 'Linux']. זה מאפשר contextual header זול: מוסיפים את הנתיב בתחילת הטקסט שעובר embedding, והקטע 'דורש לפחות 8GB RAM' הופך ל'מדריך התקנה > דרישות מערכת > Linux: דורש לפחות 8GB RAM'. תוספת פשוטה ודטרמיניסטית שבלעדיה השאלה 'מה דרישות הזיכרון בלינוקס' עלולה לא למצוא את הקטע.
Semantic chunking
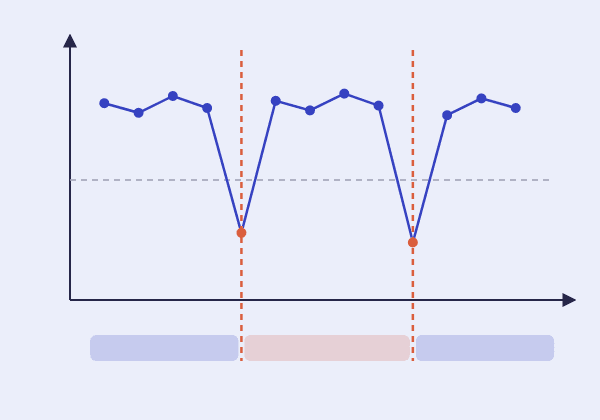
Semantic chunking מנסה לחתוך איפה שהנושא משתנה, גם כשאין סימון מבני. מפרקים את הטקסט למשפטים, מחשבים embedding לכל משפט (או לחלון של כמה משפטים סמוכים), ומחשבים את ה-cosine similarity בין כל זוג שכנים. כשהדמיון יורד בחדות, כנראה שהנושא התחלף, ושם חותכים.
הסף נקבע בדרך כלל יחסית למסמך ולא כערך מוחלט, למשל חיתוך בכל נקודה שבה ירידת הדמיון נמצאת באחוזון העליון של הירידות במסמך. ערך cosine מוחלט אומר דברים שונים במודלים שונים ובמסמכים שונים. בנוסף שומרים גודל מינימלי ומקסימלי, כדי שלא ייווצרו קטעים של משפט בודד או קטעים ענקיים.
המחיר: embedding לכל משפט בזמן האינדוקס, וסף שצריך לכוונן. התועלת מגיעה בעיקר בטקסט רציף בלי מבנה, כמו תמלולים, מיילים וצ'אטים. במסמכים עם כותרות ברורות, structure-aware chunking נותן תוצאה דומה בחלק קטן מהעלות. הרבה מערכות משלבות: חותכות לפי מבנה, ומשתמשות ב-semantic chunking רק בתוך סעיפים ארוכים.
Parent-child ו-Sentence window: לשלוף קטן, להחזיר גדול
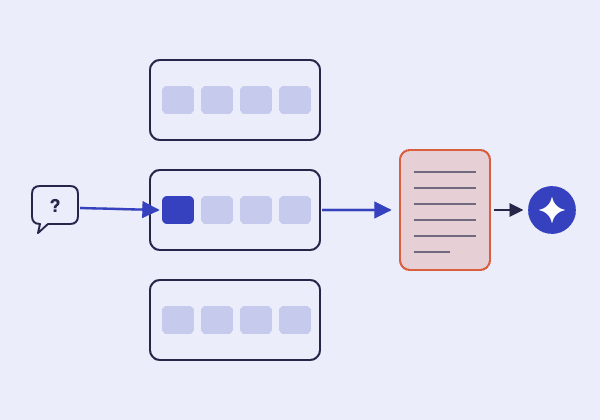
המתח בין קטע קטן (חד לשליפה) לקטע גדול (עשיר בהקשר) לא חייב הכרעה. אפשר להפריד בין יחידת השליפה ליחידת הקונטקסט. ב-parent-child, שנקרא גם small-to-big, מפצלים כל מסמך לקטעי הורה גדולים, כמו סעיף שלם, ואת כל הורה לקטעי ילד קטנים. רק הילדים עוברים embedding ונכנסים לאינדקס הוקטורי. ההורים נשמרים במאגר key-value. בזמן השאילתה מחפשים בין הילדים, ומחזירים ל-LLM את ההורים שלהם.
צריך לטפל בשני פרטים. כמה ילדים של אותו הורה יכולים להיות ב-top-k, ולכן מבצעים dedup לפי parentId, ובדרך כלל שולפים יותר ילדים מ-k כדי לקבל k הורים שונים. בנוסף, ההורים גדולים, כך ש-k הורים יכולים לתפוס הרבה מהקונטקסט. מחשבים את k לפי תקציב טוקנים ולא לפי מספר קבוע.
Sentence-window retrieval הוא וריאנט עדין יותר. כל משפט מאונדקס בנפרד, ובזמן השליפה מחזירים את המשפט יחד עם N המשפטים שלפניו ואחריו. זה מתאים לטקסט רציף שאין בו סעיפים טבעיים שיכולים לשמש הורים.
function buildParentChild(doc: ParsedDocument) {
  const parents = recursiveSplit(doc.body, 1500).map((text, i) => ({
    id: `${doc.id}#p${i}`,
    text,
  }));
  const children = parents.flatMap((parent) =>
    recursiveSplit(parent.text, 200).map((text, j) => ({
      id: `${parent.id}#c${j}`,
      parentId: parent.id,
      text,
    }))
  );
  return { parents, children }; // children -> vector index, parents -> key-value store
}

async function retrieveParents(query: string, k: number): Promise<string[]> {
  const hits = await vectorStore.query({
    vector: await embeddingClient.embed(query),
    topK: k * 4, // over-fetch: several children may share one parent
  });
  const parentIds = [...new Set(hits.map((hit) => hit.metadata.parentId))].slice(0, k);
  return Promise.all(parentIds.map((id) => parentStore.get(id)));
}
Contextual Retrieval: להחזיר לקטע את ההקשר שנחתך ממנו
הבעיה העמוקה של כל שיטות החיתוך היא שקטע שנחתך מאבד את ההקשר של המסמך. 'ההכנסות גדלו ב-3% לעומת הרבעון הקודם' לא אומר של איזו חברה ובאיזה רבעון, ולכן לא יימצא בשאלה 'מה היה הגידול בהכנסות של חברה X ברבעון השני'. ה-contextual header מהסעיף הקודם פותר את זה חלקית, בתנאי שהמידע החסר נמצא בכותרות.
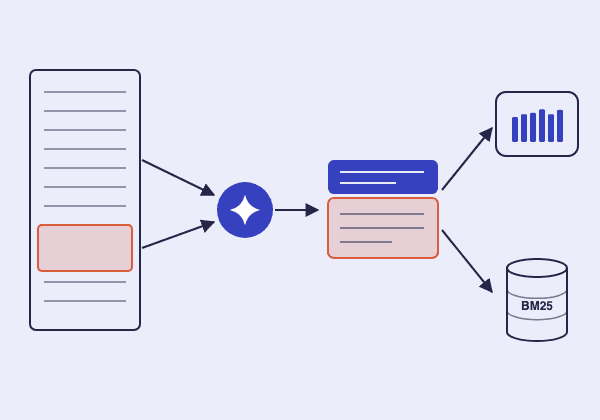
Contextual Retrieval היא טכניקה ש-Anthropic פרסמה ב-2024, והיא פותרת את זה באופן כללי. לפני ה-embedding שולחים ל-LLM את המסמך המלא יחד עם הקטע, ומבקשים הקשר קצר (בערך 50 עד 100 טוקנים) שממקם את הקטע בתוך המסמך. את ההקשר מצמידים לתחילת הקטע, והטקסט המשולב הוא מה שעובר גם embedding וגם אינדוקס BM25. לפי הדיווח של Anthropic, השילוב הפחית משמעותית את שיעור כשלי השליפה, ועוד יותר כשהוא שולב עם reranking (פרק 7).
העלות היא קריאת LLM לכל קטע, עם המסמך כולו בפרומפט. מה שהופך את זה למעשי הוא prompt caching: המסמך נמצא בתחילת הפרומפט וזהה לכל הקטעים שלו, ולכן הוא נשמר ב-cache, ורק החלק של הקטע משתנה. זה בדיוק סוג החישוב הכבד שהפרק הראשון אמר שכדאי להשקיע בו בשלב ה-offline.
פרט מימושי: שומרים שני טקסטים לכל קטע. indexText (הקשר + קטע) הוא מה שמאנדקסים. text (הקטע המקורי) הוא מה שמציגים בציטוט, כדי שהמשתמש יראה את לשון המסמך ולא את הניסוח של ה-LLM.
async function contextualizeChunk(doc: ParsedDocument, chunk: string): Promise<string> {
  const context = await llm.generate({
    // The document comes first and is identical for all of its chunks,
    // so it can be served from the prompt cache.
    prompt: `<document>\n${doc.body}\n</document>

Here is a chunk from the document above:
<chunk>\n${chunk}\n</chunk>

Write a short context (1-2 sentences) that situates this chunk within the
document, to improve search retrieval of the chunk. Answer only with the context.`,
    maxTokens: 120,
  });
  return `${context.trim()}\n\n${chunk}`; // becomes indexText; keep the original as text
}
Late chunking
Late chunking, שהוצג על ידי Jina AI ב-2024, תוקף את אותה בעיה מכיוון אחר ובלי קריאות LLM. במקום לחתוך ואז לבצע embedding, מריצים את המסמך כולו (או חלון גדול ממנו) דרך מודל embedding עם קונטקסט ארוך. לוקחים את ה-embeddings ברמת הטוקן, כלומר הפלט של ה-transformer לפני ה-pooling, ורק אז מחלקים אותם לפי גבולות הקטעים. ה-pooling (בדרך כלל ממוצע) נעשה לכל קטע בנפרד.
מכיוון שמנגנון ה-attention ראה את המסמך כולו, כל embedding של טוקן כבר מושפע מההקשר שלו. 'ההכנסות' בקטע יודעות על איזו חברה מדובר, כי שם החברה הופיע קודם במסמך. כך כל וקטור קטע נושא הקשר של מסמך, בעלות של מעבר embedding אחד.
המגבלות: צריך מודל עם חלון קלט ארוך, וגישה ל-embeddings ברמת הטוקן. הרבה APIs מתארחים מחזירים רק וקטור מסוכם אחד, ולכן זה דורש בדרך כלל מודל שמריצים בעצמכם או API שתומך בזה במפורש. זו טכניקה חדשה יחסית, וכדאי למדוד אותה מול contextual retrieval על הדאטה שלכם לפני שבוחרים.