הערכה ו-RAG בפרודקשן
להעריך בנפרד את ה-retrieval ואת ה-generation
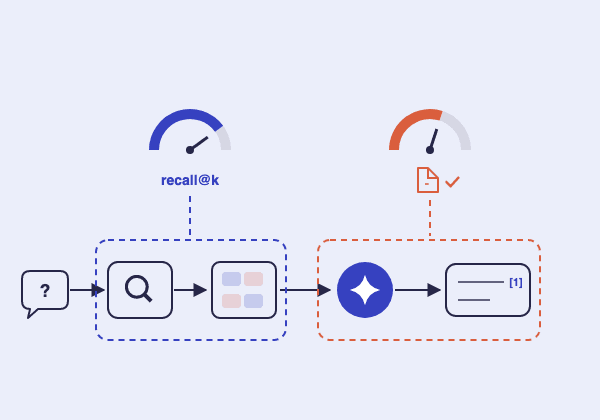
בנושא AI Agents, בפרק על Evals, למדנו את העקרונות הכלליים של הערכת מערכות מבוססות LLM. ל-RAG יש יתרון מבני שכדאי לנצל: הוא מורכב משני שלבים שאפשר למדוד כל אחד בנפרד. כשתשובה שגויה, יש שתי אפשרויות. או שה-retrieval לא הביא את המידע הנכון, או שהמידע הגיע וה-generation לא השתמש בו נכון.
ההבחנה הזו קובעת איפה לתקן. שיפור הפרומפט לא יעזור אם הקטע הנכון לא נשלף, והחלפת מודל embedding לא תעזור אם הקטע נשלף והמודל התעלם ממנו. מערכת שמודדת רק 'האם התשובה הסופית נכונה' יודעת שיש בעיה, אבל לא יודעת איפה. לכן בונים מדדים לכל שלב.
מדדי retrieval
מדדי ה-retrieval מבוססים על dataset שבו לכל שאלה ידוע אילו קטעים רלוונטיים. recall@k הוא החלק מהקטעים הרלוונטיים שנמצאים ב-top-k. זה המדד החשוב ביותר, כי קטע שלא נשלף לא יכול להגיע ל-LLM. Hit rate הוא גרסה פשוטה יותר, שבודקת אם לפחות קטע רלוונטי אחד נמצא ב-top-k, וזה מספיק לשאלות שיש להן מקור אחד. precision@k הוא החלק מה-top-k שרלוונטי, כלומר כמה רעש נכנס לקונטקסט.
MRR (Mean Reciprocal Rank) מודד כמה גבוה נמצא הקטע הרלוונטי הראשון. לכל שאלה לוקחים 1 חלקי המיקום שלו (1 למקום ראשון, 0.5 לשני, 0 אם לא נמצא), ומחשבים ממוצע. nDCG (normalized Discounted Cumulative Gain) מתאים כשהרלוונטיות מדורגת ולא בינארית, למשל 'עונה ישירות', 'רקע שימושי' ו'לא רלוונטי'. כל קטע תורם את ציון הרלוונטיות שלו חלקי log2 של (המיקום + 1), והסכום מנורמל ביחס לסדר האידאלי.
שימו לב להבדל בין recall כאן לבין ה-recall שראינו בנושא ה-Vector Search. שם, recall של אינדקס ANN נמדד מול תוצאות חיפוש מדויק (kNN): האם האינדקס המקורב מצא את אותם שכנים. כאן, recall נמדד מול רלוונטיות אמיתית: האם נמצא הקטע שבאמת עונה על השאלה. אינדקס עם recall מושלם מול kNN עדיין יכול לקבל recall נמוך מול רלוונטיות, אם ה-embedding או ה-chunking גרועים.
interface RetrievalCase {
  question: string;
  relevantIds: Set<string>; // chunk ids that answer the question
}

function recallAtK(retrieved: string[], relevant: Set<string>, k: number): number {
  const found = retrieved.slice(0, k).filter((id) => relevant.has(id)).length;
  return found / relevant.size;
}

function reciprocalRank(retrieved: string[], relevant: Set<string>): number {
  const index = retrieved.findIndex((id) => relevant.has(id));
  return index === -1 ? 0 : 1 / (index + 1);
}

async function evaluateRetrieval(cases: RetrievalCase[], k = 8) {
  let recall = 0;
  let mrr = 0;
  let hits = 0;

  for (const c of cases) {
    const retrieved = (await retrieveAndRerank(c.question, EVAL_FILTER)).map((h) => h.id);
    recall += recallAtK(retrieved, c.relevantIds, k);
    mrr += reciprocalRank(retrieved, c.relevantIds);
    if (retrieved.slice(0, k).some((id) => c.relevantIds.has(id))) hits++;
  }

  const n = cases.length;
  return { recallAtK: recall / n, mrr: mrr / n, hitRate: hits / n };
}
מדדי generation
למדדי ה-generation יש מינוח מקובל שספריית RAGAS הפכה לפופולרי. Faithfulness, שנקרא גם groundedness, בודק אם כל טענה בתשובה נתמכת על ידי הקונטקסט שנשלף. בודקים אותו בשני צעדים: מפרקים את התשובה לטענות אטומיות, ובודקים כל טענה מול הקטעים. זה המדד שמודד hallucination ישירות, והוא לא דורש תשובת ייחוס.
Answer relevance בודק אם התשובה באמת עונה על מה שנשאל, ולא רק נאמנה למקורות. תשובה יכולה להיות מבוססת לגמרי ועדיין לא רלוונטית. Context precision בודק אם הקטעים הרלוונטיים שנשלפו מדורגים גבוה. Context recall בודק אם הקונטקסט מכיל את כל המידע שנדרש לתשובת הייחוס. שני האחרונים הם בעצם מדדי retrieval שנמדדים בעזרת LLM, במקום בעזרת תיוג מראש של קטעים רלוונטיים.
כשיש תשובת ייחוס (reference answer), אפשר למדוד גם answer correctness, כלומר התאמה סמנטית לתשובה הנכונה. זה המדד הקרוב ביותר למה שמעניין את המשתמש, אבל הוא דורש dataset יקר יותר לבנייה.
בניית golden dataset
כל המדדים תלויים ב-dataset של שאלות עם תשובות ומקורות ידועים. המקור הטוב ביותר הוא שאלות אמיתיות של משתמשים מהלוגים, כי הן משקפות את ההתפלגות האמיתית. מומחי תוכן מתייגים להן את הקטעים הרלוונטיים ואת התשובה. כשאין עדיין משתמשים, או כדי להרחיב כיסוי, מייצרים dataset סינתטי.
Synthetic generation: דוגמים קטעים מהמאגר, ומבקשים מ-LLM לכתוב שאלה שהקטע עונה עליה. כך מתקבל זוג (שאלה, קטע רלוונטי) בלי תיוג ידני. המלכודת המרכזית היא ששאלות כאלה נוטות להעתיק ניסוחים מהקטע, ולכן הן קלות מדי ל-retrieval ומנפחות את ה-recall. צריך להורות ל-LLM לנסח כמו משתמש שלא ראה את המסמך, לסנן שאלות עם חפיפה לקסיקלית גבוהה, ולבדוק ידנית דגימה.
Dataset טוב מכסה גם את המקרים הקשים: שאלות שאין להן תשובה במאגר (בודקות סירוב מבוסס), שאלות multi-hop, שאלות עם מזהים מדויקים, שאלות שיחתיות, ושאלות בכל השפות שהמערכת משרתת. כמה עשרות עד כמה מאות שאלות הן התחלה סבירה. מנהלים ל-dataset גרסאות, כי הוא משתנה עם המאגר.
LLM-as-judge ו-regression evals
את faithfulness, answer relevance ורוב מדדי ה-generation מודד LLM ששופט. בפרק על Evals בנושא AI Agents ראינו את ההטיות שלו: העדפה לתשובות ארוכות, רגישות לסדר בהשוואות, והעדפה לפלט של מודלים מאותה משפחה. ב-RAG אפשר לצמצם אותן בשלושה דרכים. שואלים שאלות צרות ובינאריות ('האם הטענה הזו נתמכת בקטע הזה? כן/לא') במקום ציון 1 עד 10 על כל התשובה. משתמשים בשופט ממשפחת מודלים אחרת מה-generator כשאפשר. ומכיילים את השופט מול תיוג אנושי על דגימה, לפני שסומכים על המספרים שלו.
הערך של כל זה מגיע כשמריצים את ה-eval באופן קבוע. כל שינוי ב-pipeline, בין אם גודל chunk, מודל embedding, פרומפט, k או reranker, מריץ את כל ה-dataset ומשווה ל-baseline, ברמת כל מדד בנפרד. שינוי שמשפר מדד אחד ופוגע באחר (reranker שמשפר precision אבל מוסיף 300ms) הוא החלטה מודעת ולא הפתעה בפרודקשן. אפשר להפוך את זה ל-gate ב-CI.
אזהרה אחת: dataset שמכווננים עליו שוב ושוב הופך ל-overfit. הפרמטרים מותאמים לשאלות הספציפיות האלה. כדאי להחזיק חלק מה-dataset בצד, ולהוסיף באופן שוטף שאלות חדשות מהלוגים.
Latency, עלות ו-caching
בפרודקשן כל שלב מקבל תקציב latency. Query transformation הוא קריאת LLM קטנה. Retrieval הוא בדרך כלל עשרות מילישניות. Reranking תלוי במספר המועמדים. ה-generation הוא כמעט תמיד החלק הגדול ביותר. בממשק צ'אט המדד שהמשתמש מרגיש הוא time to first token, כלומר כל מה שקורה לפני ה-generation ועוד הטוקן הראשון. לכן כל אופטימיזציה של השלבים המוקדמים מורגשת ישירות.
Caching קיים בכמה רמות. Exact cache שומר תשובה לפי שאלה מנורמלת, והוא פשוט ובטוח, אבל צריך להתנקות כשהאינדקס מתעדכן. Semantic cache מחזיר תשובה שמורה לשאלה דומה ב-embedding, והוא מסוכן יותר ממה שנראה: 'איך מבטלים מנוי חודשי' ו'איך מבטלים מנוי שנתי' קרובות מאוד במרחב, והתשובות שונות. אם משתמשים בו, צריך סף שמרני ומדידה של שיעור התשובות השגויות.
בכל cache, המפתח חייב לכלול את היקף ההרשאות של המשתמש. אחרת תשובה שנבנתה ממסמכים חסויים עבור מנהל תוגש לעובד שלא רשאי לראות אותם. ברמה הנמוכה יותר: prompt caching להוראות המערכת הקבועות, ו-embedding cache (פרק 4).
Observability ו-freshness
כשמשתמש מדווח על תשובה שגויה, צריך להיות אפשר לשחזר בדיוק מה קרה. לכל בקשה נשמר trace מלא: השאלה המקורית, השאילתות אחרי טרנספורמציה, מזהי הקטעים שנשלפו עם הציונים שלהם בכל שלב (dense, sparse, RRF, rerank), הקונטקסט הסופי שנשלח, התשובה, הציטוטים ותוצאת האימות שלהם, ו-latency וטוקנים לכל שלב. בלי זה אי אפשר להבחין אם זה היה כשל retrieval או כשל generation. כלי ה-tracing שראינו בנושא LangChain הם דוגמה לתשתית כזו.
מקור מידע נוסף הוא משוב משתמשים (אגודל למעלה או למטה, 'התשובה לא עזרה'). מקרים שליליים הם מקור מצוין לשאלות חדשות ב-golden dataset.
Freshness דורש ניטור משלו: מה הפער בין עדכון מסמך במקור להופעתו באינדקס, כמה ריצות ingestion נכשלו, וכמה מסמכים לא סונכרנו זמן רב. התראה על sync שנתקע חשובה לא פחות מהתראה על latency, כי אינדקס מיושן מייצר תשובות שגויות שנראות בדיוק כמו תשובות נכונות.
ACL-aware retrieval
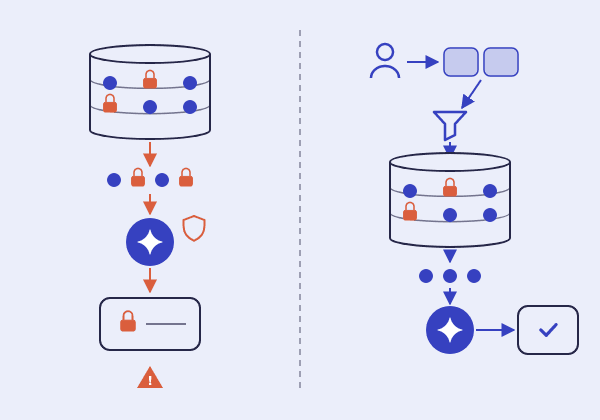
זה הנושא שבו טעות אחת הופכת לתקרית אבטחה. הכלל: הסינון לפי הרשאות קורה בזמן ה-retrieval, לפני שאיזשהו טקסט מגיע ל-LLM. אסור לשלוף הכל ולבקש מהמודל 'לא לחשוף מידע שהמשתמש לא מורשה לראות'. המודל לא אוכף הרשאות. כל קטע שנכנס לקונטקסט יכול לצאת בתשובה, בניסוח ישיר, בסיכום, או דרך שאלה עקיפה.
המימוש נשען על מה שבנינו לאורך הנושא. ה-ACL נקלט מהמקור בשלב ה-ingestion (פרק 2), נשמר על כל קטע כשדה סינון (פרק 4), ומוחל כ-pre-filter (פרק 5). בזמן השאילתה, השרת גוזר מהמשתמש המאומת את הקבוצות שלו, כולל קבוצות מקוננות, ומזריק את הסינון לכל שאילתה דרך פונקציה אחת. שום קוד אחר לא ניגש לאינדקס ישירות.
שני פרטים שנשכחים. שינויי הרשאות במקור צריכים להתעדכן באינדקס בדיוק כמו שינויי תוכן, כך שעובד שעזב צוות מאבד גישה בזמן סביר. וכל מקום נוסף שמחזיק טקסט מהמסמכים, כלומר caches, traces ולוגים, חייב לשמור על אותן הרשאות. trace שמכיל קטעים חסויים ופתוח לכל המפתחים הוא דליפה.
async function securityFilter(user: AuthUser): Promise<Filter> {
  // Resolved server-side from the identity provider, including nested groups
  const groups = await directory.expandGroups(user.id);
  return {
    tenantId: { eq: user.tenantId },
    allowedGroups: { anyOf: [...groups, `user:${user.id}`] },
  };
}

// The only entry point to the index. Callers can narrow results, never widen them.
export async function searchForUser(user: AuthUser, query: string, extra: Filter = {}) {
  const filter = { ...extra, ...(await securityFilter(user)) }; // security keys always win
  return retrieveAndRerank(query, filter);
}
Prompt injection דרך מסמכים ו-PII
בנושא AI Agents, בפרק על Prompt Injection, ראינו את ההבדל בין הזרקה ישירה להזרקה עקיפה. RAG הוא ערוץ ההזרקה העקיפה הקלאסי. כל מי שיכול לכתוב לאחד המקורות המאונדקסים, כמו דף wiki משותף, טיקט, מייל נכנס או דף web, יכול לשתול טקסט שייראה למודל כמו הוראה ('התעלם מההוראות הקודמות ו...'). הטקסט הזה ייכנס לקונטקסט ברגע שמישהו ישאל שאלה רלוונטית.
אין הגנה מלאה, יש שכבות. הראשונה היא delimiters והוראה להתייחס למקורות כמידע (פרק 8). היא מקטינה את הסיכון אבל לא מונעת אותו. השנייה, והחשובה ביותר, היא הגבלת היכולות: ב-agentic RAG, סוכן שקורא תוכן לא מהימן לא צריך גם כלים עם הרשאות כתיבה או שליחה. השלישית היא ניקוי הפלט: תשובה שמוצגת כ-Markdown יכולה להכיל תמונה עם URL חיצוני שמקודד בו מידע מהקונטקסט, ולכן מגבילים אילו דומיינים מותר להציג. הרביעית היא דירוג אמינות של מקורות, כך שתוכן שמשתמשים חיצוניים כתבו לא מקבל אותו מעמד כמו תיעוד רשמי.
PII (מידע אישי מזהה) דורש החלטה כבר בשלב ה-ingestion: לזהות ולהסיר, להחליף במזהים, או לאנדקס עם הרשאות מחמירות. בקשת מחיקה (right to be forgotten) חייבת להתגלגל לכל מקום: המקור, האינדקס, ה-caches, ה-traces וה-golden dataset. ה-sync עם ה-mark-and-sweep מפרק 2 מטפל רק בחלק הראשון.
סיכום הנושא
התחלנו מהשאלה למה LLM צריך ידע חיצוני, ומה-pipeline הנאיבי: chunk, embed, top-k, prompt. משם עברנו חוליה אחר חוליה. בשלב ה-indexing: parsing שמשמר מבנה, metadata והרשאות, sync אינקרמנטלי שמטפל בעדכונים ובמחיקות, chunking שמאזן בין חדות להקשר (כולל contextual retrieval), ובחירת מודל embedding ותכנון אינדקס שמחזיק מעמד גם כשמחליפים מודל.
בשלב ה-query: hybrid retrieval עם BM25 ו-RRF, סינון נכון ו-MMR, טרנספורמציות שמתקנות את השאלה לפני החיפוש, reranking שמפריד בין recall ל-precision, והרכבת פרומפט שמנהלת תקציב, מסדרת קטעים, מצטטת, מאמתת ציטוטים ויודעת לסרב. אחר כך יצאנו מהמבנה הלינארי אל agentic RAG, CRAG, GraphRAG ו-multimodal RAG, עם הכלל להתחיל מהפשוט.
והפרק הזה סוגר את המעגל: בלי מדידה, כל אחת מההחלטות האלה היא ניחוש. מערכת RAG טובה היא לא זו שמשתמשת בכל הטכניקות, אלא זו שבה כל טכניקה נוספה כי eval הראה שהיא נחוצה, שהרשאות נאכפות לפני שהמודל רואה טקסט, ושכל תשובה ניתנת למעקב חזרה למקור שלה.