Embeddings — ייצוג משמעות כווקטורים
מהו Embedding?
Embedding הוא ייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן — מילה, משפט, פסקה, תמונה או אפילו קטע קול — שנוצר כך שמרחק בין וקטורים משקף קרבה במשמעות: תכנים בעלי משמעות דומה מקבלים וקטורים קרובים זה לזה במרחב, ותכנים שונים לחלוטין מקבלים וקטורים רחוקים.
זו אותה אינטואיציה שכבר פגשנו בנושא ה-LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI. כשדיברנו על embeddings של טוקניםהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM. בתוך המודל ("מלכה ≈ מלך − גבר + אישה") — ההבדל המרכזי כאן הוא שבחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. לא מעניין אותנו הוקטור הפנימי שמשתנה בכל שכבה בתוך רשת נוירונים, אלא וקטור יחיד, סופי וקבוע לכל מסמך או פסקה שלמה, שנשמר ומשמש להשוואה מול שאילתות עתידיות.
איך יוצרים embedding מתוכן
היצירה נעשית ע"י מודל embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. ייעודי — רשת נוירונים שאומנה במיוחד כך שהמרחק הגיאומטרי בין הוקטורים שהיא מפיקה ישקף דמיון סמנטי אמיתי, ולא ע"י מודל שפה כללי שתפקידו לייצר טקסט. ברמת העיקרון: הטקסט (או התמונה) עובר במודל בקריאה אחת, וכפלט מתקבל וקטור בודד באורך קבוע שמסכם את כל התוכן.
בפועל, ברוב המערכות לא ממירים מסמכים שלמים לוקטור בודד — מפצלים אותם לקטעים (chunks) בגודל סביר (למשל כמה משפטים או פסקה), ויוצרים embedding לכל קטע בנפרד. כך שומרים על דיוק: קטע קצר וממוקד מפיק וקטור שמייצג נאמנה את התוכן שלו, בעוד וקטור יחיד למסמך שלם עלול "לטשטש" נושאים שונים שמופיעים בו לכדי ממוצע לא מדויק.
ממדי הוקטורים הנפוצים נעים בטווח של כמה מאות ועד כמה אלפי מימדים לכל embedding — המספר המדויק תלוי במודל הספציפי, ומהווה טרייד-אוף בין דיוק הייצוג לבין עלות האחסון והחישוב.
מודלי embedding פופולריים
מודלי embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. מגיעים בשתי צורות: שירותי API של ספקים, שבהם שולחים טקסט ומקבלים וקטור, ומודלים בקוד פתוח שמריצים על שרת משלכם. הנה כמה מהמוכרים שבהם, נכון לכתיבת שורות אלו:
OpenAI — text-embedding-3-small ו-text-embedding-3-large. נקודת פתיחה נפוצה מאוד: זולים ופשוטים לשימוש. ה-small מפיק 1,536 ממדים וה-large 3,072, ובשניהם אפשר לבקש וקטור קצר יותר כדי לחסוך באחסון.
Google — gemini-embedding-001. מודל רב-לשוני חזק שמדורג גבוה בבנצ'מרקיםמבחן סטנדרטי שמודד יכולת מסוימת של LLM, כמו MMLU לידע כללי או SWE-bench לכתיבת קוד. מתוך LLM, איך בונים, מאמנים ומודדים LLM., עם 3,072 ממדים שאפשר לקצר ל-1,536 או ל-768.
Cohere — embed-v4.0. תומך ביותר מ-100 שפות ומקבל גם תמונות ומסמכים שמשלבים טקסט ותמונות, כך שאפשר לחפש בטקסט בתוך מצגות או קבצי PDF סרוקים.
Voyage AI — משפחת voyage (למשל voyage-3-large). מתמחה באיכות אחזור, ומציעה גם מודלים ייעודיים לתחומים מסוימים, כמו voyage-code-3 לקוד ו-voyage-law-2 למסמכים משפטיים.
קוד פתוח — Qwen3-Embedding של Alibaba (בגדלים 0.6B, 4B ו-8B) מוביל כיום בבנצ'מרקים הרב-לשוניים בין המודלים הפתוחים. BGE-M3 של BAAI ו-multilingual-e5-large של Microsoft הם מודלים ותיקים, קטנים יותר ורב-לשוניים. היתרון של מודל פתוח: הנתונים לא יוצאים מהשרת שלכם, ואין תשלום לפי טוקןהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM..
איך בוחרים? שלושה דברים חשובים במיוחד: תמיכה טובה בעברית (כל המודלים ברשימה רב-לשוניים, אבל האיכות משתנה ביניהם), עלות האחסון שנגזרת ממספר הממדים, והאם מותר לשלוח את הנתונים לספק חיצוני. התחום זז מהר, ולכן כדאי לבדוק את דירוג המודלים העדכני ב-MTEB Leaderboard, ובעיקר להריץ השוואה קצרה על שאילתות אמיתיות מהדאטה שלכם. כך מודדים בפועל, ועל זה נדבר בפרק על הערכת ביצועים.
דוגמאות: מטקסט לוקטור
כדי שהרעיון לא יישאר מופשט, נסתכל על חמישה משפטים קצרים ועל הוקטורים שמודל embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. עשוי להפיק עבורם. המספרים כאן להמחשה בלבד: הם לא פלט אמיתי של מודל מסוים, ומכל וקטור מוצגים רק ששת הממדים הראשונים מתוך מאות או אלפים (כפי שראינו בסעיף הקודם).
שימו לב לשני הזוגות. "איך מאפסים סיסמה?" ו-"שכחתי את הסיסמה שלי" לא חולקים כמעט אף מילה, ובכל זאת הוקטורים שלהם כמעט זהים: אותו סימן (חיובי או שלילי) בכל ממד, וערכים קרובים מאוד. כך גם "החתול ישן על הספה" ו-"הכלב נח על הכורסה": מילים שונות, אותו רעיון של חיית מחמד שנחה על רהיט, ולכן דפוס מספרים דומה.
לעומתם, "מתכון לעוגת שוקולד" לא דומה לאף אחד מהזוגות: הסימנים והגדלים שלו מתפזרים בדפוס אחר לגמרי. זה בדיוק מה שמאפשר חיפוש לפי משמעות. שאילתה כמו "לא מצליח להתחבר לחשבון" תקבל וקטור שקרוב לזוג הראשון, גם בלי מילה משותפת אחת, ותמצא אותו לפני המתכון.
חשוב לזכור: לממד בודד אין בדרך כלל משמעות שאפשר לקרוא בשמה ("ממד הסיסמאות" או "ממד החיות"). המשמעות מקודדת בדפוס של כל הממדים יחד, ואת הדמיון בין דפוסים מודדים במדדים מתמטיים שנכיר בפרק הבא.
{
  // כל וקטור: 1536 ממדים, מוצגים רק 6 הראשונים (ערכים להמחשה)
  "איך מאפסים סיסמה?":    [ 0.021, -0.047,  0.083,  0.012, -0.061,  0.035 /* … */ ],
  "שכחתי את הסיסמה שלי":  [ 0.018, -0.052,  0.079,  0.020, -0.055,  0.029 /* … */ ],

  "החתול ישן על הספה":    [-0.064,  0.031, -0.012,  0.072,  0.044, -0.026 /* … */ ],
  "הכלב נח על הכורסה":    [-0.058,  0.036, -0.019,  0.066,  0.049, -0.031 /* … */ ],

  "מתכון לעוגת שוקולד":   [ 0.052,  0.068, -0.041, -0.037,  0.014,  0.059 /* … */ ]
}
מה זה אומר ש'וקטורים קרובים' — אינטואיציה
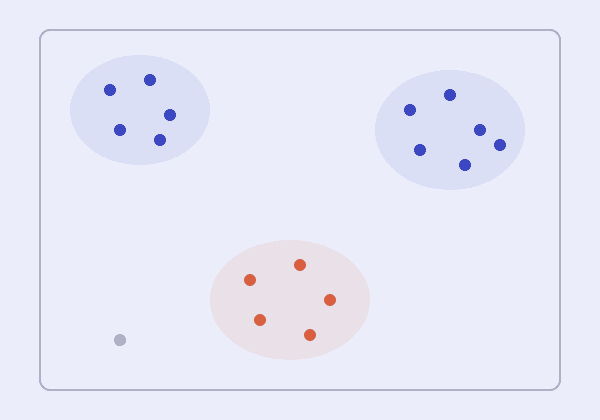
אפשר לדמיין את מרחב ה-embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. כמפה רב-ממדית שבה כל נקודה היא מסמך. מסמכים על אותו נושא מתקבצים יחד באזור אחד של המפה, בדיוק כפי שמילים בעלות משמעות דומה מתקבצות יחד במרחב ה-embeddings של מילים שנראה בנושא ה-LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI..
"קרוב" ו"רחוק" במרחב הזה נמדדים באמצעות מדדים מתמטיים מדויקים — לא רק תיאור מילולי מעורפל. איך בדיוק מגדירים ומחשבים דמיון בין שני וקטורים, ומה ההבדל בין כמה שיטות מדידה מקובלות, זו בדיוק השאלה שהפרק הבא, שעוסק במתמטיקה של חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי., עונה עליה לעומק.
שאלות נפוצות
מה קורה אם מחליפים מודל embedding אחרי שכבר אינדקסנו את כל המסמכים?
צריך ליצור מחדש את ה-embeddings של כל הקטעים. כל מודל יוצר מרחב וקטורי משלו, וגם אם הממד זהה — וקטור שאילתה מהמודל החדש לא ניתן להשוואה לוקטורים מהמודל הישן. לכן כדאי לשמור את הטקסט המקורי של כל קטע לצד הוקטור שלו, כדי שאפשר יהיה להריץ אינדוקס מחדש.
שאילתה קצרה ופסקה ארוכה — האם באמת אפשר להשוות בין ה-embeddings שלהן?
כן, כי שתיהן עוברות באותו מודל ומקבלות וקטור באותו אורך ובאותו מרחב. עם זאת, שאילתה ותשובה לרוב לא מנוסחות אותו דבר, ולכן מודלים רבים אומנו לחיפוש א-סימטרי ומבקשים לציין אם הקלט הוא שאילתה או מסמך. הדרך המדויקת לעשות זאת משתנה בין ספקים, אז כדאי לבדוק בתיעוד של המודל.
האם embeddings חושפים את הטקסט המקורי, או שאפשר לשמור אותם בלי חשש לפרטיות?
לא כדאי להניח שהם אנונימיים. מחקרים הראו שאפשר לשחזר חלקים ניכרים מהטקסט המקורי מתוך ה-embedding שלו (embedding inversion). לכן יש להגן על וקטורים באותה רמת רגישות כמו על הטקסט שממנו נוצרו.