Embeddings ואינדוקס עבור RAG
מה משתנה כשה-embedding משרת RAG
מה זה embedding ואיך טקסט הופך לוקטור כבר למדנו בנושא ה-Vector Search, בפרק 'Embeddings — ייצוג משמעות כווקטורים'. איך האינדקס מוצא שכנים קרובים ביעילות (HNSW, IVF, PQ) ואיך נראה מסד נתונים וקטורי בפועל, ראינו בפרקים 5 עד 8 שם. הפרק הזה לא חוזר על כל אלה. הוא עוסק בהחלטות שספציפיות ל-RAG.
ב-RAG, ה-embedding משרת משימה מאוד מסוימת: להתאים בין שאלה של משתמש לבין קטע מסמך שמכיל את התשובה. זו לא 'דמיון סמנטי' כללי. שאלה קצרה ('כמה ימי חופשה מגיעים לי?') ופסקה ארוכה ממדריך העובדים שעונה עליה לא דומות זו לזו בניסוח, באורך או בסגנון. המודל צריך לדעת להתאים ביניהן, והמערכת צריכה להשתמש בו נכון.
בנוסף, ב-RAG האינדקס הוא לא רק וקטורים. הוא מאגר שחייב לתמוך בסינון לפי הרשאות, בעדכון ומחיקה של מסמכים, בכמה לקוחות על אותה תשתית, ובהחלפת מודל בלי downtime. את כל זה צריך לתכנן בסכמה מראש.
בחירת מודל embedding
נקודת הפתיחה הנפוצה היא MTEB (Massive Text Embedding Benchmark) וה-leaderboard שלו. חשוב להסתכל על ציון ה-retrieval הספציפי ולא על הממוצע הכללי, שכולל גם משימות כמו clustering וסיווג. אבל benchmark ציבורי הוא רק סינון ראשוני. המודל המוביל שם לא בהכרח מוביל על המסמכים שלכם, בדומיין שלכם, בשפה שלכם. המבחן האמיתי הוא eval קטן על הדאטה שלכם: כמה עשרות עד מאות שאלות עם הקטע הנכון לכל אחת (נבנה כזה בפרק 10), ומדידת recall@k לכל מודל מועמד.
שפה היא שיקול קריטי לתוכן עברי. מודל שאומן בעיקר על אנגלית ייתן תוצאות חלשות משמעותית בעברית, גם אם הוא מוביל ב-benchmark באנגלית. צריך מודל multilingual שעברית מופיעה במפורש בשפות שלו. אם המאגר מעורב, כמו תיעוד באנגלית ושאלות בעברית, צריך לבדוק cross-lingual retrieval במיוחד. זה לא מובן מאליו אפילו במודלים רב-לשוניים.
שיקולים נוספים: מגבלת טוקנים לקלט, שצריכה להיות גדולה מגודל הקטע המקסימלי, כולל contextual header (ראו את האזהרה על חיתוך שקט בפרק הקודם). מספר ממדים, שמשפיע ישירות על אחסון ו-latency. עלות לטוקן, שמוכפלת בכל המאגר וגם בכל re-index עתידי. ומודל מתארח (API) מול מודל קוד פתוח שמריצים בעצמכם, שם הדאטה לא יוצא מהארגון. זה לפעמים הכרח רגולטורי.
Retrieval אסימטרי: שאלה מול פסקה
רוב מודלי ה-embedding שנבנו ל-retrieval אומנו בצורה אסימטרית: הם מצפים לדעת אם הקלט הוא שאילתה או מסמך. חלק מהמודלים מקבלים את זה כקידומת טקסטואלית. במשפחת E5, למשל, מוסיפים 'query: ' לשאילתות ו-'passage: ' למסמכים. APIs אחרים מקבלים פרמטר נפרד של סוג הקלט, כמו input_type עם ערך שונה לשאילתה ולמסמך. השמות המדויקים משתנים בין ספקים, ולכן צריך לבדוק בתיעוד של המודל שבחרתם.
השימוש השגוי כאן שקט לחלוטין. אם מקודדים את השאילתה כאילו היא מסמך, או משמיטים את הקידומת, הכל עובד ומחזיר תוצאות, רק פחות טובות. אין שגיאה, יש רק recall נמוך יותר שקשה לאתר. לכן מרכזים את הקריאה למודל בשתי פונקציות, embedQuery ו-embedDocuments, ולא קוראים ל-API ישירות משום מקום אחר בקוד.
אותו עיקרון אסימטרי מסביר טכניקות שנראה בפרק 6. HyDE, למשל, עוקף את הפער בין שאלה לפסקה בכך שהוא מייצר פסקה היפותטית ומבצע לה embedding במקום לשאלה.
ממדים, Matryoshka ועלות אחסון
חשבון פשוט שכדאי לעשות מראש: מיליון קטעים × 1,536 ממדים × 4 בתים (float32) הם בערך 6GB של וקטורים גולמיים, לפני התקורה של האינדקס עצמו (הגרפים של HNSW מוסיפים עוד), ולפני רפליקות. אינדקסי ANN מהירים רוצים את כל זה בזיכרון. כפלו במספר הרפליקות ובמספר הסביבות, וממדים הופכים לשורת עלות משמעותית.
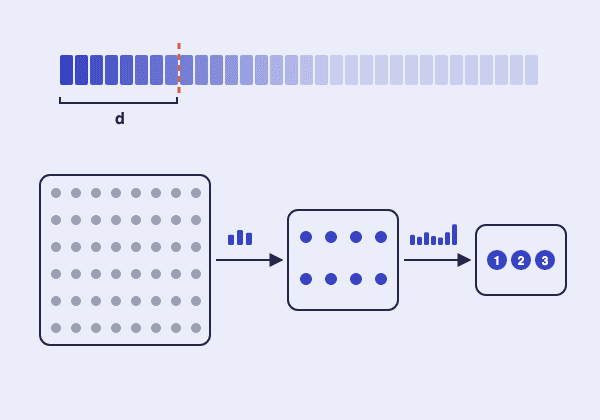
Matryoshka Representation Learning (Kusupati ועמיתיו, 2022) היא טכניקת אימון שמסדרת את המידע בוקטור לפי חשיבות: הממדים הראשונים נושאים את רוב המשמעות. במודל שאומן כך אפשר לקחת רק את d הממדים הראשונים ולקבל embedding תקין, עם ירידה מתונה באיכות. חלק מה-APIs חושפים את זה כפרמטר dimensions. חשוב: אחרי חיתוך חייבים לנרמל מחדש את הוקטור, כי האורך שלו כבר לא 1. בחיתוך של מודל שלא אומן כך, התוצאה פשוט שבורה.
זה מאפשר דפוס של שני שלבים: חיפוש ראשוני על וקטורים מקוצרים (או מקוונטזים ל-int8 או binary, כמו שראינו בפרק על קוונטיזציה בנושא ה-Vector Search) כדי לשלוף מאות מועמדים מהר וזול, ואז rescoring של המועמדים האלה עם הוקטורים המלאים. כך מקבלים את רוב הדיוק של הוקטור המלא בחלק מהזיכרון.
נרמול ומטריקת מרחק עקבית
בפרק על מתמטיקת הדמיון בנושא ה-Vector Search ראינו שעל וקטורים מנורמלים (אורך 1), cosine similarity ו-dot product נותנים בדיוק אותו דירוג, ו-L2 נותן דירוג שקול. ב-RAG הלקח המעשי הוא עקביות. משתמשים במטריקה שהמודל אומן איתה (מופיע בתיעוד שלו), מגדירים אותה באינדקס, ומנרמלים באותו מקום בקוד גם וקטורי מסמכים וגם וקטורי שאילתות.
באג קלאסי: המסמכים נורמלו בזמן האינדוקס, השאילתה לא, והאינדקס מוגדר ל-dot product. הדירוג עדיין יוצא נכון, כי כל התוצאות מוכפלות באותו אורך שאילתה, אבל הציונים המוחלטים משתנים משאילתה לשאילתה. כל סף ציון שהוגדר (פרק 5) מפסיק להיות משמעותי. ובאינדקס שמשלב וקטורים לא מנורמלים מכמה מקורות, הדירוג עצמו נשבר.
Embedding בכמויות: batching, rate limits ו-retries
אינדוקס ראשוני של מאגר גדול הוא מאות אלפי עד מיליוני קריאות embedding. שולחים בקבוצות (batch) לפי גודל ה-batch המקסימלי שה-API מקבל, מריצים כמה קבוצות במקביל עם הגבלת concurrency, ומטפלים בשגיאות 429 (rate limit) ו-5xx עם exponential backoff ו-jitter. שגיאות 4xx אחרות (קלט לא תקין) לא נפתרות עם retry, ולכן לא מנסים שוב.
אופטימיזציה שכדאי לבנות מההתחלה היא cache של embeddings לפי המפתח (embeddingModel, hash של indexText). ב-sync אינקרמנטלי (פרק 2), מסמך שהשתנה בפסקה אחת מייצר מחדש את כל הקטעים שלו, אבל רובם זהים לגרסה הקודמת. ה-cache חוסך את הקריאות האלה, וגם חוסך הרבה בניסויים עם פרמטרי retrieval שלא משנים את ה-chunking.
const EMBEDDING_MODEL = "embedding-model-v2";
const DIMENSIONS = 1024; // Matryoshka-truncated, if the model supports it
const BATCH_SIZE = 96;

export async function embedDocuments(texts: string[]): Promise<number[][]> {
  const vectors: number[][] = [];
  for (let i = 0; i < texts.length; i += BATCH_SIZE) {
    const batch = texts.slice(i, i + BATCH_SIZE);
    const result = await withRetry(() =>
      embeddingClient.embedMany({ model: EMBEDDING_MODEL, inputs: batch, inputType: "document" })
    );
    vectors.push(...result.map((v) => normalize(v.slice(0, DIMENSIONS))));
  }
  return vectors;
}

export async function embedQuery(query: string): Promise<number[]> {
  const [v] = await withRetry(() =>
    embeddingClient.embedMany({ model: EMBEDDING_MODEL, inputs: [query], inputType: "query" })
  );
  return normalize(v.slice(0, DIMENSIONS));
}

function normalize(v: number[]): number[] {
  const norm = Math.sqrt(v.reduce((sum, x) => sum + x * x, 0));
  return v.map((x) => x / norm);
}

async function withRetry<T>(fn: () => Promise<T>, maxAttempts = 5): Promise<T> {
  for (let attempt = 1; ; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt >= maxAttempts || !isRetryable(err)) throw err; // retry 429 / 5xx only
      const delayMs = 500 * 2 ** (attempt - 1) + Math.random() * 250; // backoff + jitter
      await new Promise((resolve) => setTimeout(resolve, delayMs));
    }
  }
}
תכנון סכמת האינדקס
כל רשומה באינדקס צריכה לשאת את כל מה שהשלבים הבאים צריכים, כדי שלא יהיה צורך לחזור למקור בזמן שאילתה. זה כולל שני הטקסטים מהפרק הקודם (indexText שעבר embedding, ו-text המקורי לתצוגה ולציטוט), קישור למסמך ולהורה, שדות סינון (tenant, ACL, סוג מסמך, תאריך) ושדות תפעוליים.
השדות התפעוליים הם מה שבדרך כלל נשכח. embeddingModel מתעד איזה מודל וכמה ממדים יצרו את הוקטור. chunkerVersion מתעד איזו גרסה של לוגיקת ה-chunking יצרה את הקטע. contentHash קושר את הקטע לגרסת המסמך. בלעדיהם אי אפשר לדעת, אחרי חצי שנה של שינויים, אילו רשומות צריכות אינדוקס מחדש.
שדות שמסננים לפיהם צריכים להיות מוגדרים כשדות metadata מאונדקסים (payload index או filterable attribute, לפי המערכת). אחרת סינון עלול להפוך לסריקה מלאה.
interface IndexRecord {
  id: string;               // `${docId}#${chunkIndex}`: deterministic, so re-runs overwrite
  vector: number[];
  indexText: string;        // what was embedded (contextual header + chunk)
  text: string;             // original chunk: shown to the LLM and in citations
  docId: string;
  parentId?: string;        // for small-to-big retrieval
  tenantId: string;         // filterable
  allowedGroups: string[];  // filterable: ACL copied from the document
  docType: string;          // filterable
  sectionPath: string[];
  docUpdatedAt: string;     // filterable: freshness
  contentHash: string;      // ties the chunk to a document version
  embeddingModel: string;   // e.g. "embedding-model-v2@1024"
  chunkerVersion: string;   // bump whenever chunking logic changes
}
Multi-tenancy: namespace לכל לקוח או סינון
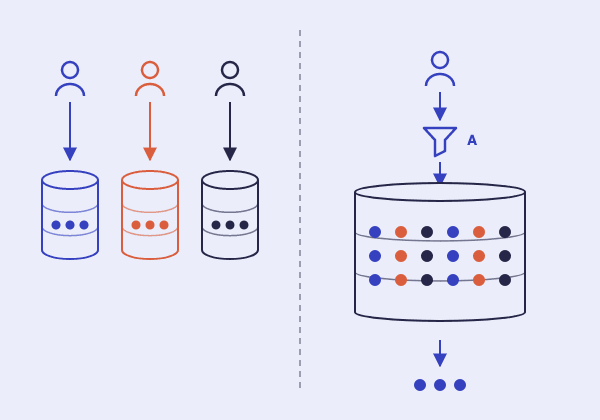
כשמערכת RAG משרתת כמה לקוחות או ארגונים, יש שתי ארכיטקטורות בסיסיות. הראשונה היא בידוד פיזי: אינדקס, collection, namespace או partition נפרד לכל tenant. השנייה היא אינדקס משותף, שבו כל רשומה נושאת tenantId וכל שאילתה מסוננת לפיו.
בידוד פיזי נותן גבול ביטחון חזק, כי שאילתה של לקוח א׳ לא יכולה לגעת בנתונים של לקוח ב׳ אפילו עם באג בסינון. הוא גם הופך מחיקה של לקוח לפעולה אחת (חשוב לבקשות מחיקה ולרגולציה), ומונע noisy neighbors. החיסרון הוא תקורה: אלפי לקוחות קטנים הם אלפי אינדקסים קטנים, וחלק מהמערכות מגבילות את מספרם או לא יעילות בו.
אינדקס משותף יעיל למספר גדול של לקוחות קטנים, אבל תלוי לחלוטין בכך שהסינון לעולם לא נשכח. יש לו גם מלכודת ביצועים שראינו בנושא ה-Vector Search: סינון סלקטיבי מאוד (לקוח קטן עם 0.01% מהרשומות) על גבי אינדקס גרפי כמו HNSW עלול לפגוע ב-recall או ב-latency, תלוי איך המערכת מממשת filtered search.
בכל ארכיטקטורה, סינון ה-tenant לא צריך להיות פרמטר שכל קורא זוכר להעביר. בונים שכבה אחת בצד השרת שמקבלת את המשתמש המאומת, גוזרת ממנו tenantId והרשאות, ומזריקה אותם לכל שאילתה. אף קוד אחר לא ניגש לאינדקס ישירות. נחזור לזה בהרחבה ב-ACL-aware retrieval בפרק 10.
אינדוקס מחדש כשמחליפים מודל
וקטורים ממודלי embedding שונים לא ניתנים להשוואה. כל מודל לומד מרחב משלו, וגם אם לשני מודלים יש אותו מספר ממדים, הממד ה-17 של אחד לא קשור לממד ה-17 של השני. אי אפשר לשאול עם מודל חדש מול אינדקס שנבנה במודל ישן, ואי אפשר לערבב את שניהם באותו אינדקס. החלפת מודל, וגם שינוי ב-chunking, פירושה אינדוקס מחדש של כל המאגר.
הדרך לעשות את זה בלי downtime ובלי סיכון היא blue/green. בונים אינדקס חדש במקביל לקיים. במהלך ה-backfill, כל עדכון מסמך נכתב לשני האינדקסים (dual-write), כדי שהחדש לא יתיישן עוד לפני שעלה. מריצים את ה-eval set על שניהם ומשווים. אם החדש טוב יותר, מחליפים alias או מצביע קונפיגורציה בפעולה אטומית אחת, כך שגם embedQuery וגם האינדקס עוברים יחד. את האינדקס הישן משאירים זמן מה כדי לאפשר rollback מיידי.
זו בדיוק הסיבה שהשדה embeddingModel נמצא בכל רשומה, ושה-cache מהסעיף הקודם ממופתח גם לפי המודל. בלעדיהם, אינדוקס מחדש חלקי שנעצר באמצע משאיר אינדקס מעורב שאי אפשר לזהות.