Query Transformation — שיפור השאילתה
למה שאילתות גולמיות נשלפות רע
כל מה שבנינו עד עכשיו מניח שהטקסט שהמשתמש הקליד הוא שאילתת חיפוש טובה. בפועל הוא לרוב לא. שאילתות קצרות מדי ('מחיר?'), עמומות ('זה עובד עם הגרסה החדשה?'), תלויות בשיחה ('ומה לגבי הצוות השני?'), מורכבות מכמה שאלות בשאלה אחת, או מנוסחות בשפה שונה מאוד מזו של המסמכים (משתמש כותב 'האפליקציה קורסת' והתיעוד כותב 'חריגה לא מטופלת').
Query transformation הוא השלב שבו LLM, בדרך כלל מודל קטן ומהיר, משכתב את השאילתה לפני ה-retrieval. זה המקום היחיד ב-pipeline שבו אפשר לתקן את הקלט, ולא רק לחפש טוב יותר את מה שקיבלנו. כל טכניקה בפרק הזה מטפלת בכשל אחר, והן לא סותרות זו את זו.
Conversational query condensation
בצ'אט, רוב השאלות אחרי הראשונה הן שאלות המשך: 'ומה לגבי מנוי שנתי?' או 'ואיך מבטלים את זה?'. חיפוש על הטקסט הזה לבדו כמעט חסר סיכוי, כי אין בו את הנושא. הוא נמצא בהודעות הקודמות.
Condensation, שנקרא גם query contextualization, שולח ל-LLM את ההיסטוריה האחרונה ואת שאלת ההמשך, ומבקש שאלה עצמאית שמכילה את כל ההקשר הנחוץ ('איך מבטלים מנוי שנתי לחבילת Pro?'). זו לרוב הטרנספורמציה הראשונה שכדאי להוסיף לכל RAG שיחתי, כי הכשל שהיא פותרת שכיח מאוד.
פרטים שחשובים: משתמשים רק בכמה הסבבים האחרונים ולא בכל השיחה. אומרים למודל במפורש לא לענות אלא רק לנסח. שומרים על שפת המשתמש, כך ששאלה בעברית נשארת בעברית, אלא אם המאגר באנגלית ויש סיבה לתרגם. ומדלגים על הקריאה בסבב הראשון, שאין בו מה לפתור.
async function condenseQuestion(history: ChatTurn[], followUp: string): Promise<string> {
  if (history.length === 0) return followUp; // first turn: nothing to resolve

  const transcript = history
    .slice(-6)
    .map((turn) => `${turn.role}: ${turn.content}`)
    .join("\n");

  return llm.generate({
    model: FAST_MODEL,
    prompt: `Rewrite the follow-up as a standalone search query.
Resolve pronouns and references using the conversation. Keep the user's language.
Do not answer the question. Output only the query.

Conversation:
${transcript}

Follow-up: ${followUp}`,
    maxTokens: 100,
  });
}
Query rewriting ו-Multi-query retrieval
Query rewriting משכתב את השאילתה כדי שתתאים יותר לשפת המסמכים: מרחיב קיצורים, מוסיף מונחים נרדפים ומונחים טכניים, ומסיר רעש ('היי, רציתי לשאול בבקשה...'). Query expansion הוא הגרסה הלקסיקלית, שמוסיפה מונחים לשאילתה עבור BM25, ובכך מפצה על החולשה שלו במילים נרדפות.
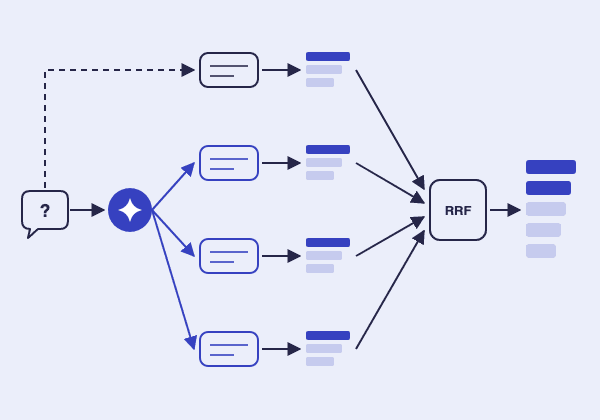
Multi-query retrieval מכיר בכך שאין ניסוח אחד מושלם. מבקשים מה-LLM לייצר N ניסוחים שונים של אותה שאלה (בדרך כלל 3 עד 5), מריצים retrieval על כל אחד במקביל, ומאחדים את הרשימות עם RRF מהפרק הקודם. קטע שעולה בכמה ניסוחים מקבל ציון גבוה, וקטע שנמצא רק בניסוח אחד עדיין נכנס לרשימה. זה משפר recall במיוחד כשהשאלה עמומה.
המחיר הוא קריאת LLM אחת ועוד N חיפושים. החיפושים רצים במקביל, כך שה-latency הנוסף הוא בעיקר קריאת ה-LLM. כדאי לכלול תמיד גם את השאלה המקורית בין הניסוחים, כדי שהטרנספורמציה לא תוכל רק להזיק.
async function multiQueryRetrieve(
  question: string,
  filter: Filter,
  n = 3,
  topK = 20
): Promise<Hit[]> {
  const { queries } = await llm.generateJson<{ queries: string[] }>({
    model: FAST_MODEL,
    prompt: `Write ${n} different search queries that would retrieve documents
answering the question below. Vary wording and terminology.
Return JSON: { "queries": string[] }.

Question: ${question}`,
  });

  const allQueries = [question, ...queries.slice(0, n)]; // always keep the original
  const rankings = await Promise.all(allQueries.map((q) => hybridSearch(q, topK, filter)));
  return reciprocalRankFusion(rankings).slice(0, topK);
}
HyDE: לחפש עם תשובה היפותטית
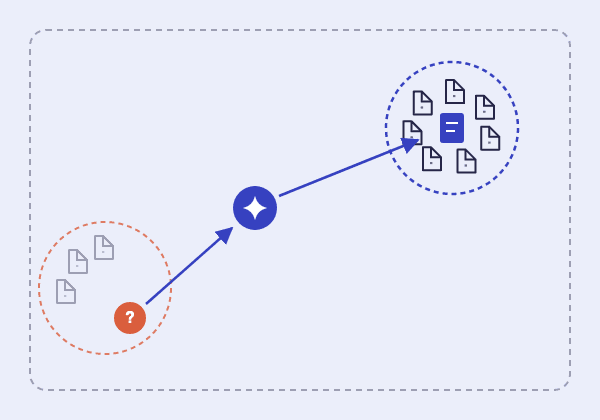
HyDE (Hypothetical Document Embeddings, Gao ועמיתיו, 2022) תוקף ישירות את הפער האסימטרי מהפרק הרביעי: שאלה ופסקה שעונה עליה לא נראות דומות. במקום לבצע embedding לשאלה, מבקשים מ-LLM לכתוב פסקה היפותטית שעונה עליה, כאילו נלקחה מהמסמכים, ומבצעים embedding לפסקה הזו. היא נמצאת 'באזור' של פסקאות אמיתיות במרחב הוקטורי, ולכן השכנים שלה הם לרוב המסמכים הנכונים.
התובנה החשובה היא שהתשובה ההיפותטית לא צריכה להיות נכונה. היא צריכה רק להיראות כמו תשובה, עם המבנה, הטרמינולוגיה והסגנון הנכונים. העובדות בה לא נכנסות לתשובה הסופית. היא משמשת רק כ'שאילתה' לחיפוש, ואת התשובה עצמה מייצרים אחר כך מהמסמכים האמיתיים שנשלפו.
הסיכונים ממשיים. אם ה-LLM לא מכיר את הדומיין בכלל, למשל מוצר פנימי, הוא יכתוב פסקה על משהו אחר וימשוך את החיפוש לכיוון שגוי. פרטים מומצאים ספציפיים כמו שמות ומספרים עלולים להתאים דווקא למסמכים הלא נכונים. וזו קריאת LLM מלאה, שמייצרת פסקה ולא רק שורה, לפני שהחיפוש בכלל מתחיל. גרסה שמרנית יותר מחפשת גם עם השאלה וגם עם ה-HyDE ומאחדת ב-RRF.
Decomposition ו-Step-back prompting
שאלה כמו 'מה ההבדל במדיניות החופשה בין העובדים בישראל לעובדים בגרמניה?' דורשת שני קטעים שונים לגמרי, ו-embedding אחד של השאלה כולה יהיה ממוצע ששני הקטעים לא דומים לו במיוחד. Query decomposition מפרק שאלה כזו לתתי-שאלות ('מדיניות החופשה בישראל', 'מדיניות החופשה בגרמניה'), שולף לכל אחת בנפרד, ומעביר את כל הקטעים לשלב ה-generation.
יש שני סוגים של פירוק. כשתתי-השאלות בלתי תלויות, כמו בדוגמה, מריצים אותן במקביל. כשהן תלויות ('מי המנהל של הצוות שאחראי על שירות התשלומים, ומה הטלפון שלו?'), התשובה לשאלה הראשונה נדרשת כדי לנסח את השנייה. זה כבר multi-hop retrieval, שדורש לולאה ולא רק פירוק מראש. נראה אותו ב-Agentic RAG בפרק 9.
Step-back prompting (Zheng ועמיתיו מ-Google DeepMind, 2023) הולך בכיוון ההפוך: במקום לפרק לפרטים, מנסחים שאלה כללית יותר. לשאלה 'למה ה-build נכשל עם שגיאה X אחרי שדרוג ל-Node 22?' מוסיפים את שאלת ה'צעד אחורה' 'מה השתנה בין Node 20 ל-Node 22?'. מבצעים retrieval על שתיהן, והקטעים הכלליים נותנים ל-LLM את העקרונות שדרושים כדי להסיק את התשובה הספציפית.
Routing ו-Self-query
לא כל שאלה צריכה להגיע לאותו אינדקס. 'כמה הזמנות היו בחודש שעבר?' היא שאלה ל-SQL ולא לחיפוש סמנטי. שאלה על התיעוד הטכני צריכה אינדקס אחר משאלה על מדיניות HR. ויש שאלות ('תודה!') שלא צריכות retrieval בכלל. Query routing מסווג את השאלה לפני ה-retrieval ומפנה אותה למקור המתאים. אפשר לעשות את זה עם LLM שמחזיר structured output (enum של יעדים), או בזול יותר, עם דמיון embedding בין השאלה לתיאור של כל יעד.
Self-query פותר בעיה אחרת: שאלות שמכילות סינונים בשפה טבעית. ב'מה מדיניות ההחזרים שפורסמה ב-2024 ללקוחות עסקיים?', 'ב-2024' ו'לקוחות עסקיים' הם תנאים על metadata, לא טקסט לחיפוש סמנטי. LLM מקבל את סכמת ה-metadata הזמינה (שדות, סוגים וערכים מותרים) ומפרק את השאלה לשאילתה סמנטית ('מדיניות החזרים') ולסינון מובנה (year = 2024, customerType = business).
כלל אבטחה שלא מתפשרים עליו: סינונים שה-LLM מייצר מוסיפים צמצום, ולעולם לא מחליפים את סינוני האבטחה. tenantId והרשאות מגיעים תמיד מהמשתמש המאומת בצד השרת (פרק 4), ומשולבים עם AND לכל סינון שה-LLM הציע. בנוסף, מוודאים שהסינון שהמודל החזיר תקין מול הסכמה לפני שמריצים אותו. שם שדה לא קיים או ערך מחוץ לטווח צריכים לגרום להתעלמות מהסינון, לא לשאילתה שבורה.
המחיר: latency, עלות ומתי לא לשכתב
כל טרנספורמציה היא קריאת LLM נוספת לפני שה-retrieval בכלל מתחיל, והיא נמצאת על הנתיב הקריטי של זמן התגובה. כמה טכניקות ברצף (condensation, ואז multi-query, ואז HyDE) יכולות להוסיף שניות. זה מורגש מאוד בממשק צ'אט, גם עם streaming, כי התשובה לא מתחילה לזרום עד שה-retrieval מסתיים.
דרכים לצמצם: להשתמש במודל קטן ומהיר לטרנספורמציות, שהן משימות פשוטות שלא צריכות את המודל החזק ביותר. להריץ במקביל כל מה שלא תלוי זה בזה. לשלב כמה טרנספורמציות בקריאה אחת עם structured output (condensation, routing ו-self-query באותה קריאה). ולשמור cache לשאלות חוזרות.
והכי חשוב: לא להוסיף טרנספורמציה כי היא קיימת. כל אחת פותרת כשל מסוים, ויכולה גם להזיק. rewriting יכול לאבד את הכוונה המקורית, ו-HyDE יכול להטות את החיפוש. מוסיפים אותה רק כשה-eval set מראה שהכשל הזה קיים אצלכם ושהטרנספורמציה משפרת את המדדים. נבנה את הכלים לזה בפרק 10.