איך בונים, מאמנים ומודדים LLM
מהו LLM ואיך הוא "חושב"?
LLM הוא רשת נוירונים שלומדת להבין ולייצר טקסט: הקלט שלו הוא רצף טוקנים — יחידות טקסט קטנות שהטקסט מפורק אליהן בתהליך שנקרא טוקניזציה (tokenization) — והפלט שלו הוא תמיד אותו דבר: חיזוי הטוקן הבא ברצף.
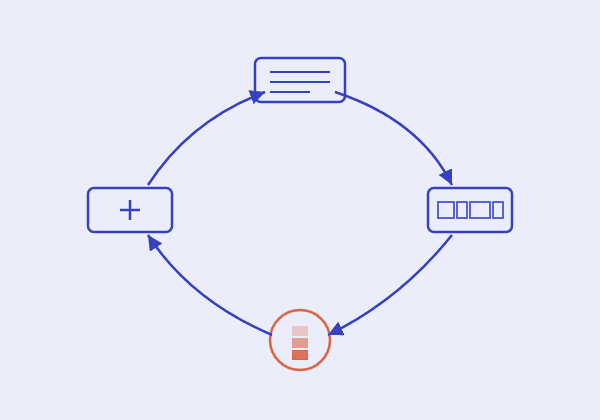
כדי לייצר טקסט שלם, המודל חוזר על מעגל פשוט שוב ושוב: מקבל טקסט קלט, מפרק אותו לטוקנים, מנתח את ההקשר, מנבא את הטוקן הבא, ומוסיף אותו לרצף — ואז חוזר על התהליך מההתחלה עם הרצף המעודכן.
דוגמאות מוכרות למודלים כאלה: GPT, Claude, Gemini, Llama.
טוקניזציה: מה זה בעצם טוקן?
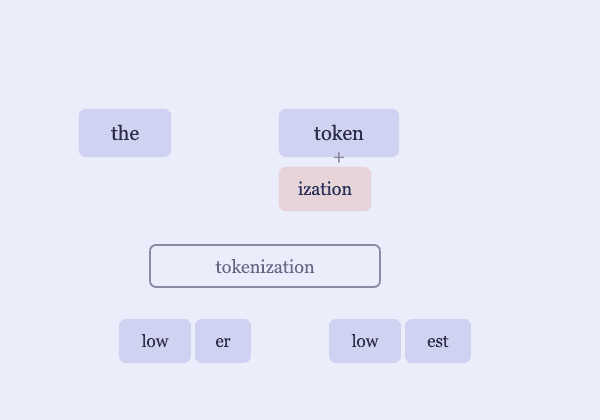
טוקן הוא לא בהכרח מילה שלמה: הוא היחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל — יכולה להיות מילה שלמה נפוצה ("the"), חלק ממילה ארוכה או נדירה ("token" + "ization"), תו בודד, סימן פיסוק או אפילו רווח. אילו חלקי טקסט הופכים לטוקן משלהם נקבע מראש, בתהליך אימון נפרד של ה-tokenizer, על סמך התדירות שלהם בקורפוס האימון.
הסיבה שלא פשוט מפרקים לפי מילים שלמות: מילון של כל המילים האפשריות בשפה (ובוודאי בכמה שפות יחד) יהיה ענק, ובכל זאת תמיד תיתקלו במילה חדשה, שם פרטי או שגיאת כתיב שלא הופיעו באימון. טוקניזציה מבוססת תת-מילים (subword tokenization) פותרת את זה: מילה לא מוכרת פשוט מתפרקת לחלקים קטנים ומוכרים יותר, במקום להיתקע על טוקן "לא ידוע" שמאבד מידע.
האלגוריתם: Byte Pair Encoding (BPE)
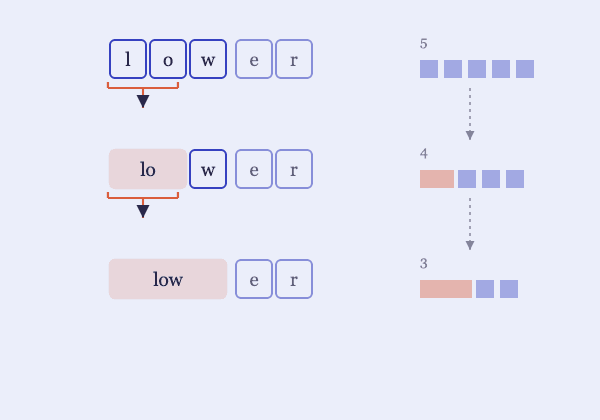
רוב ה-tokenizers המודרניים (כולל אלו של משפחת GPT) בנויים על אלגוריתם בשם Byte Pair Encoding (BPE): מתחילים מאוצר מילים של תווים בודדים (או בייטים, בגרסת byte-level BPE), עוברים על כל הקורפוס וסופרים אילו זוגות תווים סמוכים מופיעים הכי הרבה, וממזגים את הזוג הנפוץ ביותר לטוקן חדש אחד. התהליך חוזר על עצמו שוב ושוב — בכל סיבוב נוצר טוקן חדש אחד — עד שמגיעים לגודל אוצר מילים יעד (למשל כמה עשרות אלפי טוקנים).
לדוגמה: אם הקורפוס מכיל הרבה מופעים של המילים "low", "lower" ו-"lowest", זוג התווים l ו-o יופיע כה הרבה פעמים שהוא ימוזג ראשון לטוקן "lo"; בסיבוב הבא "lo" ו-"w" ימוזגו ל-"low"; וכן הלאה, עד שנוצר טוקן שלם ל-"low" עצמה, בעוד הסיומות "er" ו-"est" נשארות טוקנים נפרדים וקטנים יותר כי הן משותפות למילים רבות אחרות. תוצאת האימון היא רשימת חוקי מיזוג קבועה — וכשה-tokenizer פוגש טקסט חדש, הוא פשוט מיישם את אותם חוקים בסדר שנקבע, בלי לספור מחדש.
נקודה חשובה במיוחד לדוברי עברית: רוב ה-tokenizers אומנו על קורפוסים שרובם באנגלית, ולכן מילים אנגליות נפוצות מקבלות לרוב טוקן שלם אחד, בעוד מילה בעברית מתפרקת פעמים רבות לכמה טוקנים קטנים יותר (לעיתים אפילו ברמת אות בודדת) — כלומר אותו משפט בעברית "עולה" יותר טוקנים מתרגומו לאנגלית. זו הסיבה המעשית לכך שהעלות וניצול ה-context window עבור טקסט בעברית (וכל שפה שאינה אנגלית) גבוהים יותר יחסית, כפי שצוין כבר בפרק הראשון.
ארכיטקטורת Transformer ומנגנון ה-Attention
כמעט כל ה-LLMs המובילים כיום מבוססים על ארכיטקטורת Transformer, שהוצגה ב-2017. היא בנויה משכבות (layers) חוזרות, שכל אחת מעדנת עוד קצת את ההבנה של הטקסט — ככל שיש יותר שכבות, המודל "עמוק" יותר ומסוגל ללכוד דפוסי שפה מורכבים יותר. הארכיטקטורה גם מאפשרת עיבוד מקבילי, מה שהופך את האימון לישים על חומרה חזקה.
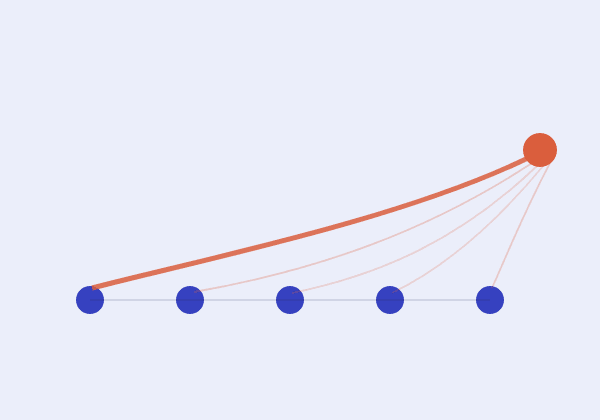
הרעיון המרכזי שמניע אותה הוא מנגנון תשומת לב, Attention: עבור כל טוקן, המודל "מסתכל" על כל שאר המילים בהקשר ומחשב כמה כל אחת מהן רלוונטית להבנתו — באמצעות שלושה וקטורים לכל טוקן: Query (מה אני מחפש), Key (מה יש לי להציע) ו-Value (התוכן בפועל).
Multi-head attention מריץ כמה "ראשי" תשומת לב כאלה במקביל, כל אחד לומד סוג קשר שונה. זה הבסיס ליכולת של LLM להבין הקשר ארוך טווח: במשפט כמו "הכלב רדף אחרי החתול כי הוא היה רעב", Attention הוא מה שעוזר למודל להבין למי בדיוק המילה "הוא" מתייחסת.
פרמטרים: מהם ולמה הם חשובים
פרמטרים הם המשקלים (weights) המספריים ברשת הנוירונים — המספרים שנקבעים ומתעדכנים במהלך האימון, ומיוצגים ע"י כל חיבור בין נוירונים ברשת. כשאומרים "מודל בן 70 מיליארד פרמטרים", הכוונה היא שלרשת יש 70 מיליארד מספרים כאלה שנלמדו מהדאטה.
הפרמטרים מאורגנים במטריצות שמוכפלות בווקטורי הקלט בכל שכבה. ככל שיש יותר פרמטרים, יש למודל יותר "קיבולת ייצוגית" — יכולת לייצג דפוסי שפה מורכבים יותר.
מספר הפרמטרים הכולל הוא פונקציה גם של מספר השכבות וגם של הרוחב של כל שכבה, כך שאפשר להגיע לאותו מספר פרמטרים במודל "צר ועמוק" (הרבה שכבות קטנות) או "רחב ורדוד" (מעט שכבות גדולות). בפועל, עומק נוטה לשפר הסקה מורכבת ורב-שלבית, ורוחב נוטה לשפר קיבולת ידע וזיכרון — אך זה איזון שתלוי גם בארכיטקטורה הספציפית.
וקטורים (Embeddings) ומרחב המשמעות
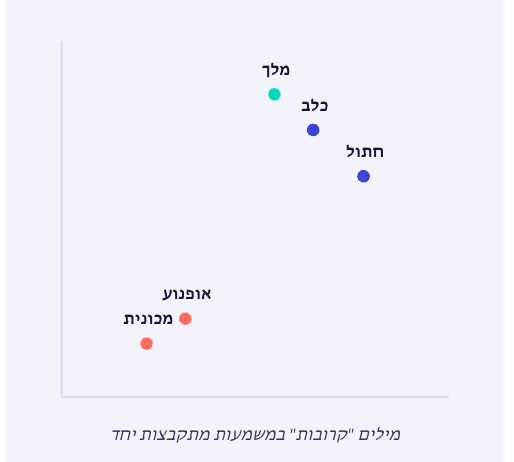
לפני שהמודל "חושב" על מילה, הוא ממיר כל טוקן לוקטור (embedding) — רשימת מספרים במרחב רב-ממדי (למשל 4,096 מימדים) שמייצגת את ה"משמעות" של המילה במרחב מתמטי. מילים בעלות משמעות דומה ממוקמות קרוב זו לזו במרחב הזה, והוקטורים עצמם מתעדכנים בכל שכבה בהתאם להקשר המשפט.
דוגמה קלאסית להמחשת הרעיון: מלכה ≈ מלך − גבר + אישה. אם לוקחים את הוקטור של "מלך", מחסירים את הכיוון של "גבר" ומוסיפים את הכיוון של "אישה" — מגיעים למקום קרוב לוקטור של "מלכה" במרחב. (הדוגמה מפושטת להמחשה בלבד — וקטור embedding אמיתי מכיל אלפי מימדים ללא משמעות מילולית ישירה לכל מימד.)
הפרמטרים הם מה שלומד ליצור, לעדכן ולתמרן את הוקטורים האלה בכל שכבה: אפשר לחשוב על הוקטורים כ"מידע שזז" במרחב, והפרמטרים הם "הכוח שמזיז אותו".
איך מודל לומד: Pretraining, Fine-tuning ו-RLHF
השלב הראשון הוא Pretraining: אימון על קורפוס טקסט עצום — טריליוני מילים מהאינטרנט, ספרים, קוד ועוד. משימת האימון היא ניבוי הטוקן הבא (self-supervised learning), כך שלא נדרש תיוג ידני של הדאטה. המודל מנחש טוקן, משווה לתשובה האמיתית, מחשב "טעות" (loss), ומעדכן את הפרמטרים בהדרגה באמצעות Backpropagation ו-Gradient Descent — תהליך שחוזר על עצמו מיליארדי פעמים.
אחרי ה-Pretraining המודל "יודע שפה" אך לא בהכרח מתנהג כרצוי, ולכן יש שלב יישור (Alignment): Fine-tuning על דוגמאות ממוקדות (הוראות, שיחות, משימות ספציפיות), ולאחריו RLHF (Reinforcement Learning from Human Feedback), שבו המודל לומד להעדיף תשובות שמדרגי אדם מעריכים כטובות יותר — או DPO (Direct Preference Optimization), שיטה חלופה יעילה יותר ללא צורך במודל תגמול נפרד. המטרה: מודל מועיל, בטוח ונאמן לכוונת המשתמש.
דאטהסט וחוקי הסקיילינג (Scaling Laws)
מודלים מודרניים מאומנים על טריליוני טוקנים ממקורות מגוונים — ספרים, קוד, מאמרים מדעיים, שיחות. איכות הדאטה חשובה יותר מהכמות: דאטה מסונן ונקי מניב תוצאות טובות יותר מדאטה גולמי גדול יותר. סיכון נוסף הוא זיהום דאטה (data contamination) — כאשר שאלות ממבחני benchmark מוצאות את דרכן לתוך דאטת האימון, מה שמטה את התוצאות כלפי מעלה. ככל שדאטה אנושי איכותי הופך נדיר יותר, דאטה סינתטי (שנוצר ע"י מודלים אחרים) הופך חשוב יותר.
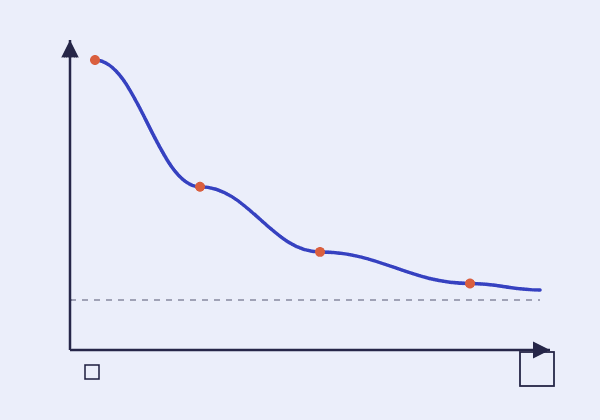
חוקי הסקיילינג מתארים קשר צפוי בין גודל המודל, גודל הדאטה וכוח החישוב לבין הביצועים: טעות האימון יורדת בצורה צפויה (power law) ככל שמגדילים את שלושתם יחד, ויש יחס אופטימלי בין מספר הפרמטרים לכמות הדאטה (למשל גישת Chinchilla). כיום האימון מוגבל יותר בזמינות דאטה איכותי ובכוח חישוב מאשר בארכיטקטורה עצמה, וכיוונים חדשים כמו הרחבת חישוב בזמן ההסקה (inference-time scaling) ודאטה סינתטי הופכים משמעותיים יותר ויותר.
איך מודדים "חוזק" של LLM: Benchmarks
MMLU — ידע כללי רחב במגוון תחומים, בשאלות רב-ברירה.
HumanEval / SWE-bench — יכולת כתיבת קוד ופתרון בעיות תכנות אמיתיות.
GSM8K / AIME — יכולת חשיבה מתמטית ופתרון בעיות בדרגות קושי שונות.
GPQA Diamond — שאלות מדעיות ברמת דוקטורט, קשות לפתרון בגוגל.
ARC-AGI — הסקה מופשטת (abstract reasoning) ופתרון חידות חדשות.
Humanity's Last Exam — מבחן שאלות מומחים קשות ביותר; נכון להיום אף מודל לא עובר 51%.
חלק מהבנצ'מרקים הוותיקים כבר רוויים אצל המודלים המובילים — MMLU מעל 88%, GSM8K כ-99%, HumanEval רווי כמעט לגמרי — ולכן הבנצ'מרקים שבאמת מבחינים בין מודלים מובילים היום הם הקשים יותר: GPQA Diamond, SWE-bench, AIME ו-ARC-AGI 2.
מעבר לבנצ'מרקים: הערכה אנושית ו-Perplexity
Perplexity הוא מדד סטטיסטי אוטומטי — עד כמה המודל "מופתע" מהטקסט האמיתי; ככל שהוא נמוך יותר, המודל טוב יותר בחיזוי שפה. יתרונו הוא שאינו דורש בני אדם, ולכן נוח למעקב שוטף אחר התקדמות אימון.
הערכה אנושית (Human evaluation) עובדת אחרת: אנשים משווים תשובות של מודלים שונים ומצביעים על התשובה המועדפת. השוואות בסגנון "זירה" (Arena-style), כמו LMSYS Chatbot Arena, מדרגות מודלים לפי Elo המבוסס על השוואות עיוורות — משקפות טוב יותר את איכות השיחה בפועל, אך יקרות ואיטיות לאיסוף.
בנצ'מרקים אוטומטיים בלבד לא תמיד משקפים חוויית משתמש אמיתית, ולכן נדרש שילוב של כמה מדדים יחד — ומכיוון שבנצ'מרקים ישנים נוטים "להירוות" עם הזמן, יש צורך מתמיד בפיתוח מבחנים חדשים וקשים יותר.
גורמים נוספים וטרייד-אופים בבניית LLM
מעבר לגודל, כמה גורמים נוספים משפיעים על איכות המודל בפועל: חלון ההקשר (כמה טקסט הוא יכול "לזכור" ולעבד בו-זמנית), איכות היישור (עד כמה הוא עוקב אחר הוראות בבטחה ובדיוק), שיטת האימון שנבחרה (RLHF מול DPO, למשל, משפיעה ישירות על טון ואמינות), Fine-tuning ייעודי לתחום ספציפי (רפואה, קוד וכד'), ו-Quantization — דחיסת המשקלים (למשל מ-16 ל-4 סיביות) לחיסכון בזיכרון וחישוב, במחיר ירידה קלה באיכות.
יותר פרמטרים לא תמיד אומר מודל טוב יותר: מודל גדול שאומן על דאטה גרוע יכול להיות נחות ממודל קטן שאומן היטב. מודלים גדולים יותר מציעים יכולת ייצוגית ואיכות גבוהה יותר במשימות מורכבות, אך עלות ההרצה והאימון שלהם גבוהה והם איטיים יותר להגיב; מודלים קטנים ויעילים יותר זולים ומהירים, מתאימים למשימות ממוקדות ואף יכולים לרוץ על מכשירי קצה — אך עלולים לפספס משימות מורכבות. Mixture-of-Experts (MoE) הוא כיוון ארכיטקטוני שמפעיל רק חלק מהפרמטרים בכל פעם, ומאזן בין קיבולת ליעילות. הבחירה הנכונה תלויה במשימה — לא תמיד צריך את המודל הכי גדול.
סיכום: מה קובע את איכות ה-LLM?
מספר הפרמטרים קובע את הקיבולת הייצוגית ואת היכולת ללמוד דפוסים מורכבים; איכות וגודל הדאטהסט קובעים את בסיס הידע, ההכללה והדיוק העובדתי; הארכיטקטורה (Transformer) קובעת את יעילות העיבוד ואת אורך ויכולת ההבנה של ההקשר; תהליך האימון — Pretrain ← Fine-tune ← RLHF — קובע את ההתנהגות, הבטיחות והיישור לכוונת המשתמש; ובנצ'מרקים יחד עם הערכה אנושית הם מה שמאפשר למדוד את כל זה בפועל מול משימות אמיתיות.
איכות מודל שפה היא תוצאה של שילוב בין כל הגורמים האלה — לא של גורם בודד.