ארכיטקטורות RAG מתקדמות
Naive, Advanced ו-Modular RAG
בסקירות מחקר על RAG השתרשה חלוקה לשלושה שלבי התפתחות, והיא שימושית גם כמפה מעשית. Naive RAG הוא ה-pipeline מהפרק הראשון: chunk, embed, top-k, prompt. Advanced RAG משאיר את אותו מבנה לינארי, אבל משפר כל חוליה. זה כל מה שעשינו בפרקים 2 עד 8: parsing טוב יותר, chunking חכם, hybrid retrieval, טרנספורמציות שאילתה, reranking וניהול קונטקסט.
Modular RAG שובר את הלינאריות. במקום שרשרת קבועה, יש רכיבים (retrievers, rerankers, routers, graders, generators) שמורכבים בזרימות שונות, כולל תנאים, לולאות ומסלולים חלופיים: 'אם הקטעים לא רלוונטיים, שכתב וחפש שוב', 'אם זו שאלה גלובלית, לך לאינדקס הגרף'. כל הארכיטקטורות בפרק הזה הן זרימות כאלה.
ההבחנה הזו היא בדיוק ההבחנה בין workflow ל-agent שלמדנו בנושא AI Agents, בפרק 'Workflows מול Agents'. זרימה שהקוד קובע מראש, גם אם יש בה תנאים, היא workflow. זרימה שבה המודל מחליט בכל צעד מה לעשות היא agent. אותם שיקולים של צפיות, עלות ו-latency חלים גם כאן.
Agentic RAG: retrieval ככלי
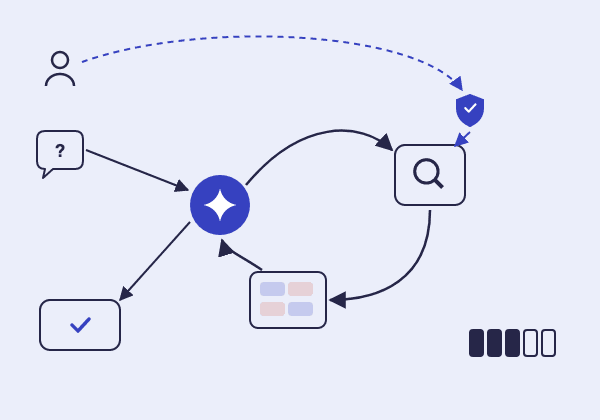
ב-Agentic RAG, ה-retrieval מפסיק להיות שלב קבוע לפני ה-LLM ונהיה כלי שה-LLM מפעיל בעצמו. את הלולאה האגנטית ואת מנגנון ה-tool calling כבר ראינו בנושא AI Agents (בפרקים על הלולאה האגנטית ועל Tools ו-MCP), ולא נחזור עליהם. מה שחדש כאן הוא מה שהם מאפשרים ל-RAG.
הסוכן מחליט אם לחפש בכלל ('תודה' לא דורש חיפוש), ומנסח את השאילתה בעצמו. זה בעצם query transformation מובנה, כי המודל כותב שאילתה עצמאית מתוך הקשר השיחה. הוא רואה את התוצאות ומחליט אם הן מספיקות, ואם לא, מחפש שוב בניסוח אחר. הוא יכול גם לבחור בין כמה כלים: חיפוש בתיעוד, שאילתת SQL לנתונים מספריים, חיפוש ב-web למידע ציבורי עדכני.
המחיר ידוע מנושא ה-Agents. מספר הסבבים לא צפוי, ולכן גם ה-latency והעלות. צריך מגבלת צעדים קשיחה. וכל כשל בתיאור הכלי (מתי להשתמש בו, מה הוא מחזיר) משפיע ישירות על ההתנהגות, כמו שלמדנו בפרק על תכנון כלים טובים. בקוד שלמטה שימו לב לפרט אבטחה אחד: המודל יכול להציע סינון לפי סוג מסמך, אבל סינון ההרשאות נגזר תמיד מהמשתמש המאומת, ולכן המודל לא יכול לדרוס אותו.
const searchDocsTool = {
  name: "search_docs",
  description:
    "Search the internal knowledge base (product docs, policies, procedures). " +
    "Returns up to 8 passages, each with a source id like S3. " +
    "If the results do not answer the question, call again with a different query.",
  inputSchema: {
    type: "object",
    properties: {
      query: { type: "string", description: "Standalone search query" },
      docType: { type: "string", enum: ["policy", "product", "engineering"] },
    },
    required: ["query"],
  },
};

async function agenticAnswer(question: string, user: AuthUser): Promise<string> {
  const messages: Message[] = [{ role: "user", content: question }];
  const retrieved = new Map<string, ContextChunk>(); // all chunks seen, for citation checks

  for (let step = 0; step < MAX_STEPS; step++) {
    const response = await llm.chat({ system: AGENT_PROMPT, messages, tools: [searchDocsTool] });
    messages.push(response.message);
    if (response.toolCalls.length === 0) return response.text; // final answer

    for (const call of response.toolCalls) {
      const filter = {
        ...(call.input.docType ? { docType: call.input.docType } : {}),
        ...(await securityFilter(user)), // spread last: the model can never override it
      };
      const hits = await retrieveAndRerank(call.input.query, filter);
      const chunks = hits.map((hit) => toContextChunk(hit, retrieved)); // stable S-ids
      messages.push({ role: "tool", toolCallId: call.id, content: formatSources(chunks) });
    }
  }
  return "I could not find a complete answer within the search limit.";
}
Multi-hop: כשתשובה אחת תלויה בקודמת
שאלת multi-hop היא שאלה שהתשובה עליה דורשת שרשרת של שליפות, כשכל שליפה תלויה בתוצאה של הקודמת. 'מה מספר הטלפון של המנהל של הצוות שאחראי על שירות התשלומים?' דורשת שלושה צעדים: מי הצוות האחראי על שירות התשלומים, מי המנהל של הצוות הזה, ומה מספר הטלפון שלו. אי אפשר לנסח את השאילתה השנייה לפני שיש תשובה לראשונה.
זו הסיבה ש-query decomposition מראש (פרק 6) לא מספיק כאן. הפירוק לא ידוע עד שמתחילים. Pipeline לינארי נכשל בשאלות כאלה בשקט: הוא שולף קטעים על 'שירות תשלומים' ו'טלפון', ומקבל משהו שנראה קרוב. הפתרון הוא iterative retrieval, לולאה שבה המודל מחפש, קורא, מנסח את השאילתה הבאה לפי מה שמצא, וממשיך עד שיש לו את כל החוליות.
Agentic RAG מהסעיף הקודם מממש את זה באופן טבעי, כי הלולאה כבר שם. אם רוצים יותר שליטה, אפשר לבנות את זה כ-workflow: לולאה קבועה של 'חפש, ואז שאל את המודל אם יש מספיק מידע או מה צריך לחפש עכשיו', עם מגבלת סבבים. התוצאה צפויה יותר ועדיין מטפלת ברוב שאלות ה-multi-hop.
Self-RAG ו-Corrective RAG
שתי ארכיטקטורות מחקריות הוסיפו ל-RAG מנגנון של ביקורת עצמית, והרעיונות שלהן שימושיים גם בלי המימוש המקורי. Self-RAG (Asai ועמיתיו, 2023) מאמן את המודל לייצר טוקנים מיוחדים של 'רפלקציה' בזמן ה-generation. הטוקנים האלה מחליטים אם בכלל צריך retrieval בנקודה הזו, מעריכים אם כל קטע שנשלף רלוונטי, בודקים אם הטקסט שנוצר נתמך על ידי הקטע, ומעריכים את התועלת של התשובה. המימוש המלא דורש מודל שאומן לכך. הגרסה המעשית מחקה את זה עם קריאות LLM נפרדות שמבצעות את אותן בדיקות.
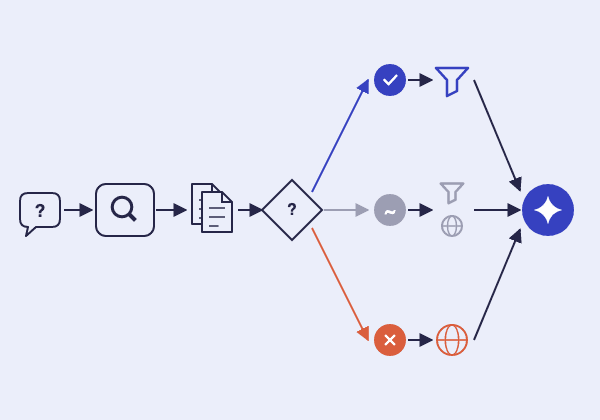
Corrective RAG, או CRAG (Yan ועמיתיו, 2024), מתמקד בשלב אחד: מה עושים כשה-retrieval נכשל. מודל הערכה קל מדרג את הקטעים שנשלפו לשלוש קטגוריות. כשהם נכונים, מזקקים אותם לחלקים הרלוונטיים. כשהם שגויים, זונחים אותם ופונים למקור חלופי (במאמר: חיפוש web). כשהם עמומים, משלבים את שני המסלולים.
הדפוס המעשי שיוצא משניהם הוא grade then fallback. אחרי ה-retrieval, בודקים אם התוצאות באמת עונות על השאלה, עם ציון reranker, עם LLM grader, או עם שניהם. אם לא, יש מסלול חלופי מוגדר: שכתוב השאילתה וחיפוש נוסף, מעבר למקור אחר, או סירוב מבוסס (פרק 8). ההבדל מ-agentic RAG הוא שהזרימה מוגדרת בקוד ולא נתונה לשיקול דעת המודל.
GraphRAG
יש סוג שאלות ש-retrieval וקטורי נכשל בו באופן מבני: שאלות גלובליות על המאגר כולו. 'מהם הנושאים המרכזיים שעולים בכל משובי הלקוחות מהרבעון האחרון?' או 'אילו צוותים תלויים זה בזה?'. אין קטע אחד שעונה על זה. התשובה מפוזרת על פני מאות מסמכים, ו-top-10 של קטעים דומים לשאלה לא מייצג אותם.
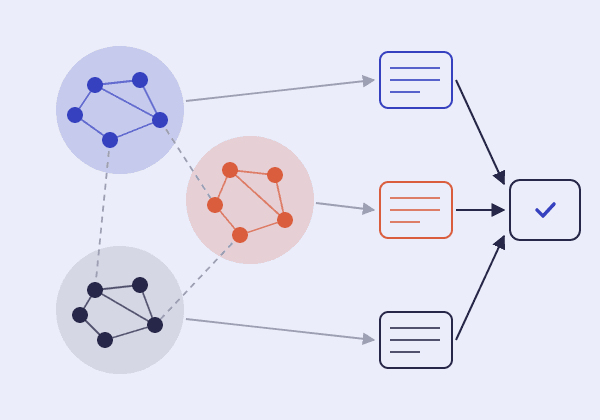
GraphRAG, בגרסה ש-Microsoft Research פרסמה ב-2024, בונה ייצוג אחר של המאגר בשלב האינדוקס. LLM עובר על כל קטע ומחלץ ממנו ישויות (אנשים, צוותים, מוצרים, מושגים) וקשרים ביניהן, והן מתאחדות לגרף ידע אחד. אלגוריתם לזיהוי קהילות (community detection) מחלק את הגרף לאשכולות היררכיים של ישויות קשורות. ה-LLM כותב סיכום לכל קהילה, בכל רמה בהיררכיה.
בזמן השאילתה יש שני מצבים. Global search עונה על שאלות גלובליות בגישת map-reduce: כל סיכום קהילה מקבל את השאלה ומייצר תשובה חלקית, והתשובות החלקיות מתאחדות לתשובה אחת. Local search מתחיל מהישויות שמוזכרות בשאלה, הולך לשכנים שלהן בגרף, ומשלב גם את הקטעים המקוריים. זה מתאים לשאלות על קשרים ולשאלות multi-hop בין ישויות.
המחיר משמעותי. האינדוקס דורש קריאות LLM על כל קטע ועל כל קהילה, וזה יקר בהרבה מ-embedding. עדכון אינקרמנטלי של גרף וסיכומי קהילות מסובך יותר מ-upsert של וקטור. ואיכות הגרף תלויה באיכות חילוץ הישויות, כולל איחוד נכון של אותה ישות שמופיעה בשמות שונים. GraphRAG הוא כלי לסוג מסוים של שאלות. הוא לא תחליף לחיפוש הרגיל, ורוב המערכות שמשתמשות בו מפעילות אותו לצד retrieval וקטורי, עם routing ביניהם.
Multimodal RAG
הרבה מהידע במסמכים ארגוניים לא נמצא בטקסט: דיאגרמות ארכיטקטורה, גרפים בדוחות, צילומי מסך בתיעוד, שקפים, טבלאות מורכבות. Pipeline טקסטואלי מתעלם מכל אלה, או מקבל מהם רעש של OCR.
יש שלוש גישות עיקריות. הראשונה והפשוטה: להמיר הכל לטקסט בשלב ה-ingestion (כמו שראינו בפרק 2). מודל vision כותב תיאור לכל תמונה ודיאגרמה, טבלאות הופכות ל-Markdown, והכל ממשיך ב-pipeline הרגיל. זה עובד טוב ולא דורש שינוי בשלבים הבאים, אבל המידע שהתיאור לא כלל אבד. השנייה: multimodal embeddings, מודלים שממפים טקסט ותמונות לאותו מרחב וקטורי, כך ששאילתה טקסטואלית יכולה למצוא תמונה ישירות.
השלישית, והחדשה ביותר: לוותר על ה-parsing ולאנדקס כל עמוד כתמונה. ColPali (Faysse ועמיתיו, 2024) מיישם את רעיון ה-late interaction של ColBERT (פרק 7) על patches של תמונת עמוד, בעזרת מודל vision-language. חיפוש טקסטואלי מוצא עמודים לפי התוכן הויזואלי שלהם, כולל פריסה, טבלאות וגרפים. בשלב ה-generation מעבירים את תמונות העמודים עצמן למודל שיודע לקרוא תמונות. זה חוסך את כל הכשלים של parsing, במחיר של אחסון ועלות גבוהים יותר.
לבחור את הארכיטקטורה הפשוטה ביותר שעובדת
הפרק הזה עלול ליצור רושם שהמערכת הטובה היא המורכבת ביותר. ההפך נכון. כל שכבה מוסיפה latency, עלות, נקודות כשל, ובעיקר חוסר צפיות. מערכת agentic שמחליטה בעצמה כמה פעמים לחפש קשה יותר לדבג, קשה יותר להעריך, ומפתיעה יותר בפרודקשן.
סדר מעשי: מתחילים ב-naive RAG עם parsing ו-chunking טובים, ובונים eval set (פרק 10). מוסיפים hybrid retrieval ו-reranking, ששניהם כמעט תמיד משתלמים. מוסיפים query transformations לפי הכשלים שה-eval מראה. עוברים ל-agentic או ל-multi-hop רק אם יש בפועל שאלות שדורשות כמה סבבים. ומוסיפים GraphRAG רק אם יש צורך אמיתי בשאלות גלובליות.
הכלל הזה זהה לזה שלמדנו בנושא AI Agents: להתחיל מהפתרון הפשוט ביותר, ולהוסיף מורכבות רק כשהיא מוכחת כנחוצה. ההבדל הוא שב-RAG יש כלי מדידה מדויקים יחסית, ולכן אין סיבה לנחש. זה נושא הפרק הבא.