בניית pipeline לחיפוש וקטורי
שלב 1: חלוקת מסמכים לקטעים (Chunking)
לפני יצירת embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים., מפצלים מסמכים ארוכים לקטעים (chunks) בגודל סביר — כמה משפטים עד פסקה. זו החלטת עיצוב מעשית ולא רק פרט טכני: קטעים גדולים מדי מייצרים embedding "מטושטש" שמנסה לייצג יותר מדי רעיונות שונים בוקטור אחד (הבעיה שהוזכרה בפרק העוסק ב-embeddings), וקטעים קטנים מדי מאבדים הקשר סביבתי חשוב שקיים במסמך המקורי.
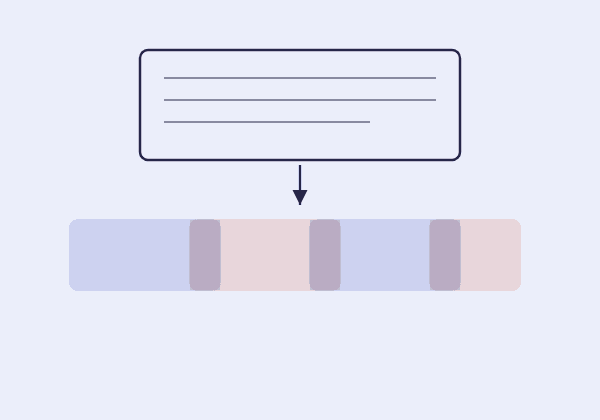
פתרון נפוץ לאיזון בין השניים הוא חפיפה (overlapכל קטע חוזר על הטוקנים האחרונים של הקטע הקודם, כדי שרעיון שנפל על קו החיתוך יופיע שלם באחד מהם. מתוך RAG, Chunking — חלוקת מסמכים לקטעים.) בין קטעים סמוכים — כל קטע חדש מתחיל קצת לפני שהקטע הקודם הסתיים, כך שמידע שנמצא בדיוק על הגבול בין שני קטעים לא הולך לאיבוד לגמרי מאף אחד מהם.
לא צריך לכתוב את אלגוריתם החלוקה בעצמכם. יש כמה שיטות מקובלות: Fixed-size (חיתוך כל N טוקניםהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM.), Recursive splittingחיתוך לפי היררכיית מפרידים מהגס לעדין (כותרת, פסקה, שורה, משפט), כך שקטע נחתך בגבול הטבעי הגבוה ביותר. מתוך RAG, Chunking — חלוקת מסמכים לקטעים. (ניסיון לחתוך קודם בין פסקאות, אחר כך בין משפטים ורק בסוף בין מילים), חלוקה לפי מבנה המסמך (כותרות, סעיפים), Semantic chunkingחיתוך איפה שהנושא משתנה, לפי ירידה חדה בדמיון בין embeddings של משפטים סמוכים. מתוך RAG, Chunking — חלוקת מסמכים לקטעים. (חיתוך היכן שהמשמעות משתנה) ו-Parent-childמחפשים בין קטעי ילד קטנים, ומחזירים ל-LLM את קטעי ההורה הגדולים שלהם: לשלוף קטן, להחזיר גדול. מתוך RAG, Chunking — חלוקת מסמכים לקטעים.. כל אחת מהן מוסברת לעומק בפרק על Chunking בנושא ה-RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG.. כאן נתמקד בשאלה המעשית: איך משתמשים בהן בפועל. יש שלוש דרכים עיקריות.
הדרך הנפוצה ביותר היא ספרייה שמתקינים דרך npm או pip וקוראים לה מהקוד, כך שהכל רץ אצלכם ובלי תשלום לפי שימוש. ב-LangChainפריימוורק בקוד פתוח לבניית אפליקציות מבוססות LLM ו-agents, שעוטף רכיבים חוזרים בממשק אחיד. מתוך LangChain, מבוא ל-LangChain. יש חבילה ייעודית (@langchain/textsplitters ב-JavaScript, langchain-text-splitters ב-Python) עם מחלקות כמו RecursiveCharacterTextSplitter ו-MarkdownHeaderTextSplitter. ב-LlamaIndex יש SentenceSplitter ו-SemanticSplitterNodeParser, ויש גם ספריות קטנות שמיועדות רק ל-chunking, כמו Chonkie. הפונקציה chunkDocument בקוד של שלב 2 מייצגת בדיוק קריאה כזו.
הדרך השנייה היא שירות לעיבוד מסמכים, כמו Unstructured, שזמין גם כספרייה בקוד פתוח וגם כ-API מנוהל: שולחים קובץ PDF, Word או HTML ומקבלים בחזרה טקסט נקי שכבר מחולק לקטעים. זה שימושי כשהחלק הקשה הוא דווקא חילוץ הטקסט מקבצים מסובכים. הדרך השלישית היא שירות שמנהל את כל ה-pipeline בשבילכם: מעלים קבצים, והוא מחלק, יוצר embeddings ושומר באינדקס בעצמו. ב-Vector Stores של OpenAI, למשל, ברירת המחדל היא קטעים של 800 טוקנים עם חפיפה של 400, וב-Amazon Bedrock Knowledge Bases בוחרים בין fixed-size, hierarchical ו-semantic. בפועל, רוב הפרויקטים מתחילים ב-Recursive splitting מספרייה, ועוברים לשיטה מורכבת יותר רק אם מדידה מראה שאיכות האחזור לא מספיקה.
שלב 2: יצירת Embeddings לכל קטע
כל קטע עובר במודל embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. ומקבל וקטור. בשלב הזה בונים בדרך כלל תור עבודה שמריץ את כל הקטעים במודל (לרוב באמצעות API חיצוני), ואוסף את הוקטורים שמתקבלים לצד מזהה הקטע המקורי.
async function embed(text: string): Promise<number[]> {
  const response = await embeddingClient.create({
    model: "text-embedding-model",
    input: text,
  });
  return response.embedding;
}

const chunks = chunkDocument(document, { size: 500, overlap: 50 });
const embeddedChunks = await Promise.all(
  chunks.map(async (chunk) => ({
    id: chunk.id,
    vector: await embed(chunk.text),
    metadata: { source: document.id, ...chunk.metadata },
  }))
);
שלב 3: שמירה באינדקס וקטורי (Upsert)
הוקטורים, יחד עם מטא-דאטה רלוונטי (מזהה מקור, תאריך, קטגוריה וכד'), נשמרים באינדקס הוקטורי — בין אם זה מסד נתונים וקטורי ייעודי, תוסף וקטורי למסד קיים, או ספרייה מוטמעת (כפי שנסקר בפרק הקודם). פעולת השמירה נקראת בדרך כלל upsert — הוספה אם המזהה חדש, עדכון אם הוא כבר קיים.
await vectorIndex.upsert(
  embeddedChunks.map((chunk) => ({
    id: chunk.id,
    values: chunk.vector,
    metadata: chunk.metadata,
  }))
);
שלב 4: שאילתה — Embedding וחיפוש Top-k
בזמן שאילתה, טקסט החיפוש עצמו עובר באותו מודל embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. בדיוק (חשוב: אותו מודל שיצר את הוקטורים המאונדקסים — לא ניתן לערבב מודלים שונים, כי המרחבים הווקטוריים שלהם אינם ניתנים להשוואה זה לזה), ומתקבל וקטור שאילתה. הוקטור הזה מוזן לאינדקס, שמחזיר את k הפריטים הקרובים ביותר.
const queryVector = await embed(userQuestion);

const results = await vectorIndex.query({
  vector: queryVector,
  topK: 5,
});
שלב 5: שילוב סינון לפי מטא-דאטה
רוב מערכות הפרודקשן לא מסתפקות בחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. "נקי" — הן משלבות אותו עם סינון קשיח לפי שדות מבניים, בהתאם לצורך שהוזכר בפרק הקודם ("פריטים דומים, אבל רק כאלה שבמלאי"). הסינון מצטרף לשאילתה עצמה, ומצמצם את מרחב החיפוש עוד לפני או תוך כדי חישוב הדמיון הוקטורי.
const filteredResults = await vectorIndex.query({
  vector: queryVector,
  topK: 5,
  filter: { category: "docs", updatedAfter: "2026-01-01" },
});
שאלות נפוצות
מה גודל ה-chunk הנכון?
אין גודל אחד שמתאים לכולם. נקודת פתיחה נפוצה היא כמה מאות טוקנים עם חפיפה של כ-10%–20%, בדומה לדוגמת הקוד בפרק (500 עם חפיפה של 50). עדיף לפצל לפי המבנה הטבעי של המסמך — כותרות ופסקאות — ולא באמצע משפט, ולהשוות כמה גדלים מול שאילתות אמיתיות לפני שמחליטים.
האם צריך לשלוח כל קטע בבקשה נפרדת למודל ה-embedding?
לא, ובקנה מידה גדול גם לא כדאי. רוב ה-APIs מקבלים מערך של טקסטים בקריאה אחת (batching), וכך חוסכים בקשות רשת ונשארים בתוך מגבלות הקצב. Promise.all על אלפי קטעים, כמו בדוגמה הפשוטה בפרק, ישלח אלפי בקשות במקביל. בפועל מחלקים לאצוות, מגבילים את מספר הבקשות המקבילות ומוסיפים ניסיונות חוזרים.
איך מעדכנים את האינדקס כשמסמך משתנה?
יוצרים מחדש embeddings רק לקטעים של אותו מסמך ועושים להם upsert. כדאי לתת לקטעים מזהים יציבים (למשל מזהה המסמך ומספר הקטע) ולמחוק קטעים שכבר לא קיימים: אם המסמך התקצר, upsert לבדו ישאיר באינדקס קטעים ישנים. שמירת hash של כל קטע מאפשרת גם לדלג על קטעים שלא השתנו.