מבוא ל-RAG
איזו בעיה RAG פותר
LLM יודע רק את מה שהיה בנתוני האימון שלו, והידע הזה קפוא בנקודת זמן אחת: ה-knowledge cutoff. כל מה שקרה אחריה, וכל מה שמעולם לא היה ברשת הציבורית (מסמכים פנימיים של חברה, תיעוד מוצר, טיקטים, חוזים, קוד פרטי), פשוט לא קיים מבחינת המודל.
הבעיה החמורה יותר היא שהמודל לא יודע שהוא לא יודע. כשהוא נשאל על עובדה שלא ראה, הוא עדיין מייצר את הרצף הסביר ביותר סטטיסטית, ולכן מקבלים hallucination: תשובה רהוטה, בטוחה בעצמה ושגויה. אין לו מנגנון פנימי שמבדיל בין עובדה שנלמדה היטב לבין השלמה שנשמעת סבירה.
יש גם דרישה שלישית שקשה לענות עליה בלי RAG: ייחוס. במערכות ארגוניות לא מספיק שהתשובה נכונה. צריך לדעת מאיזה מסמך היא הגיעה, כדי שמשתמש יוכל לאמת אותה וכדי שאפשר יהיה לבדוק אותה בדיעבד.
RAG (Retrieval-Augmented Generation, מונח שטבעו Lewis ועמיתיו ב-2020) פותר את שלוש הבעיות באותו רעיון. לפני שהמודל עונה, שולפים (retrieve) מתוך מאגר ידע חיצוני את הקטעים הרלוונטיים לשאלה. מכניסים אותם לפרומפט (augment) ומבקשים מהמודל לייצר (generate) תשובה שמבוססת עליהם בלבד. הידע יושב מחוץ למודל: אפשר לעדכן אותו בכל רגע, להגביל גישה אליו, ולהצביע על המקור של כל טענה.
כבר נתקלנו ב-RAG בפרק הראשון של נושא ה-Vector Search, שם הוא הוצג כמניע המרכזי לחיפוש וקטורי: הדרך לתת ל-LLM גישה לידע עדכני או פרטי. שם הוא היה דוגמה לשימוש. בנושא הזה הוא עומד במרכז, ונפרק אותו לכל המנגנונים שצריך כדי לממש אותו.
חשוב להבין מה RAG לא עושה: הוא לא משנה את המשקלות של המודל ולא מלמד אותו שום דבר. הוא משנה רק את ה-input. לכן כל איכות התשובה תלויה בשני דברים: האם הקטעים הנכונים באמת נשלפו, והאם המודל השתמש בהם נאמנה. כל שאר הנושא עוסק בשני הדברים האלה.
RAG מול Fine-tuning מול Long Context
Fine-tuning מעדכן את משקלות המודל על דאטה נוסף. הוא טוב מאוד בלימוד התנהגות: פורמט פלט, טון, סגנון, שימוש עקבי בטרמינולוגיה של דומיין או משימה צרה שחוזרת על עצמה. הוא גרוע בהזרקת עובדות. העובדות נספגות במשקלות באופן לא אמין, אי אפשר לעדכן או למחוק עובדה בודדת בלי אימון מחדש, אי אפשר לדעת מאיזה מקור הגיעה תשובה, ואין דרך לאכוף הרשאות, כי כל מי שמשתמש במודל נחשף לכל מה שהוא ספג.
Long context, כלומר להכניס את כל המסמכים לפרומפט, נראה כמו פתרון פשוט עכשיו שחלונות הקונטקסט גדלו. בנושא ה-LLM, בסעיף 'Context Window — הזיכרון של ה-AI', ראינו שהחלון סופי. גם כשהוא גדול, יש לזה מחיר: עלות ו-latency עולים עם כל טוקן בכל קריאה, ומודלים נוטים לנצל פחות טוב מידע שקבור באמצע קונטקסט ארוך (נחזור לזה בפרק 8). מאגר ידע ארגוני של אלפי מסמכים גם פשוט לא נכנס.
RAG נמצא באמצע. הידע עדכני ברמת המסמך הבודד (משנים מסמך ומאנדקסים אותו מחדש תוך שניות), העלות לשאלה קבועה פחות או יותר ולא תלויה בגודל המאגר, אפשר לסנן לפי הרשאות המשתמש לפני שהמידע מגיע למודל, וכל תשובה ניתנת לייחוס. המחיר הוא מורכבות הנדסית: pipeline שלם שכל שלב בו יכול להיכשל, וזה בדיוק מה שהנושא הזה מלמד לבנות.
בפועל אלה לא חלופות שמוציאות זו את זו. דפוס נפוץ: RAG אחראי על הידע, fine-tuning (אם בכלל) אחראי על ההתנהגות, למשל לענות תמיד בפורמט מסוים עם ציטוטים. Long context משמש כשהמאגר קטן מספיק, או ככלי משלים בשלב ה-generation, שבו מכניסים מסמכים שלמים במקום קטעים אחרי שה-retrieval כבר צמצם אותם.
כלל אצבע: אם השאלה היא 'המודל לא יודע X', הפתרון הוא כמעט תמיד RAG. אם השאלה היא 'המודל לא מתנהג כמו שאני רוצה', זה prompt engineering ואחר כך fine-tuning. אם כל הידע הרלוונטי הוא כמה עשרות עמודים שמשתנים לעתים רחוקות, שווה לבדוק קודם אם long context עם prompt caching לא מספיק.
הארכיטקטורה: שלב ה-Indexing (offline)
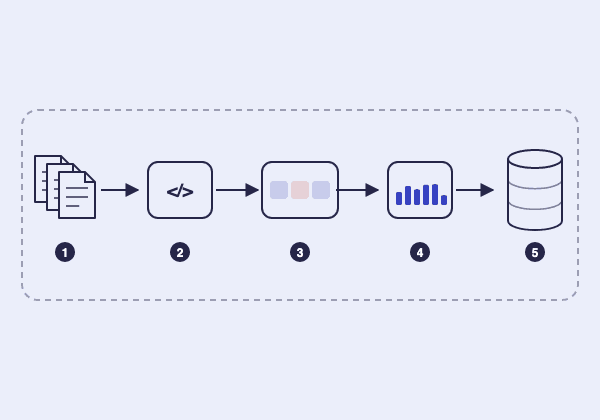
כל מערכת RAG בנויה משני שלבים שרצים בזמנים שונים. הראשון הוא ה-indexing: תהליך offline (batch או streaming) שמכין את מאגר הידע לשליפה מהירה. הוא רץ כשמסמכים נוספים או משתנים, לא כשמשתמש שואל.
השלבים שלו: Ingest (משיכת מסמכים מהמקורות), Parse (המרת PDF, HTML ו-DOCX לטקסט נקי עם מבנה ו-metadata), Chunk (חלוקה לקטעים בגודל שמתאים לשליפה), Embed (הפיכת כל קטע לוקטור) ו-Index (שמירה במסד נתונים וקטורי ולרוב גם באינדקס טקסטואלי כמו BM25, יחד עם ה-metadata).
את הגרסה הבסיסית של השרשרת הזו כבר בנינו בנושא ה-Vector Search, בפרק 'בניית pipeline לחיפוש וקטורי'. כאן נעמיק בכל חוליה, כי ב-RAG ההחלטות בשלב הזה (איך מפרסרים טבלה, איפה חותכים קטע, איזה metadata שומרים) קובעות את התקרה של איכות המערכת. שום מודל חכם בשלב ה-generation לא יציל קטע שנחתך באמצע משפט או טבלה שהפכה לרצף מספרים חסר משמעות.
תכונה חשובה של השלב הזה היא שהוא יקר פעם אחת ולא בכל שאלה. אפשר להשקיע בו חישוב כבד (parsing עם מודל layout, קריאת LLM לכל קטע כדי להוסיף לו הקשר, כמו שנראה בפרק 3), כי העלות מתחלקת על כל השאילתות העתידיות.
הארכיטקטורה: שלב ה-Query (online)
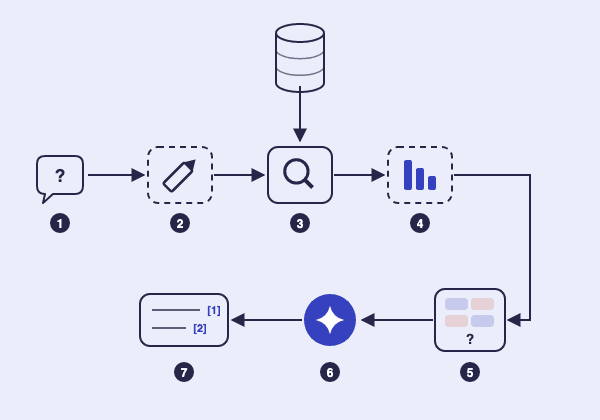
השלב השני רץ בכל פעם שמשתמש שואל, ולכן הוא רגיש ל-latency ולעלות לשאלה. השרשרת המלאה: Query → Transform (אופציונלי) → Retrieve → Rerank (אופציונלי) → Augment → Generate → Cite.
Transform משכתב את השאלה לפני החיפוש: הופך שאלת המשך בשיחה לשאלה עצמאית, מפרק שאלה מורכבת לתתי-שאלות וכדומה. Retrieve שולף מועמדים מהאינדקס, בחיפוש וקטורי, בחיפוש מילות מפתח או בשילוב שלהם. Rerank מדרג מחדש את המועמדים במודל מדויק ויקר יותר ומשאיר רק את הטובים ביותר.
Augment בונה את הפרומפט: הוראות, הקטעים שנבחרו עם מזהי מקור, והשאלה. Generate מפעיל את ה-LLM. Cite ממפה את הציטוטים בתשובה חזרה למסמכים, ומוודא שכל מזהה שהמודל ציטט באמת היה בקונטקסט.
שני השלבים האופציונליים, Transform ו-Rerank, הם בדיוק מה שמבדיל בין 'naive RAG' ל-RAG שעובד בפרודקשן. כל אחד מוסיף latency ועלות, ולכן מוסיפים אותם כשמדידה מראה שהם נחוצים ולא כברירת מחדל. זה גם הסיבה שהפרק האחרון בנושא מוקדש להערכה.
Naive RAG בקוד: קו הבסיס
הנה המימוש המינימלי של שני השלבים. זה 'naive RAG': chunking בגודל קבוע, חיפוש וקטורי בלבד, top-k קבוע ופרומפט פשוט. הוא עובד מפתיע טוב על שאלות פשוטות, ונכשל בדרכים צפויות. השאלות מנוסחות אחרת מהמסמכים, מזהים מדויקים כמו מק״ט או קוד שגיאה לא נמצאים בחיפוש סמנטי, הקטע הרלוונטי נחתך, או שה-top-5 מלא בקטעים דומים זה לזה.
שמות הלקוחות (embeddingClient, vectorStore, llm) גנריים בכוונה. כל ספק ו-SDK חושף ממשק קצת אחר, והמבנה הוא מה שחשוב. כל פרק בהמשך הנושא מחליף חוליה אחת בקוד הזה בגרסה חזקה יותר.
// ---------- Offline: indexing ----------
async function indexDocuments(docs: SourceDocument[]): Promise<void> {
  for (const doc of docs) {
    const chunks = chunkDocument(doc.text, { size: 500, overlap: 50 });
    const vectors = await embeddingClient.embedMany(chunks.map((c) => c.text));

    await vectorStore.upsert(
      chunks.map((chunk, i) => ({
        id: `${doc.id}#${i}`,
        vector: vectors[i],
        metadata: { docId: doc.id, title: doc.title, text: chunk.text },
      }))
    );
  }
}

// ---------- Online: query ----------
async function answer(question: string): Promise<string> {
  const queryVector = await embeddingClient.embed(question);
  const hits = await vectorStore.query({ vector: queryVector, topK: 5 });

  const context = hits
    .map((hit, i) => `[${i + 1}] ${hit.metadata.title}\n${hit.metadata.text}`)
    .join("\n\n");

  return llm.generate({
    system:
      "Answer only from the sources below. If the answer is not in them, say you don't know. Cite sources as [n].",
    prompt: `Sources:\n${context}\n\nQuestion: ${question}`,
  });
}
מפת הדרכים: איזה פרק מעמיק באיזו חוליה
שלב ה-indexing: פרק 2 (Ingestion ו-Parsing) עוסק בהפיכת מקורות אמיתיים לטקסט נקי עם metadata, ובשמירה על האינדקס מסונכרן. פרק 3 (Chunking) עוסק באיפה ואיך חותכים. פרק 4 (Embeddings ואינדוקס) עוסק בבחירת מודל ה-embedding, בתכנון הסכמה וב-multi-tenancy.
שלב ה-query: פרק 5 (Retrieval) עוסק ב-dense, sparse ו-hybrid, ב-RRF, בסינון וב-MMR. פרק 6 (Query Transformation) עוסק בשכתוב שאלות, multi-query ו-HyDE. פרק 7 (Reranking) עוסק ב-cross-encoders וב-retrieval דו-שלבי. פרק 8 (Augmentation ו-Generation) עוסק בהרכבת הפרומפט, תקציב קונטקסט, ציטוטים וסירוב מבוסס.
מעבר ל-pipeline הלינארי: פרק 9 מציג ארכיטקטורות מתקדמות (Agentic RAG, Self-RAG, CRAG, GraphRAG). פרק 10 עוסק במדידה, כלומר איך יודעים שהשינוי שעשיתם באמת שיפר משהו, ובנושאי פרודקשן: caching, הרשאות ו-prompt injection דרך מסמכים.