Retrieval — שליפת הקטעים הרלוונטיים
Dense retrieval: איפה הוא חזק ואיפה הוא נכשל
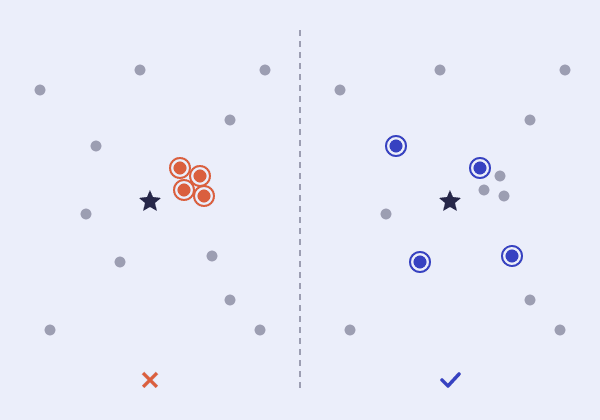
Dense retrieval הוא מה שבנינו עד עכשיו: מקודדים את השאילתה לוקטור צפוף ומחפשים את השכנים הקרובים באינדקס. החוזקה שלו היא התאמה לפי משמעות. 'איך מבטלים מנוי' ימצא קטע שכתוב בו 'הפסקת החברות בשירות', בלי אף מילה משותפת.
החולשות שלו צפויות וחוזרות. מזהים מדויקים כמו מק״ט, קוד שגיאה (E-4031), מספר גרסה, שם פונקציה או מספר חוזה הם מחרוזות שמודל ה-embedding כמעט לא ראה, והוקטור שלהן לא לוכד את הזהות המדויקת. קטע על E-4032 ייראה לו כמעט זהה. מונחים נדירים, שמות פרטיים ומונחים ספציפיים לארגון שלא הופיעו בנתוני האימון סובלים מאותה בעיה.
בנוסף, embedding צפוף מסכם קטע שלם לוקטור אחד, ולכן הוא חלש בהבחנות עדינות. שלילה ('לא נתמך ב-Windows' מול 'נתמך ב-Windows') או הבדל של מילה אחת שמשנה את המשמעות לרוב יוצאים קרובים מאוד במרחב. זו בדיוק הסיבה שב-RAG בפרודקשן כמעט אף פעם לא מסתמכים על dense retrieval לבד.
Sparse retrieval: איך BM25 באמת עובד
BM25 הוא אלגוריתם הדירוג הלקסיקלי הסטנדרטי, ומנועי חיפוש כמו Elasticsearch ו-OpenSearch משתמשים בו כברירת מחדל. הוא עובד על אינדקס הפוך (inverted index): לכל מונח נשמרת רשימת המסמכים שמכילים אותו. הציון של מסמך הוא סכום, על כל מונח בשאילתה, של שלושה גורמים: IDF, תדירות המונח והתאמה לאורך.
IDF (Inverse Document Frequency) מבטא כמה המונח נדיר בכל המאגר. מונח שמופיע במעט מסמכים מקבל משקל גבוה, ומילה שמופיעה בכל מסמך מקבלת משקל קרוב לאפס. זו בדיוק התכונה שחסרה ב-dense retrieval: מזהה נדיר כמו E-4031 מקבל משקל עצום.
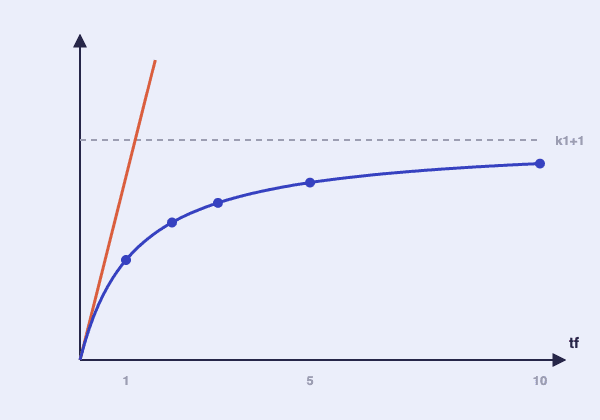
תדירות המונח (TF) מקבלת רוויה דרך הפרמטר k1. הופעה שנייה ושלישית של מונח מעלות את הציון, אבל כל הופעה נוספת מוסיפה פחות, והציון שואף לתקרה. בנוסחה: tf·(k1+1) / (tf + k1·(...)). בלי רוויה, מסמך שחוזר על מילה 50 פעם היה מנצח. ערכים נפוצים של k1 הם בערך 1.2 עד 2.
הפרמטר b (בדרך כלל 0.75) קובע נרמול לפי אורך. הגורם בסוגריים הוא (1 − b + b·|d|/avgdl), כאשר |d| הוא אורך המסמך ו-avgdl הוא האורך הממוצע. מסמך ארוך מהממוצע 'נענש', כי יש לו יותר הזדמנויות להכיל כל מילה במקרה. עם b=0 אין נרמול, ועם b=1 הנרמול מלא. ב-RAG האורך של כל הקטעים דומה בגלל ה-chunking, ולכן ההשפעה של b קטנה יותר מאשר על מסמכים שלמים.
אזהרה ספציפית לעברית: BM25 עובד על מונחים, ובעברית מילות היחס והחיבור מודבקות למילה. 'ובבית', 'לבית', 'שבבית' ו'הבית' הם ארבעה מונחים שונים לגמרי עבור tokenizer נאיבי שמפצל לפי רווחים. צריך analyzer שמתאים לעברית, עם הסרת תחיליות או lemmatization, אחרת ה-recall הלקסיקלי בעברית נמוך מאוד. זה שיקול בבחירת מנוע החיפוש.
Learned sparse retrieval: SPLADE
BM25 יודע רק על מילים שכתובות במסמך. Learned sparse retrieval, שהמשפחה הידועה בו היא SPLADE, מאמן מודל transformer לייצר לכל טקסט וקטור דליל על פני כל אוצר המילים של המודל. רוב הערכים הם אפס, אבל למונחים רלוונטיים יש משקל. המודל לומד גם להרחיב: מסמך על 'רכב' יקבל משקל גם למונח 'מכונית', גם אם הוא לא מופיע בו.
היתרון המעשי הוא שהפלט עדיין דליל, ולכן אפשר לאחסן ולחפש אותו באינדקס הפוך רגיל, עם היעילות של חיפוש לקסיקלי, תוך שילוב חלק מהיכולת הסמנטית. החסרונות: צריך להריץ מודל בזמן האינדוקס ובזמן השאילתה, התמיכה משתנה בין מסדי הנתונים, והמודלים זמינים בעיקר לאנגלית. לרוב המערכות, ובמיוחד בעברית, השילוב BM25 + dense הוא נקודת הפתיחה הסבירה.
Hybrid retrieval ו-Reciprocal Rank Fusion
בנושא ה-Vector Search, בפרק על Hybrid Search, ראינו את הרעיון: מריצים חיפוש וקטורי וחיפוש מילות מפתח במקביל ומאחדים את התוצאות. כאן נתמקד בשאלה שנשארה פתוחה שם: איך בדיוק מאחדים.
הניסיון הראשון, לחבר את הציונים, נכשל. הציונים לא באותה סקאלה. ציון BM25 לא חסום, ותלוי באורך השאילתה ובגודל המאגר (שאילתה של 6 מילים מקבלת ציונים גבוהים בהרבה משאילתה של 2). ציון cosine נע בטווח צר, שהמיקום שלו תלוי במודל. חיבור ישיר נותן לאחד מהם לשלוט באופן שרירותי.
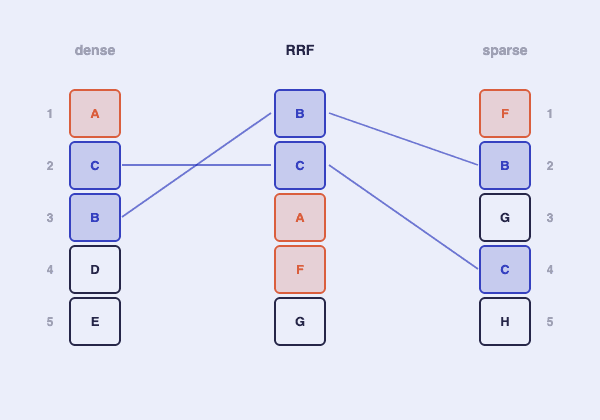
Reciprocal Rank Fusion (RRF), שהוצע על ידי Cormack ועמיתיו ב-2009, פותר את זה בכך שהוא מתעלם מהציונים לגמרי ומשתמש רק בדירוג. כל מסמך מקבל, מכל רשימת תוצאות שבה הוא מופיע, את הערך 1/(k + rank), כאשר rank הוא המיקום שלו ברשימה (החל מ-1) ו-k הוא קבוע. הערך המקובל, מהמאמר המקורי, הוא k=60. הציון הסופי הוא סכום הערכים מכל הרשימות.
k קובע כמה הדירוג העליון שולט. עם k=60, ההבדל בין מקום 1 (1/61) למקום 10 (1/70) קטן יחסית, ומסמך שמופיע במקום בינוני בשתי הרשימות יעקוף מסמך שמופיע במקום ראשון ברשימה אחת בלבד. זו בדיוק ההתנהגות הרצויה ב-hybrid: הסכמה בין שתי שיטות שונות היא אות חזק. k קטן יותר מעדיף את המקומות הראשונים. אפשר גם להוסיף משקל לכל רשימה (weighted RRF).
החלופה היא נרמול ציונים (למשל min-max לכל רשימה) ואז שילוב ליניארי, α·dense + (1−α)·sparse. היא יכולה להיות מדויקת יותר, כי היא משמרת מידע על המרווח בין התוצאות, אבל היא רגישה לפיזור הציונים בכל שאילתה ודורשת כיוונון של α על eval set. RRF עובד טוב בלי כיוונון, ולכן הוא ברירת המחדל הנפוצה.
function reciprocalRankFusion(rankings: Hit[][], k = 60): Hit[] {
  const fused = new Map<string, { hit: Hit; score: number }>();

  for (const ranking of rankings) {
    ranking.forEach((hit, index) => {
      const entry = fused.get(hit.id) ?? { hit, score: 0 };
      entry.score += 1 / (k + index + 1); // rank is 1-based
      fused.set(hit.id, entry);
    });
  }

  return [...fused.values()].sort((a, b) => b.score - a.score).map((entry) => entry.hit);
}

async function hybridSearch(query: string, topK: number, filter: Filter): Promise<Hit[]> {
  const [dense, sparse] = await Promise.all([
    vectorStore.query({ vector: await embedQuery(query), topK: topK * 2, filter }),
    keywordIndex.search({ query, topK: topK * 2, filter }), // BM25
  ]);
  return reciprocalRankFusion([dense, sparse]).slice(0, topK);
}
סינון לפי metadata: pre-filter מול post-filter
כמעט כל שאילתת RAG אמיתית כוללת סינון: לפי tenant, הרשאות, סוג מסמך, שפה או טווח תאריכים. יש שתי דרכים להפעיל אותו, וההבדל ביניהן גדול.
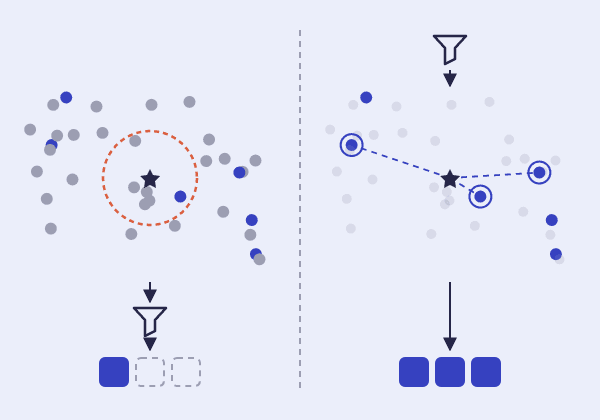
Post-filtering שולף top-k מכל האינדקס, ורק אחר כך מסנן. זה פשוט, וזו מלכודת recall. אם המשתמש רשאי לראות 2% מהמסמכים, ושולפים top-10 ואז מסננים, בממוצע נשארות 0.2 תוצאות. כלומר ברוב השאילתות לא נשאר כלום, גם כשיש במאגר מסמכים מורשים רלוונטיים מאוד שפשוט לא הגיעו ל-top-10 הגלובלי. הגדלת k מקטינה את הבעיה אבל לא פותרת אותה, והיא עולה ב-latency.
Pre-filtering, או filtered search, מפעיל את הסינון כחלק מהחיפוש עצמו, כך שה-top-k נבחר רק מתוך המסמכים שעוברים את הסינון. זה מה שצריך כמעט תמיד ב-RAG, ובמיוחד להרשאות. מסדי נתונים וקטוריים מממשים את זה בדרכים שונות, ובנושא ה-Vector Search ראינו שסינון סלקטיבי מאוד על אינדקס גרפי יכול לפגוע בביצועים. כדאי לבדוק את התיעוד של המערכת שלכם ולמדוד recall עם סינונים ריאליסטיים, לא רק בלי סינון.
כמה לשלוף: top-k וספי ציון
צריך להבחין בין שני מספרים. retrieval k הוא כמה מועמדים שולפים מהאינדקס. context k הוא כמה קטעים נכנסים בסוף לפרומפט. בלי reranking, שניהם אותו מספר, ויש trade-off ישיר: k גדול משפר recall אבל מכניס יותר רעש ויותר טוקנים. עם reranking (פרק 7) אפשר להפריד ביניהם: לשלוף 50 עד 100 מועמדים ל-recall גבוה, ולהעביר רק את 5 עד 10 הטובים ל-LLM.
הפיתוי הטבעי הוא להגדיר סף, למשל 'רק קטעים עם cosine מעל 0.8', כדי לא להכניס קטעים לא רלוונטיים. ספים מוחלטים שבירים מאוד. התפלגות הציונים שונה בין מודלים: בחלק מהמודלים גם טקסטים לא קשורים מקבלים cosine של 0.7, ובאחרים גם התאמות טובות נשארות סביב 0.5. היא משתנה גם בין שאילתות, כי שאילתות קצרות וארוכות מקבלות טווחים שונים. סף שכויל על מודל אחד מפסיק לעבוד כשמחליפים מודל.
חלופות עמידות יותר: סף יחסי (לזרוק תוצאות שהציון שלהן נמוך משמעותית מזה של התוצאה הראשונה), סף על ציון ה-reranker, שמכויל טוב יותר כי הוא מעריך את הזוג שאילתה-קטע ישירות, או לתת ל-LLM להחליט שהמידע לא מספיק (פרק 8). אם בכל זאת משתמשים בסף מוחלט, מכיילים אותו על eval set ומתעדים לאיזה מודל הוא שייך.
MMR: גיוון בתוצאות
Top-k לפי דמיון בלבד נוטה להחזיר קטעים דומים זה לזה: שני קטעים חופפים בגלל ה-overlap, אותו פסקה משלושה עותקים של מסמך, או חמש וריאציות של אותה נקודה. חמשת המקומות בקונטקסט מנוצלים למידע אחד.
Maximal Marginal Relevance (MMR, מ-Carbonell ו-Goldstein, 1998) בוחר את התוצאות אחת-אחת. בכל צעד הוא לוקח את המועמד שממקסם λ·sim(query, d) − (1−λ)·max sim(d, s), כאשר s עובר על כל הקטעים שכבר נבחרו. האיבר הראשון מתגמל רלוונטיות, והשני מעניש דמיון למה שכבר יש. עם λ=1 מקבלים top-k רגיל. ערכים נמוכים יותר מעדיפים גיוון, וערך סביב 0.5 עד 0.7 הוא נקודת פתיחה נפוצה.
MMR רץ על קבוצת מועמדים ששולפים קודם (למשל top-50), כי הוא צריך את הוקטורים ומחשב דמיון בין כל זוג, ולכן לא רץ על כל האינדקס. הוא שימושי במיוחד כששאלות דורשות כמה היבטים ('מה היתרונות והחסרונות של...'), ופחות כשהשאלה נקודתית ויש קטע אחד נכון.
function maximalMarginalRelevance(
  queryVector: number[],
  candidates: HitWithVector[],
  k: number,
  lambda = 0.7
): HitWithVector[] {
  const selected: HitWithVector[] = [];
  const remaining = [...candidates];

  while (selected.length < k && remaining.length > 0) {
    let bestIndex = 0;
    let bestScore = -Infinity;

    remaining.forEach((candidate, i) => {
      const relevance = dot(queryVector, candidate.vector); // vectors are normalized
      const redundancy = selected.length
        ? Math.max(...selected.map((s) => dot(candidate.vector, s.vector)))
        : 0;
      const score = lambda * relevance - (1 - lambda) * redundancy;
      if (score > bestScore) {
        bestScore = score;
        bestIndex = i;
      }
    });

    selected.push(remaining.splice(bestIndex, 1)[0]);
  }
  return selected;
}