Ingestion ו-Parsing — הכנת המסמכים
Garbage in, garbage out
הטעות הנפוצה ביותר בפרויקטי RAG היא להתייחס ל-ingestion כשלב טכני משעמם ('פשוט נחלץ את הטקסט') ולהשקיע את כל המאמץ ב-retrieval וב-prompt. בפועל, כשמנתחים כשלונות של מערכת RAG, חלק גדול מהם מתחיל כאן. הטקסט שחולץ שבור, הטבלה איבדה את המבנה שלה, כותרת עמוד חוזרת מופיעה באמצע כל קטע, או שהמסמך בכלל לא נקלט.
הסיבה שהנזק כל כך גדול היא שכל השלבים הבאים עיוורים לו. מודל ה-embedding יקודד בנאמנות גם טקסט שבור. ה-retrieval ימצא בנאמנות את הקטע השבור. ה-LLM יקבל אותו ויאלתר תשובה. אף שלב לא יזרוק שגיאה, והאיכות פשוט תהיה נמוכה בלי הסבר ברור.
לכן העיקרון המנחה של הפרק: מטרת ה-ingestion היא לא 'לחלץ טקסט' אלא לייצר ייצוג אחיד, נקי ומובנה של כל מסמך. הייצוג כולל טקסט שמשמר מבנה (כותרות, רשימות, טבלאות), metadata עשיר ומזהה יציב, כדי שכל השלבים הבאים יוכלו לעבוד על קלט אחד צפוי ולא על עשרות פורמטים.
Loaders ו-Connectors
שכבת ה-connectors אחראית על משיכת מסמכים ממקורות: מערכת קבצים ו-object storage (S3, GCS), אתרי web (crawling עם sitemap ו-robots.txt), מערכות SaaS (Confluence, Notion, Google Drive, SharePoint, Jira, Zendesk) ומסדי נתונים. כל connector חושף בעצם שתי פעולות: לרשום את המסמכים הקיימים (עם מזהה ותאריך עדכון) ולהביא את התוכן של מסמך בודד.
שלוש דרישות לא מובנות מאליהן מכל connector. הראשונה היא מזהה יציב: אותו מסמך מקבל את אותו id בכל ריצה, למשל מזהה המקור עצמו או שילוב של source ו-URI ולא מספר רץ. בלי זה אי אפשר לעדכן או למחוק. השנייה היא חותמת זמן או גרסה, שמאפשרת sync אינקרמנטלי. השלישית היא הרשאות: מי רשאי לראות את המסמך במערכת המקור. מידע ההרשאות חייב להגיע כבר בשלב הזה, כי אחרי שהמסמך באינדקס כבר אין דרך לשחזר אותו.
מקורות API מגבילים קצב (rate limits), מחזירים תוצאות בעמודים (pagination) ולפעמים נכשלים באמצע. ה-connector צריך לתמוך ב-retry עם backoff ולשמור נקודת המשך (cursor), כדי שריצה שנכשלה אחרי 40,000 מסמכים לא תתחיל מאפס.
Parsing לפי פורמט: HTML ו-PDF
HTML נראה קל כי הטקסט כבר שם, אבל רוב ה-DOM של דף אמיתי הוא לא תוכן: תפריטי ניווט, footer, באנרים של cookies, sidebar עם 'מאמרים קשורים'. אם לא מסירים את ה-boilerplate, אותו תפריט ניווט יופיע בכל קטע מכל דף, ישלוט בוקטורים וייצר התאמות שקריות. הגישה הנפוצה היא חילוץ תוכן ראשי (main content extraction) לפי אלמנטים סמנטיים כמו main ו-article וצפיפות טקסט, ואז המרה ל-Markdown שמשמרת כותרות, רשימות, קוד וטבלאות.
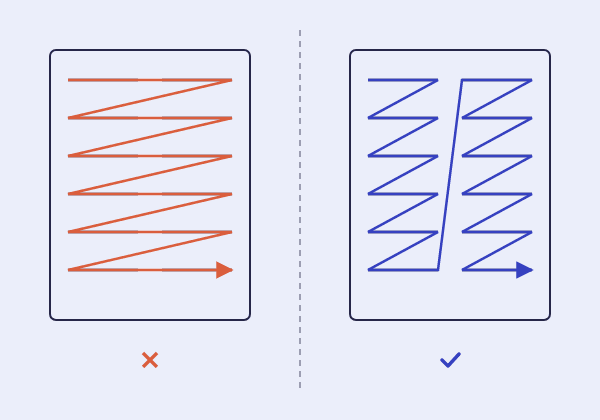
PDF הוא הפורמט הקשה ביותר, כי הוא פורמט תצוגה ולא פורמט מסמך. הוא מתאר איפה לצייר כל גליף בעמוד, לא מה סדר הקריאה ולא מה כותרת ומה פסקה. חילוץ טקסט מה-text layer הוא מהיר וזול, אבל נופל בדפוסים קבועים: מסמך בשתי עמודות נקרא לרוחב ומערבב שורות משתי העמודות, כותרת עליונה ומספר עמוד חוזרים באמצע הטקסט, מילים נשברות במקף בסוף שורה, וטבלה הופכת לרצף מספרים בלי שורות ועמודות.
בעברית ובשפות RTL אחרות יש מלכודת נוספת. בחלק מקובצי ה-PDF הטקסט שמור בסדר ויזואלי ולא לוגי, ולכן חילוץ נאיבי מחזיר מילים או תווים הפוכים. חובה לבדוק ידנית דגימה של מסמכים עבריים אחרי parsing, לפני שמאנדקסים מיליון קטעים.
Layout-aware parsing פותר את רוב הבעיות האלה. מודל layout מזהה בלוקים בעמוד (כותרת, פסקה, טבלה, איור, header ו-footer), קובע סדר קריאה ומחלץ כל בלוק לפי הסוג שלו. הגרסה האגרסיבית ביותר משתמשת במודל vision-language שמקבל תמונה של העמוד ומחזיר Markdown. זה איטי ויקר בהרבה, אבל זכרו שזה שלב offline שמשלמים עליו פעם אחת. אסטרטגיה מעשית: text layer למסמכים פשוטים, ו-parser מבוסס layout רק למסמכים שזוהו כמורכבים (הרבה טבלאות או עמודות, או אחוז גבוה של תווים לא תקינים).
טבלאות, מסמכים סרוקים ו-OCR
טבלה היא מקרה קצה שחוזר כל הזמן במסמכים ארגוניים (מחירונים, מפרטים, דוחות), ו-chunking רגיל הורס אותה. שורה בודדת כמו '4 | 128GB | 2,499' חסרת משמעות בלי שורת הכותרות. שתי גישות נפוצות: לשמר את הטבלה כ-Markdown או HTML ולדאוג (בפרק 3) שהיא לא נחתכת, או לסדר כל שורה כמשפט עצמאי שכולל את שמות העמודות ('דגם X: זיכרון 128GB, מחיר 2,499'). הגישה השנייה משפרת retrieval של שורה בודדת. לטבלאות גדולות מאוד שווה לשקול לאחסן אותן בנפרד כמידע מובנה ולשלוף אותן בשאילתה, ולא בחיפוש סמנטי.
מסמך סרוק הוא בעצם תמונה בלי text layer. חילוץ text layer יחזיר מחרוזת ריקה בלי שום שגיאה, וזה בדיוק למה צריך לזהות את המצב במפורש: עמוד עם מעט מאוד תווים ביחס לשטחו הוא כנראה סרוק. במקרה כזה מעבירים אותו ל-OCR, עם מנוע קוד פתוח או שירות ענן. איכות ה-OCR תלויה ברזולוציה, בשפה (חשוב לוודא שהמנוע תומך בעברית) ובמבנה העמוד.
פלט OCR תמיד רועש. כדאי לשמור עם כל קטע את ציון הביטחון (confidence) של ה-OCR כ-metadata, כדי שאפשר יהיה לסנן או לסמן תשובות שנשענות על טקסט באיכות נמוכה. תמונות ודיאגרמות בתוך מסמכים הן סיפור נפרד: אפשר לייצר להן תיאור טקסטואלי עם מודל vision (caption) כבר בשלב ה-ingestion. נחזור לכך ב-multimodal RAG בפרק 9.
נרמול וניקוי
אחרי ה-parsing, כל מסמך עובר נרמול כדי ששני טקסטים זהים בתוכן יהיו זהים גם בבייטים. אחרת ה-hash של אותו מסמך ישתנה בין ריצות, deduplication ייכשל, וחיפוש מילות מפתח יחמיץ התאמות.
הצעדים הנפוצים: נרמול Unicode (NFC, כך שאותה אות עם ניקוד או תו מורכב תיוצג באותו רצף), הסרת תווים בלתי נראים (zero-width spaces, BOM ותווי כיווניות כמו RLM ו-LRM שנפוצים בטקסט עברי שהועתק ממסמכי Word), איחוד רווחים ושורות ריקות, חיבור מילים שנשברו במקף בסוף שורה, והסרת header ו-footer שחוזרים בכל עמוד (שורה שמופיעה כמעט זהה ביותר ממחצית העמודים היא כמעט תמיד כזו).
מה לא לעשות: אל תורידו אותיות גדולות, סימני פיסוק או stop words, כמו שנהוג בעיבוד טקסט קלאסי. מודלי embedding מודרניים ו-LLM-ים צריכים את הטקסט הטבעי, וההסרות האלה רק פוגעות. גם את המבנה (כותרות Markdown, רשימות) משמרים, כי ה-chunker בפרק הבא ישתמש בו כדי לחתוך במקומות הנכונים.
const INVISIBLE_CHARS = /[\u200B-\u200F\u202A-\u202E\u2066-\u2069\uFEFF]/g;

function normalizeText(text: string): string {
  return text
    .normalize("NFC")
    .replace(INVISIBLE_CHARS, "")            // zero-width + bidi control chars
    .replace(/(\p{L})-\n(\p{L})/gu, "$1$2")   // re-join words hyphenated at line end
    .replace(/[ \t]+/g, " ")
    .replace(/\n{3,}/g, "\n\n")
    .trim();
}
Metadata — המידע שמסביב לטקסט
Metadata הוא מה שהופך אוסף של קטעי טקסט למאגר ידע שאפשר לשלוט בו. כל שדה שנשמר כאן מאפשר יכולת בהמשך. source ו-URI מאפשרים ציטוט ולינק חזרה למקור (פרק 8). title ו-sectionPath, כלומר נתיב הכותרות מהמסמך אל הקטע, מאפשרים להוסיף הקשר לקטע לפני ה-embedding (פרק 3). תאריך עדכון מאפשר לסנן או להעדיף מידע עדכני. סוג מסמך ושפה מאפשרים סינון ו-routing (פרקים 5 ו-6).
השדה הקריטי ביותר הוא הרשאות (ACL). אם מערכת ה-RAG משרתת משתמשים עם הרשאות שונות, כל קטע באינדקס חייב לשאת את רשימת הקבוצות או המשתמשים שרשאים לראות אותו, והסינון חייב לקרות בזמן השליפה. בפרק 10 נראה למה אסור לסמוך על המודל שיסתיר מידע. אם ה-ACL לא נקלט בשלב ה-ingestion, אין דרך להוסיף אותו אחר כך בלי לאנדקס מחדש.
כדאי להגדיר מבנה אחד ואחיד (ParsedDocument) שכל connector ו-parser חייבים להחזיר. כל השלבים הבאים עובדים רק מולו, וכך מקור חדש הוא עוד connector ולא שינוי לאורך כל ה-pipeline.
interface ParsedDocument {
  id: string;                  // stable across runs: source-native id, never a counter
  sourceId: string;            // which connector / tenant it came from
  uri: string;                 // link back to the original, for citations
  title: string;
  body: string;                // normalized text, structure kept as Markdown
  sections: { path: string[]; startOffset: number }[]; // heading hierarchy
  mimeType: string;
  language: string;            // e.g. "he", "en"
  updatedAt: string;           // ISO 8601, from the source system
  acl: { allowedGroups: string[] };
  contentHash: string;         // sha256(body) after normalization
  parseQuality?: { ocr: boolean; confidence?: number };
}
Deduplication
מאגרים ארגוניים מלאים בכפילויות: אותו מסמך בתיקייה אחרת, גרסה 'סופית' ו'סופית 2', עמוד wiki שהועתק לשלושה מקומות, ואותו דף web תחת כמה URL-ים. כפילויות פוגעות ב-RAG ישירות. הן תופסות מקומות ב-top-k, כך שחמש תוצאות הן בפועל שתי תוצאות שונות, והן מייצרות סתירות כשגרסה ישנה וגרסה חדשה נשלפות יחד.
כפילות מדויקת מזהים בקלות: hash (למשל SHA-256) של הטקסט אחרי נרמול. בגלל זה הנרמול חייב לקרות קודם, אחרת הבדל ברווח אחד יסתיר כפילות.
Near-duplicates, כלומר מסמכים כמעט זהים עם הבדלים קטנים, דורשים טכניקה אחרת. הקלאסית היא MinHash עם LSH (Locality-Sensitive Hashing): מפרקים כל מסמך ל-shingles (רצפים חופפים של מילים), מחשבים חתימה קצרה שמשמרת בקירוב את Jaccard similarity בין קבוצות ה-shingles, ו-LSH מוצא זוגות מועמדים בלי להשוות כל מסמך לכל מסמך. חלופה פשוטה יותר ברמת הקטע היא דמיון cosine גבוה מאוד בין embeddings. אפשר להפעיל אותה כבר באינדוקס או בזמן השליפה (נראה את MMR בפרק 5).
כשמוצאים כפילויות, צריך מדיניות לבחירת הגרסה הקנונית: הגרסה העדכנית ביותר, המקור הסמכותי ביותר (תיעוד רשמי לפני העתק ב-wiki) או הנתיב הקצר ביותר. את הגרסאות האחרות לא בהכרח מוחקים. אפשר לשמור אותן כ-metadata של הקנונית, למשל כדי להציג כמה מקורות.
סנכרון אינקרמנטלי: עדכונים ומחיקות
אינדקס RAG הוא לא פרויקט חד-פעמי אלא עותק של מקורות חיים. אם הוא לא מסונכרן, המערכת תצטט בביטחון מדיניות שבוטלה או מסמך שנמחק. זה גרוע אפילו מ-hallucination, כי זה נראה מבוסס.
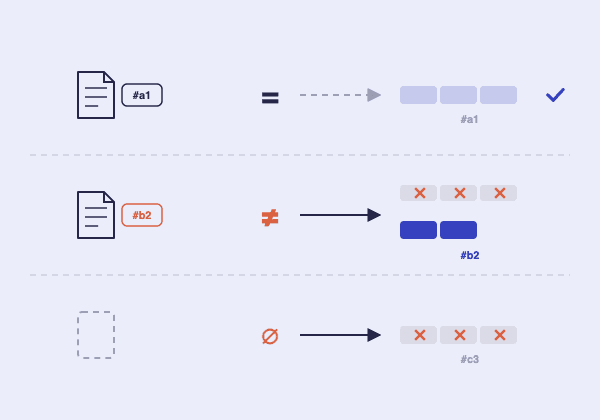
אינדוקס מחדש של הכל בכל ריצה יקר מדי: כל קטע עובר מחדש במודל ה-embedding. הפתרון הוא change detection. שומרים לכל מסמך state עם ה-contentHash מהריצה הקודמת. אם ה-hash לא השתנה, מדלגים. אם השתנה, מאנדקסים רק אותו. מקורות שתומכים בזה (webhooks או change feed) מאפשרים לקבל רק את השינויים במקום לסרוק הכל.
מלכודת עדינה בעדכון: מסמך שהתקצר מייצר פחות קטעים. אם מזהי הקטעים הם docId#0, docId#1 וכן הלאה, ועושים upsert רק לקטעים החדשים, הקטעים הישנים בסוף נשארים באינדקס כיתומים. לכן בעדכון מוחקים קודם את כל הקטעים של המסמך לפי docId ורק אחר כך מכניסים את החדשים, או כותבים גרסה חדשה ומוחקים את הישנה אחרי שהכתיבה הצליחה.
מחיקות קשות יותר, כי מסמך שנמחק פשוט לא מופיע יותר ברשימה שה-connector מחזיר. הפתרון הוא mark-and-sweep: בכל ריצה מלאה אוספים את כל ה-id-ים שנראו. כל מסמך שקיים ב-state אבל לא נראה בריצה נמחק מהאינדקס. חשוב: אם ריצת ה-listing נכשלה באמצע, אסור להריץ את ה-sweep, אחרת מוחקים חצי מאגר.
async function syncSource(connector: SourceConnector): Promise<void> {
  const seen = new Set<string>();

  for await (const raw of connector.listDocuments()) {
    seen.add(raw.id);
    const doc = await parseAndNormalize(raw);
    const previous = await ingestState.get(doc.id);

    if (previous?.contentHash === doc.contentHash) continue; // unchanged: skip re-embedding

    // Delete first: the new version may produce fewer chunks than the old one
    await vectorStore.deleteByFilter({ docId: doc.id });
    await indexDocument(doc);
    await ingestState.set(doc.id, {
      sourceId: connector.sourceId,
      contentHash: doc.contentHash,
      indexedAt: new Date().toISOString(),
    });
  }

  // Mark-and-sweep. Only reached if the full listing completed without throwing.
  for (const docId of await ingestState.listIds(connector.sourceId)) {
    if (!seen.has(docId)) {
      await vectorStore.deleteByFilter({ docId });
      await ingestState.delete(docId);
    }
  }
}