Reranking — דירוג מחדש
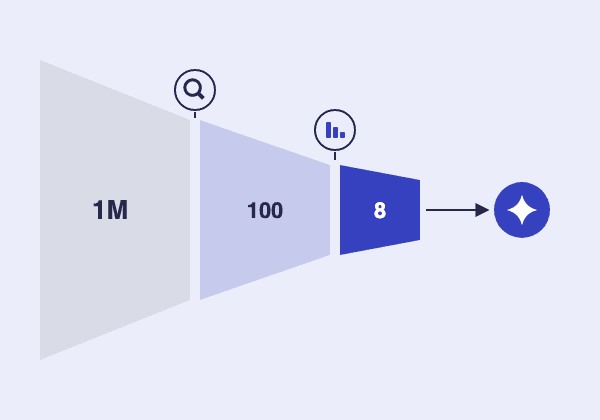
Retrieval דו-שלבי: קודם recall, אחר כך precision
כל שיטות ה-retrieval מהפרקים הקודמים מתוכננות להיות מהירות על מיליוני קטעים. הן משלמות על המהירות בדיוק: הוקטור של השאילתה ושל הקטע חושבו בנפרד, ו-BM25 רק סופר מילים. התוצאה היא שהקטע הנכון נמצא לרוב ב-top-50, אבל לא תמיד ב-top-5, ו-LLM מקבל רק את ה-top-5.
Reranking מפריד בין שני יעדים שמושכים לכיוונים שונים. השלב הראשון (candidate generation) אופטימלי ל-recall: הוא שולף הרבה מועמדים, 50 עד 100, בזול ובמהירות, והמטרה היחידה שלו היא שהקטע הנכון יהיה אי שם ברשימה. השלב השני (reranking) אופטימלי ל-precision: מודל מדויק ויקר בהרבה מדרג מחדש רק את המועמדים האלה, ובוחר את ה-5 עד 10 הטובים ביותר.
המבנה הזה קובע כלל חשוב לכיוונון: ה-recall@N של השלב הראשון הוא התקרה של המערכת כולה. reranker לא יכול להעלות קטע שלא נשלף. לכן מודדים את שני השלבים בנפרד (פרק 10). אם הקטע הנכון לא נמצא ב-top-100, הבעיה ב-retrieval ולא ב-reranker, וההפך.
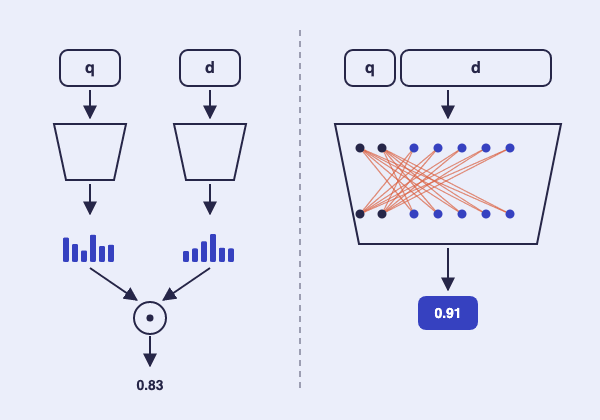
Bi-encoder מול Cross-encoder
מודל ה-embedding שבו השתמשנו עד עכשיו הוא bi-encoder: השאילתה והקטע עוברים במודל כל אחד בנפרד, כל אחד הופך לוקטור, והדמיון הוא מכפלה פנימית. זה מה שמאפשר לחשב מראש את וקטורי כל הקטעים ולאנדקס אותם. המחיר הוא שהמודל לעולם לא רואה את השאילתה והקטע יחד. כל מה שהוא יודע על הקטע חייב להידחס לוקטור אחד, עוד לפני שהוא יודע איזו שאלה תישאל.
Cross-encoder עובד אחרת: הוא מקבל את השאילתה ואת הקטע כקלט אחד משורשר, מעביר אותם יחד דרך ה-transformer, ומוציא ציון רלוונטיות יחיד. מכיוון שה-attention פועל על שניהם יחד, כל טוקן בשאילתה 'רואה' כל טוקן בקטע. המודל יכול לזהות שהקטע מדבר על E-4031 ולא על E-4032, שהשלילה הופכת את המשמעות, או שהקטע עונה בדיוק על מה שנשאל ולא רק מדבר על אותו נושא.
המחיר הוא שאין מה לחשב מראש. הציון תלוי בזוג, ולכן כל שאילתה דורשת מעבר מלא של המודל על כל מועמד. על מיליון קטעים זה בלתי אפשרי, ועל 50 מועמדים זה עשרות עד מאות מילישניות. זו בדיוק הסיבה שה-cross-encoder משמש כשלב שני ולא כשלב ראשון.
Late interaction: ColBERT
ColBERT (Khattab ו-Zaharia, 2020) הוא דרך ביניים בין שני הקצוות. במקום וקטור אחד לכל קטע, הוא שומר וקטור לכל טוקן בקטע, ומחשב אותם מראש כמו bi-encoder. בזמן השאילתה מחשבים וקטור לכל טוקן בשאילתה. הציון מחושב עם MaxSim: לכל טוקן בשאילתה מוצאים את טוקן הקטע הכי דומה לו, ומסכמים את הדמיון המקסימלי על פני כל טוקני השאילתה.
התוצאה היא התאמה ברמת הטוקן, קרובה יותר לדיוק של cross-encoder, עם ייצוגי קטעים שעדיין מחושבים מראש. החיסרון הוא אחסון: וקטור לכל טוקן במקום לכל קטע הוא פי כמה מאות יותר וקטורים. גרסאות מאוחרות יותר, כמו ColBERTv2, מוסיפות דחיסה אגרסיבית בגלל זה. ColBERT יכול לשמש גם כ-retriever ראשון וגם כ-reranker על מועמדים ששלף שלב אחר, והתמיכה בו במסדי הנתונים הולכת וגדלה.
LLM כ-reranker
אפשר להשתמש ב-LLM כללי כ-reranker, וזה נותן את הגמישות הגדולה ביותר: אפשר להסביר לו בשפה טבעית מה נחשב רלוונטי בדומיין שלכם. יש שלוש גישות עיקריות. Pointwise: כל קטע נשלח בנפרד עם השאלה, והמודל מחזיר ציון (למשל 0 עד 10). Pairwise: המודל משווה בין שני קטעים בכל פעם. Listwise: המודל מקבל את כל רשימת המועמדים עם מזהים ומחזיר את הסדר שלהם.
Pointwise פשוט ומקבילי, אבל ציונים של LLM בסקאלה מספרית לא מכוילים היטב, ויש הרבה 'תיקו'. Listwise מנצל את היכולת של המודל להשוות, אבל רגיש למיקום: מועמדים שמופיעים ראשונים ברשימה נוטים לקבל עדיפות. רשימות ארוכות מעובדות בחלונות חופפים (sliding window). בכל מקרה, זו קריאת LLM מלאה על כל המועמדים, ולכן הרבה יותר איטית ויקרה מ-cross-encoder ייעודי.
המקום הטבעי ל-LLM reranker הוא כשאין cross-encoder טוב לשפה או לדומיין, כשהרלוונטיות תלויה בהיגיון מורכב, או כשלב שלישי על קבוצה קטנה מאוד. בשאר המקרים, cross-encoder ייעודי הוא בדרך כלל ה-trade-off הטוב יותר.
מודלים ו-APIs ל-reranking
בפועל יש שתי אפשרויות עיקריות. הראשונה היא rerank API מתארח. כמה ספקי embedding מציעים endpoint ייעודי שמקבל שאילתה ורשימת מסמכים ומחזיר ציון לכל מסמך. השנייה היא cross-encoder בקוד פתוח שמריצים בעצמכם. יש כמה משפחות מוכרות של מודלים כאלה, חלקן רב-לשוניות.
שיקולי הבחירה דומים לאלה של מודל ה-embedding בפרק 4: תמיכה בעברית (שוב, חובה לבדוק, לא להניח), אורך קלט מקסימלי (קטעים ארוכים מהמגבלה נחתכים, ולרוב בשקט), latency לכל batch, ועלות. שוב, המבחן היחיד שקובע הוא ה-eval set שלכם. reranker שמוביל ב-benchmark באנגלית עלול לא לעזור בכלל, ואפילו להזיק, על מסמכים עבריים בדומיין צר.
תקציב latency, מספר מועמדים ו-cutoff
זמן ה-reranking גדל בערך ליניארית עם מספר המועמדים ועם אורכם. זה הפרמטר העיקרי לכיוונון. מספר קטן מדי של מועמדים (20) משאיר recall על השולחן. מספר גדול מדי (300) מוסיף latency בלי שיפור, כי הקטעים שבמקומות 200 עד 300 כמעט אף פעם לא הנכונים. הדרך לבחור היא למדוד על ה-eval set את recall@N של השלב הראשון לכמה ערכי N, ולבחור את הנקודה שבה העקומה מתיישרת.
יתרון גדול של reranker הוא שהציונים שלו מכוילים טוב יותר מציוני ה-retrieval. הוא מעריך את הזוג שאילתה-קטע ישירות, ולכן סף על ציון ה-reranker הגיוני יותר מסף cosine (פרק 5). אפשר להשתמש בו כדי להעביר ל-LLM מספר משתנה של קטעים: שמונה כשיש הרבה חומר רלוונטי, שניים כשיש מעט, ואפס כשאין. זה הבסיס לסירוב מבוסס בפרק הבא. גם כאן, הסף מכויל על eval set ושייך למודל ספציפי.
const CANDIDATES = 80;       // tune: where first-stage recall@N plateaus
const MAX_CONTEXT_CHUNKS = 8;
const RERANK_MIN_SCORE = 0.3; // calibrate on your eval set; model-specific

async function retrieveAndRerank(query: string, filter: Filter): Promise<RankedHit[]> {
  // Stage 1: high recall, cheap
  const candidates = await hybridSearch(query, CANDIDATES, filter);
  if (candidates.length === 0) return [];

  // Stage 2: high precision, expensive: one cross-encoder pass per (query, candidate)
  const scores = await reranker.score({
    query,
    documents: candidates.map((c) => c.text),
  });

  return candidates
    .map((hit, i) => ({ ...hit, rerankScore: scores[i] }))
    .sort((a, b) => b.rerankScore - a.rerankScore)
    .filter((hit) => hit.rerankScore >= RERANK_MIN_SCORE)
    .slice(0, MAX_CONTEXT_CHUNKS);
}