מרחב רב-ממדי וקללת הממדיות
מה זה בכלל "רב-ממדי" בפרקטיקה?
האינטואיציה הגיאומטרית שלנו — "קרוב" ו"רחוק", "כיוון", "זווית" — מגיעה מעולם דו-ממדי או תלת-ממדי, שבו אפשר לצייר ולדמיין. embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. אמיתיים חיים במרחב של מאות ועד כמה אלפי מימדים בו-זמנית.
כל הנוסחאות שראינו בפרק הקודם — מכפלה סקלריתסכום מכפלות הרכיבים המקבילים של שני וקטורים; גדולה כשהם מצביעים לאותו כיוון וגם ארוכים. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים., נורמה, דמיון קוסינוסהמכפלה הסקלרית של שני וקטורים מחולקת במכפלת הנורמות שלהם: מדד שתלוי רק בכיוון, לא באורך. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים., מרחק אוקלידיאורך וקטור ההפרש בין שני וקטורים; בניגוד לדמיון קוסינוס, הוא רגיש גם לגודל שלהם. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים. — מוגדרות באופן זהה לחלוטין ללא תלות במספר המימדים; מבחינה אלגברית טהורה, אין שום בעיה לחשב אותן על וקטור בן 1,536 מימדים בדיוק כמו על וקטור דו-ממדי. הבעיה שמתעוררת היא לא אלגברית אלא גיאומטרית-סטטיסטית: ההתנהגות של המרחקים עצמם משתנה באופן דרמטי ככל שהממדיות גדלה.
קללת הממדיות (Curse of Dimensionality)
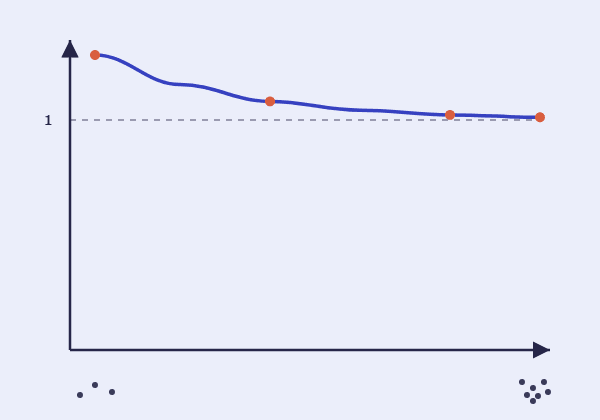
התופעה המרכזית: ככל שמספר המימדים גדל, ההבדל היחסי בין המרחק לשכן הקרוב ביותר לבין המרחק לשכן הרחוק ביותר הולך ומצטמצם — במימדים גבוהים מספיק, היחס בין שני המרחקים האלה שואף ל-1. במילים אחרות: כמעט כל הנקודות נעשות "בערך באותו מרחק" זו מזו, וההבדל שמבדיל שכן קרוב באמת משכן רחוק הופך קטן ועדין יותר ויותר.
הסיבה האינטואיטיבית: בכל מימד נוסף יש עוד "כיוון" שבו נקודות יכולות להתפזר ולהתרחק זו מזו. במרחב דו-ממדי שתי נקודות אקראיות עשויות להיות קרובות במקרה; במרחב בן אלף מימדים, כמעט בלתי אפשרי ששתי נקודות אקראיות יהיו קרובות בכל המימדים בו-זמנית — כך שהמרחקים בין נקודות אקראיות מתכנסים לטווח ערכים צר יחסית.
למה זה חשוב לחיפוש וקטורי בפועל
כשההבדל בין "קרוב" ל"רחוק" מצטמצם, כל שיטת חיפוש שמתבססת על סריקה גולמית וחישוב מרחק מדויק לכל פריט (brute-forceחיפוש מדויק שמחשב את המרחק מהשאילתה לכל וקטור בבסיס הנתונים וממיין; מדויק לחלוטין, אבל ליניארי בגודל הנתונים. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN). / exact k-Nearest Neighbors) נעשית גם יקרה חישובית וגם פחות ופחות "בטוחה" מבחינת איכות התוצאה ביחס למאמץ — ככל שהממדיות עולה, ההבדל בין השכן ה-1 לשכן ה-100 עשוי להיות קטן יחסית, כך שגם חיפוש שמפספס מעט עדיין מחזיר תוצאות סבירות.
זו בדיוק הסיבה שהתעשייה לא סורקת את כל בסיס הנתונים ומחשבת מרחק מדויק לכל פריט בכל שאילתה, במיוחד כשמדובר במיליוני או מיליארדי וקטורים. הפרקים הבאים עוסקים באלגוריתמים שמוותרים במכוון על דיוק מוחלט (מציאת השכן הקרוב ביותר האמיתי, בוודאות) בתמורה למהירות עצומה — חיפוש מקורב (Approximate Nearest Neighborחיפוש שמוותר על הבטחת דיוק מוחלט בתמורה למהירות גבוהה בסדרי גודל, בעזרת אינדקס שנבנה מראש. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN)., ANN) — ומדוע הוויתור הזה כמעט תמיד משתלם בפרקטיקה.
אז למה לא פשוט מגדילים את מספר המימדים עוד ועוד?
יותר מימדים מאפשרים תיאורטית ללכוד ניואנסים עדינים יותר של משמעות, אך המחיר עולה יחד איתם: כל וקטור נוסף תופס יותר מקום באחסון, כל חישוב דמיון נעשה יקר יותר (הסכומים בנוסחאות שראינו גדלים ליניארית עם מספר המימדים), וקללת הממדיותככל שמספר הממדים גדל, המרחק לשכן הקרוב והמרחק לשכן הרחוק מתקרבים זה לזה, וכמעט כל הנקודות נעשות "באותו מרחק". מתוך Vector Search, מרחב רב-ממדי וקללת הממדיות. עצמה עובדת נגד התועלת השולית של כל מימד נוסף — מעבר לנקודה מסוימת, מימדים נוספים תורמים פחות ופחות איכות ייצוג ביחס לעלות שהם מוסיפים.
בפועל, ספקי מודלים בוחרים ממד מסוים כפשרה מכוונת בין איכות הייצוג לעלות, ולעיתים אף מציעים גרסאות "מקוצרות" של אותו embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. (פחות מימדים, פגיעה קלה באיכות, חיסכון משמעותי במקום ובזמן חישוב) לשימושים שבהם המהירות קריטית יותר מהדיוק המרבי.
שאלות נפוצות
אם המרחקים מתכנסים במימדים גבוהים, איך חיפוש וקטורי עובד בכלל?
קללת הממדיות מתארת בעיקר נקודות אקראיות שמפוזרות באופן אחיד במרחב. embeddings אמיתיים אינם כאלה: הם מתרכזים על מבנה בעל ממד פנימי נמוך בהרבה, ותוכן דומה מתקבץ יחד. לכן ההבדל בין שכן קרוב באמת לבין שאר הנקודות נשאר משמעותי מספיק כדי לדרג תוצאות.
אפשר פשוט לחתוך את הוקטור לפחות מימדים כדי לחסוך מקום?
בוקטור רגיל — לא, כי המידע מפוזר על כל הרכיבים וחיתוך שרירותי פוגע באיכות. חלק מהמודלים אומנו במיוחד כך שהרכיבים הראשונים נושאים את רוב המידע (Matryoshka Representation Learning), ובהם מותר לחתוך לממד קטן יותר ולנרמל מחדש. אלה בדיוק הגרסאות ה"מקוצרות" שהוזכרו בפרק. בכל מקרה אחר עדיף לבחור מודל עם ממד קטן יותר.
כמה מימדים כדאי לבחור?
בדרך כלל לא בוחרים מספר אלא מודל, והממד מגיע איתו. אם המודל מציע כמה גדלים, התחילו מהקטן ומדדו recall על שאילתות אמיתיות. עברו לגדול רק אם השיפור באיכות מצדיק את עלות האחסון והחישוב, שגדלה ליניארית עם מספר המימדים.