אינדקסים מבוססי גרפים — HNSW
מהו HNSW?
HNSW — ראשי תיבות של Hierarchical Navigable Small World — הוא אחד מאלגוריתמי ה-ANNחיפוש שמוותר על הבטחת דיוק מוחלט בתמורה למהירות גבוהה בסדרי גודל, בעזרת אינדקס שנבנה מראש. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN). הנפוצים והמוצלחים ביותר בפרקטיקה, והאינדקס המובנה כברירת מחדל ברוב מסדי הנתונים הווקטוריים המובילים. הרעיון המרכזי: לארגן את כל הוקטורים כגרף רב-שכבתי (multi-layer graph), שבו כל וקטור הוא צומת (node), וצמתים קרובים זה לזה במרחב מחוברים בקשתות (edges).
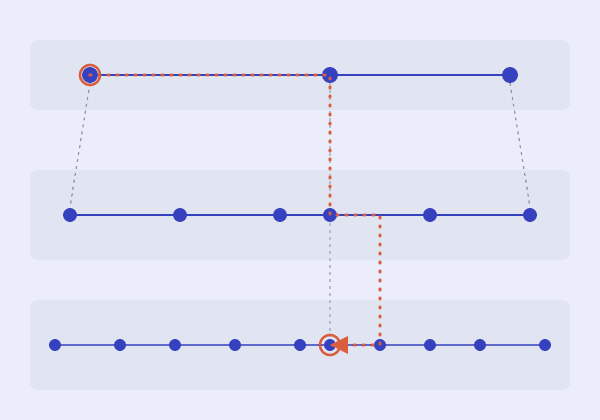
המבנה הרב-שכבתי הוא הלב של האלגוריתם: השכבה העליונה דלילה — מעט מאוד צמתים, עם קשתות "קפיצה גדולה" למרחקים ארוכים במרחב. כל שכבה מתחתיה צפופה יותר, עד לשכבה התחתונה שמכילה את כל הווקטורים ואת רוב הקשתות "המקומיות" קצרות הטווח. אפשר לדמיין זאת כמפת דרכים: כביש בין-עירוני מהיר בשכבה העליונה, וכבישים מקומיים הולכים ומתפצלים ככל שיורדים שכבה.
איך מתבצע חיפוש בגרף
החיפוש מתחיל בנקודת כניסה קבועה בשכבה העליונה (הדלילה ביותר). מהנקודה הזו, האלגוריתם עובר בצורה חמדנית (greedy) לשכן הקרוב ביותר לשאילתה מבין שכני הצומת הנוכחי, וממשיך כך שוב ושוב כל עוד נמצא שכן קרוב יותר לשאילתה מהצומת הנוכחי באותה שכבה.
כשאין יותר שכן קרוב יותר בשכבה הנוכחית, האלגוריתם "יורד" שכבה אחת למטה, ומתחיל שוב את אותו תהליך חיפוש חמדני משם — הפעם בגרף צפוף יותר, עם קשתות קצרות וממוקדות יותר. התהליך חוזר על עצמו עד השכבה התחתונה, שבה מתקבלים המועמדים הסופיים לתשובה.
ההשוואה המדויקת ביותר היא לרשימת דילוג (skip list): קודם קופצים קפיצות גדולות שמצמצמות מהר את המרחב הרלוונטי לחיפוש, ורק לקראת הסוף עוברים לחיפוש עדין ומדויק באזור הקטן שכבר אותר.
למה זה מהיר — אינטואיציה לסיבוכיות
בניגוד לסריקת brute-forceחיפוש מדויק שמחשב את המרחק מהשאילתה לכל וקטור בבסיס הנתונים וממיין; מדויק לחלוטין, אבל ליניארי בגודל הנתונים. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN). שבודקת כל וקטור בבסיס הנתונים (סיבוכיות ליניארית, O(n)), החיפוש בגרף HNSWאלגוריתם ANN שמארגן את הוקטורים כגרף רב-שכבתי: שכבות עליונות דלילות לקפיצות ארוכות, ותחתונות צפופות לחיפוש מקומי. מתוך Vector Search, אינדקסים מבוססי גרפים — HNSW. "מדלג" על רוב הצמתים לגמרי — כל שכבה מצמצמת את מרחב החיפוש הרלוונטי משמעותית לפני שממשיכים לשכבה הבאה, מה שנותן לחיפוש סיבוכיות שקרובה ללוגריתמית ביחס לגודל בסיס הנתונים (בערך O(log n)) במקום ליניארית.
בפועל המשמעות היא ששאילתה על בסיס נתונים בגודל מיליון וקטורים לא דורשת מיליון חישובי מרחק, אלא רק שבר קטן מהם — שיפור דרמטי שמאפשר לחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. לפעול ב-latency של מילישניות בודדות גם בקנה מידה עצום.
המחיר: זיכרון וזמן בנייה
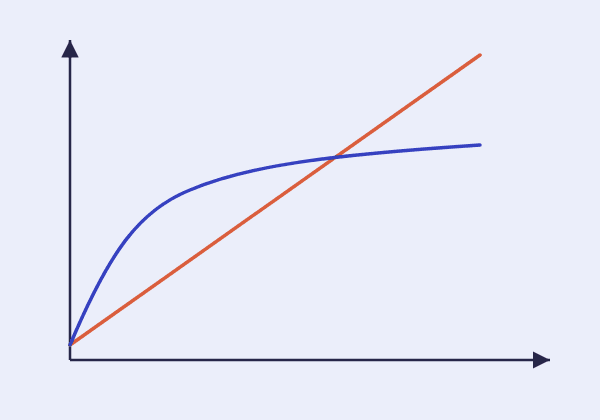
היתרון של HNSWאלגוריתם ANN שמארגן את הוקטורים כגרף רב-שכבתי: שכבות עליונות דלילות לקפיצות ארוכות, ותחתונות צפופות לחיפוש מקומי. מתוך Vector Search, אינדקסים מבוססי גרפים — HNSW. אינו חינם. הגרף עצמו — לא רק הווקטורים הגולמיים — חייב להישמר בזיכרון: כל צומת שומר רשימת קשתות (שכנים) בכל שכבה שהוא משתתף בה, כך שהאינדקס תופס משמעותית יותר זיכרון ממה שהוקטורים הגולמיים היו תופסים לבדם.
גם בניית האינדקס אינה זניחה: הוספת כל וקטור חדש דורשת "לחווט" אותו לתוך הגרף — למצוא את השכנים המתאימים לו בכל שכבה שהוא ישתתף בה ולעדכן את הקשתות סביבו — כך שזמן בנייה גדל עם גודל בסיס הנתונים, ואינדקסים עצומים עשויים לקחת זמן משמעותי לבנייה מלאה.
הטרייד-אוף הזה — ביצועי חיפוש מצוינים במחיר זיכרון — הוא בדיוק מה שמניע גישה חלופית: אינדקסים מבוססי קוונטיזציההחלפת ערך מדויק בערך קרוב מתוך קבוצה קטנה וקבועה של ערכים מותרים: חוסכת זיכרון במחיר איבוד מסוים של דיוק. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ., שדוחסים את הוקטורים עצמם כדי לחסוך בזיכרון במחיר מסוים בדיוק. זה הנושא של הפרק הבא.
שאלות נפוצות
אילו פרמטרים קובעים את הביצועים של HNSW?
יש שלושה עיקריים. M הוא מספר השכנים שכל צומת מחובר אליהם: ערך גבוה משפר recall אבל צורך יותר זיכרון. ef_construction קובע כמה מועמדים נבדקים בזמן הבנייה: ערך גבוה נותן גרף איכותי יותר ובנייה איטית יותר. ef_search (נקרא לפעמים ef) קובע כמה מועמדים נשמרים בזמן שאילתה, וזה הפרמטר שמכוונים כדי לאזן בין recall ל-latency בלי לבנות את האינדקס מחדש.
מה קורה כשמוחקים וקטור מגרף HNSW?
מחיקה בגרף מסובכת, כי הצומת משמש גשר במסלולי החיפוש של צמתים אחרים. לכן מימושים רבים רק מסמנים את הצומת כמחוק ומסננים אותו מהתוצאות, ומנקים או בונים מחדש מדי פעם. הרבה מחיקות ועדכונים לאורך זמן עלולים להוריד את ה-recall, ולכן כדאי למדוד אותו מחדש מעת לעת.
האם אינדקס HNSW חייב להיות כולו בזיכרון RAM?
בצורתו הקלאסית — כן. החיפוש קופץ בין צמתים בסדר שלא ניתן לחזות מראש, וגישה כזו לדיסק איטית מאוד. כשהזיכרון לא מספיק, משלבים את HNSW עם קוונטיזציה (הנושא של הפרק הבא), או בוחרים אינדקסים שתוכננו במיוחד לעבודה מהדיסק, כמו DiskANN.