הערכת ביצועים, Hybrid Search ומגמות עתידיות
הערכת ביצועים: Recall, Latency וזיכרון יחד
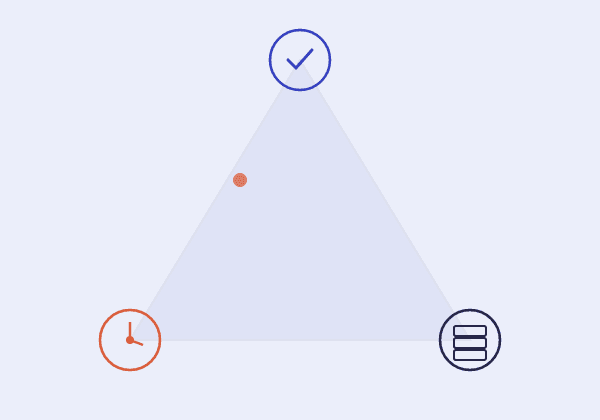
recall@kאיזה אחוז מתוך k השכנים הקרובים האמיתיים חיפוש מקורב אכן החזיר; המדד הסטנדרטי לאיכות ANN. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN)., שהוצג בפרק העוסק ב-kNNחיפוש מדויק שמחשב את המרחק מהשאילתה לכל וקטור בבסיס הנתונים וממיין; מדויק לחלוטין, אבל ליניארי בגודל הנתונים. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN). מול ANNחיפוש שמוותר על הבטחת דיוק מוחלט בתמורה למהירות גבוהה בסדרי גודל, בעזרת אינדקס שנבנה מראש. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN)., נמדד בפועל על קבוצת שאילתות מייצגת (curated או held-out), מול תוצאות exact search כאמת מידה. אבל recall לבדו לא מספיק כדי להעריך מערכת חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. — צריך למדוד אותו יחד עם latency וצריכת זיכרון, כי שלושת הגורמים האלה תלויים זה בזה במלואם.
latency נמדד בדרך כלל לא רק כממוצע, אלא בפרסנטילים — p50 (latency חציוני), p95 ו-p99 (latency של המקרים הגרועים יחסית) — כי שאילתה בודדת איטית במיוחד יכולה לפגוע בחוויית משתמש גם אם הממוצע נראה טוב. הבחירה בין HNSWאלגוריתם ANN שמארגן את הוקטורים כגרף רב-שכבתי: שכבות עליונות דלילות לקפיצות ארוכות, ותחתונות צפופות לחיפוש מקומי. מתוך Vector Search, אינדקסים מבוססי גרפים — HNSW., IVFאינדקס שמחלק מראש את הוקטורים לתאים לפי צנטרואידים, ובזמן שאילתה סורק לעומק רק את התאים הקרובים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ. ו-IVF-PQשילוב של IVF שמצמצם את מרחב החיפוש עם PQ שדוחס את הוקטורים; החסכוני ביותר בזיכרון, במחיר מסוים ב-recall. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ. (שנסקרו בפרקים הקודמים) היא בדיוק בחירת נקודה במרחב התלת-ממדי הזה — recall, latency וזיכרון — ואין קונפיגורציה שממקסמת את שלושתם בו-זמנית.
Hybrid Search: שילוב חיפוש וקטורי וחיפוש מילות מפתח
חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. מצוין בתפיסת דמיון סמנטי, אך חלש דווקא במקרים שבהם חיפוש מילות מפתח קלאסי (כמו BM25אלגוריתם הדירוג הלקסיקלי הסטנדרטי, שנותן משקל גבוה למונחים נדירים במאגר (IDF). מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים.) מצטיין: התאמה מדויקת של מק"ט מוצר, שם ספציפי, או מונח טכני נדיר — מונחים כאלה לא בהכרח מקבלים embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. שמבדיל אותם היטב ממונחים דומים, בעוד שחיפוש מילות מפתח פשוט מוצא אותם ישירות.
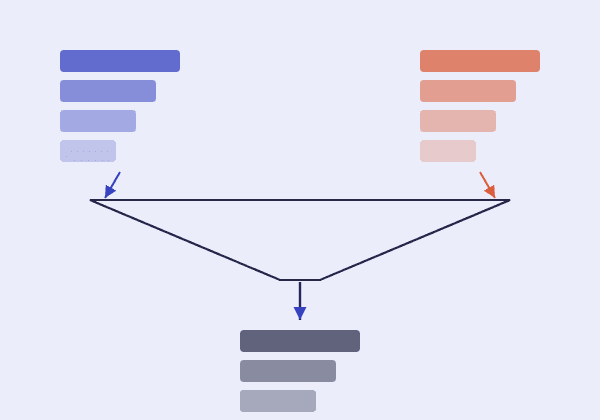
הפתרון הנפוץ הוא Hybrid Search: הרצת שני סוגי החיפוש במקביל — וקטורי וטקסטואלי — ומיזוג התוצאות לדירוג אחד משולב. שיטה מקובלת למיזוג נקראת Reciprocal Rank Fusionאיחוד כמה רשימות תוצאות לפי הדירוג בלבד: כל מסמך מקבל 1/(k + rank) מכל רשימה, והציונים מסוכמים. מתוך RAG, Retrieval — שליפת הקטעים הרלוונטיים. (RRF): במקום להשוות ציוני דמיון גולמיים משיטות שונות (שלא ניתנים להשוואה ישירה), משלבים את הדירוגים (המיקום ברשימה) של כל פריט בכל אחת מהרשימות, כך שפריט שמדורג טוב בלפחות אחת מהשיטות מקבל דירוג משולב גבוה — גם אם הוא לא הופיע כלל ברשימה השנייה.
לאן זה הולך: כיוונים נוכחיים
אחד הכיוונים הפעילים בתחום הוא מעבר מ-embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. יחיד למסמך לגישות multi-vector / late-interaction, שבהן כל מסמך מיוצג ע"י כמה וקטורים (למשל אחד לכל טוקןהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM. או קטע קטן) במקום וקטור בודד — מה שמאפשר ייצוג עשיר ומדויק יותר, במחיר עלות אחסון וחישוב גבוהה יותר. זהו כיוון מחקר ותעשייה פעיל, לא סטנדרט אחיד עדיין.
מגמה יציבה יותר: RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG., כפי שהוצג בפרק הראשון של הנושא, ממשיך להיות הכוח המניע המרכזי מאחורי הביקוש לחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. מהיר ומדויק — ככל שיישומי LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI. דורשים גישה לידע עדכני ופרטי בקנה מידה גדול, כך גדלה החשיבות של כל מה שנלמד בנושא הזה: embeddings איכותיים, מדדי דמיון נכונים, ואינדקסים שמתפקדים היטב תחת עומס אמיתי.
סיכום הנושא
התחלנו בפרק הראשון עם עיקרון פשוט: חיפוש לפי משמעות, לא לפי התאמת מחרוזת. מאז עברנו דרך embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. כדרך לייצג משמעות כמספרים, המתמטיקה המדויקת שמגדירה "קרוב" במרחב הזה, האתגר שהממדיות הגבוהה מציבה, האלגוריתמים (HNSWאלגוריתם ANN שמארגן את הוקטורים כגרף רב-שכבתי: שכבות עליונות דלילות לקפיצות ארוכות, ותחתונות צפופות לחיפוש מקומי. מתוך Vector Search, אינדקסים מבוססי גרפים — HNSW., IVFאינדקס שמחלק מראש את הוקטורים לתאים לפי צנטרואידים, ובזמן שאילתה סורק לעומק רק את התאים הקרובים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ., PQדחיסת וקטורים: מפצלים כל וקטור לתת-וקטורים ומחליפים כל אחד באינדקס של הצנטרואיד הקרוב אליו בספר קודים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ.) שהופכים חיפוש בקנה מידה עצום לישים, הכלים שמממשים את כל זה בפרקטיקה, ולבסוף איך בונים ומעריכים מערכת כזו בעולם האמיתי.
כל השכבות האלה יחד הן מה שהופך משפט כמו "מצא לי את הדבר שהכי דומה למשמעות לזה" מרעיון מעורפל לפעולה מחושבת, מהירה ומדידה.
שאלות נפוצות
איך בונים סט שאילתות להערכה כשאין תיוג מוכן?
כדי למדוד את ה-recall של האינדקס לא צריך תיוג אנושי: exact search על אותן שאילתות הוא אמת המידה. כדי לבדוק אם התוצאות באמת רלוונטיות למשתמש, צריך תיוג — מתחילים מכמה עשרות שאילתות אמיתיות מהלוגים, מסמנים אילו מסמכים רלוונטיים לכל אחת, ומרחיבים את הסט בהדרגה.
איך בדיוק מחושב הציון ב-Reciprocal Rank Fusion?
כל פריט מקבל 1/(k + rank) מכל רשימה שבה הוא מופיע, כאשר rank הוא המיקום שלו ברשימה, והציונים מכל הרשימות מסוכמים. הקבוע k (ערך מקובל הוא 60, וזה לא ה-k של top-k) ממתן את הפער בין המקומות הראשונים: k גדול נותן משקל דומה יותר למיקומים שונים, ו-k קטן מעניק יתרון חזק יותר למקום הראשון.
מתי Hybrid Search לא שווה את המורכבות?
כשהשאילתות כמעט תמיד בשפה חופשית ואין בהן מזהים מדויקים, שמות או מונחים נדירים. במקרה כזה מנוע חיפוש נוסף מוסיף latency ותחזוקה בלי שיפור ממשי. הדרך לדעת היא למדוד: להריץ את סט ההערכה פעם עם חיפוש וקטורי לבד ופעם עם hybrid, ולבדוק אם הרלוונטיות באמת השתפרה.