קוונטיזציה ואינדקסים מבוססי IVF/PQ
IVF — Inverted File Index
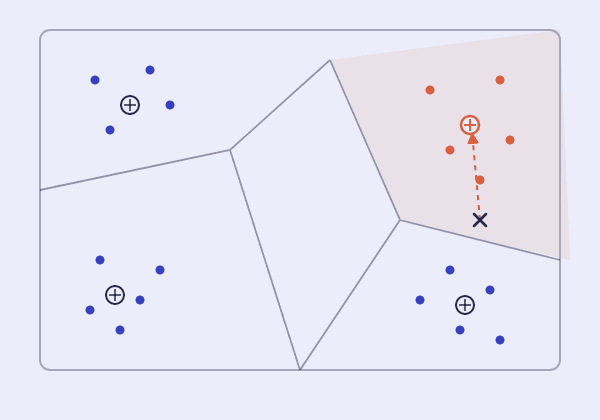
הרעיון של IVF: לפני שמגיעה אפילו שאילתה אחת, מחלקים את כל הוקטורים בבסיס הנתונים למספר קבוע של "תאים" (clusters), בדרך כלל באמצעות אלגוריתם k-means — כל תא מיוצג ע"י צנטרואיד (centroid), הממוצע של כל הוקטורים שהוקצו אליו.
בזמן שאילתה, במקום להשוות את השאילתה מול כל וקטור בבסיס הנתונים, משווים אותה קודם רק מול הצנטרואידים — מוצאים את כמה התאים שהצנטרואיד שלהם הכי קרוב לשאילתה — וסורקים לעומק רק את הוקטורים שבתוך התאים הנבחרים האלה. כך נחסכת רוב העבודה: אין צורך להשוות מול וקטורים שבתאים רחוקים לגמרי מהשאילתה.
הפרמטר המרכזי שקובע את הטרייד-אוף כאן נקרא nprobe — מספר התאים שנסרקים בפועל בכל שאילתה. nprobe גבוה יותר בודק יותר תאים, מה שמשפר את הסיכוי למצוא את השכנים האמיתיים (recall גבוה יותר) אך מאט את השאילתה; nprobe נמוך מהיר יותר אך מסתכן בפספוס שכנים אמיתיים שנפלו בתא שלא נבדק.
מה זו קוונטיזציה, ו-Product Quantization (PQ)
קוונטיזציה (quantization) היא החלפה של ערך מדויק, שיכול לקבל אינסוף ערכים, בערך קרוב מתוך קבוצה קטנה וקבועה של ערכים מותרים. דוגמה מהיומיום: עיגול מחיר של 19.87 ₪ ל-20 ₪, או שמירת תמונה ב-256 צבעים במקום במיליוני גוונים. מאבדים קצת דיוק, אבל כל ערך תופס הרבה פחות מקום, כי צריך לזכור רק איזה מבין הערכים המותרים נבחר.
אצל וקטורים, הבעיה שהקוונטיזציה פותרת היא זיכרון. כל רכיב נשמר כ-float32, כלומר 4 בתים, ולכן וקטור באורך 1,536 תופס כ-6 קילובייט, ומיליון וקטורים כאלה תופסים כ-6 גיגה-בייט. הצורה הפשוטה ביותר, scalar quantization, מטפלת בכל רכיב בנפרד. נניח שערכי הרכיבים נעים בין -1 ל-1: מחלקים את הטווח ל-256 מדרגות שוות, ולכל רכיב שומרים רק את מספר המדרגה הקרובה אליו (0 עד 255), שנכנס בבית אחד במקום ארבעה. למשל, הערך 0.4137 נשמר כמדרגה 180, ובשחזור הוא הופך לכ-0.412: קרוב, אבל לא זהה. התוצאה היא חיסכון של פי 4 בזיכרון, והמרחקים מחושבים על קירוב קרוב מאוד של הוקטור המקורי.
זה העיקרון המשותף לכל שיטות הקוונטיזציה: מחליפים ערכים מדויקים באינדקס של "נציג" קרוב מתוך קבוצה קבועה, ומשלמים על החיסכון בזיכרון באיבוד מסוים של דיוק. למעשה, גם IVFאינדקס שמחלק מראש את הוקטורים לתאים לפי צנטרואידים, ובזמן שאילתה סורק לעומק רק את התאים הקרובים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ. מהסעיף הקודם עושה קוונטיזציה גסה: כל וקטור משויך לצנטרואיד הקרוב אליו, כלומר מיוצג (לצורך בחירת התאים) ע"י אחד מתוך מספר קטן של נציגים. Product Quantization (PQ) לוקח את אותו רעיון צעד קדימה: במקום לעגל כל מספר בנפרד, הוא "מעגל" קבוצות שלמות של מספרים בבת אחת.
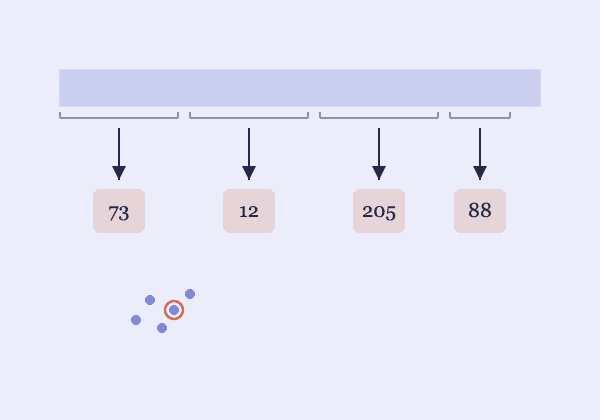
PQ פותר בעיה שונה מ-IVF: לא אילו וקטורים להשוות, אלא איך לאחסן ולהשוות אותם בזול יותר. הרעיון: מפצלים כל וקטור למספר תת-וקטורים קצרים (למשל וקטור באורך 1,536 מתחלק ל-96 תת-וקטורים באורך 16 כל אחד), ועבור כל "עמדה" של תת-וקטור לומדים בנפרד, מראש וע"י clustering, ספר קודים (codebook) קטן — קבוצה קבועה של צנטרואידים מייצגים (למשל 256 כאלה).
אחרי הלמידה, כל תת-וקטור מוחלף באינדקס הצנטרואיד הקרוב אליו בספר הקודים שלו — מספר שלם קטן אחד (בין 0 ל-255, למשל, שניתן לאחסון בבית בודד) במקום רשימת מספרים עשרוניים. זו בדיוק הדחיסה: וקטור באורך 1,536 מספרי float32 (כ-6 קילובייט) יכול להצטמצם, להמחשה, לכמה עשרות בתים בלבד — שיפור דרמטי בזיכרון, במחיר איבוד מדויק (lossy compression): הוקטור המדוחס הוא קירוב, לא שחזור מדויק, של הוקטור המקורי.
IVF-PQ: השילוב הנפוץ בפרקטיקה
בפועל, IVFאינדקס שמחלק מראש את הוקטורים לתאים לפי צנטרואידים, ובזמן שאילתה סורק לעומק רק את התאים הקרובים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ. ו-PQדחיסת וקטורים: מפצלים כל וקטור לתת-וקטורים ומחליפים כל אחד באינדקס של הצנטרואיד הקרוב אליו בספר קודים. מתוך Vector Search, קוונטיזציה ואינדקסים מבוססי IVF/PQ. כמעט תמיד משולבים יחד, בשיטה שנקראת IVF-PQ: IVF מצמצם קודם את מרחב החיפוש לכמה תאים רלוונטיים בלבד, ו-PQ דוחס את הוקטורים בתוך התאים האלה כך שגם ההשוואה בתוכם זולה בזיכרון ובחישוב. השילוב הזה נועד בדיוק כדי לפתור את חולשת הזיכרון של HNSWאלגוריתם ANN שמארגן את הוקטורים כגרף רב-שכבתי: שכבות עליונות דלילות לקפיצות ארוכות, ותחתונות צפופות לחיפוש מקומי. מתוך Vector Search, אינדקסים מבוססי גרפים — HNSW. שראינו בפרק הקודם, במחיר של ירידה מסוימת ב-recall שנובעת מהדחיסה החדה.
שלושת משפחות האינדקסים שנסקרו עד כה תופסות שלוש נקודות שונות במרחב הטרייד-אוף בין מהירות/דיוק לזיכרון: HNSW נותן את ה-recall והמהירות הטובים ביותר אך במחיר זיכרון הגבוה מכולם; IVF לבדו פשוט לבנייה ולהבנה, מהיר, וצורך זיכרון בינוני; IVF-PQ הוא החסכוני ביותר בזיכרון מבין השלושה, במחיר איבוד דיוק נוסף מהדחיסה. אין אינדקס אחד ש"מנצח" תמיד — הבחירה תלויה בגודל בסיס הנתונים, בתקציב הזיכרון ובדרישת ה-recall של המערכת הספציפית.
שאלות נפוצות
כמה תאים צריך לחלק אליהם את הוקטורים ב-IVF?
כלל אצבע נפוץ הוא סדר גודל של √n תאים עבור n וקטורים — למשל כאלף תאים למיליון וקטורים. יותר תאים פירושם תאים קטנים יותר וסריקה מהירה יותר בכל תא, אבל גם סיכוי גבוה יותר שהשכנים האמיתיים יתפזרו בין כמה תאים, ולכן צריך nprobe גבוה יותר כדי לשמור על אותו recall.
האם הדחיסה של PQ משנה את התוצאות הסופיות?
כן. המרחקים מחושבים על קירוב של הוקטורים, ולכן סדר התוצאות עלול להשתנות מעט. הפתרון הנפוץ הוא דירוג מחדש (re-ranking): מאחזרים בעזרת הוקטורים הדחוסים יותר מועמדים מ-k, ואז מחשבים מרחק מדויק מול הוקטורים המקוריים רק עבור המועמדים האלה.
האם יש שיטות קוונטיזציה פשוטות יותר מ-PQ?
כן. Scalar quantization, שתוארה למעלה, ממירה כל רכיב float32 למספר של 8 ביט — חיסכון של פי 4 בזיכרון עם פגיעה קטנה ב-recall. Binary quantization שומרת ביט אחד בלבד לכל רכיב — חיסכון של פי 32, ומשתמשים בה בעיקר יחד עם דירוג מחדש. מסדי נתונים וקטוריים רבים מציעים את שתיהן כאפשרות מובנית.