מסדי נתונים וקטוריים בפרקטיקה
שלוש דרכים להשתמש בחיפוש וקטורי בפועל
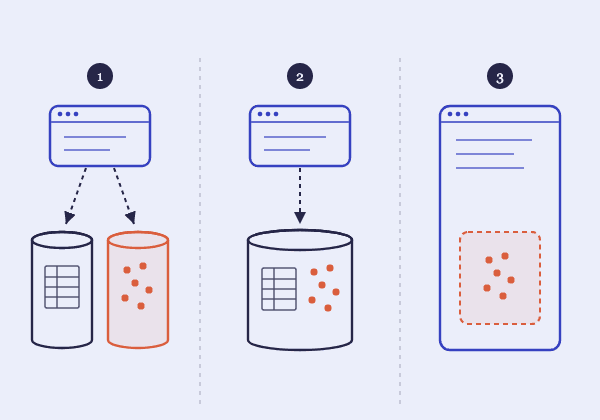
מסדי נתונים וקטוריים ייעודיים (dedicated vector databases) — מוצרים שנבנו במיוחד לחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. בקנה מידה גדול, כמו Pinecone, Weaviate, Qdrant ו-Milvus. הם מציעים אינדוקס, סקלביליות, וניהול תפעולי (backup, replication, ניטור) כשירות מובנה, בעלות ותשתית ייעודית לכך בלבד.
חיפוש וקטורי כתוסף למסד נתונים קיים — למשל pgvector עבור PostgreSQL, יכולות וקטוריות ב-Elasticsearch/OpenSearch, או MongoDB Atlas Vector Search. נוח מאוד כאשר הוקטורים "חיים" לצד דאטה שכבר נשאל בצורה רלציונית/טקסטואלית באותה מערכת — חוסך תשתית נפרדת ומאפשר שאילתות משולבות בקלות.
ספריות/כלים ברמת האפליקציה (in-process) — כמו FAISS או hnswlib. אלה לא "מסד נתונים" בפני עצמו אלא ספרייה שמוטמעת ישירות בתוך קוד האפליקציה, לרוב כשרוצים שליטה מלאה על האינדקס בלי להריץ שירות נפרד, או בקנה מידה קטן-בינוני שלא מצדיק תשתית ייעודית.
איך בוחרים בפועל?
תשתית קיימת — אם כבר יש Postgres או Elasticsearch בפרודקשן, תוסף וקטורי עליו לרוב יעיל יותר (פחות תשתית חדשה ללמוד ולתחזק) מהוספת מסד נתונים ייעודי חדש, גם אם לזה האחרון יש ביצועים מעט טובים יותר בוואקום.
קנה מידה — עשרות אלפי וקטורים מול מיליארדי וקטורים הם שתי בעיות הנדסיות שונות לגמרי; לא כל פתרון מתאים לשני הקצוות של הטווח הזה.
צורך בסינון לפי מטא-דאטה (filtered / hybrid searchהרצת חיפוש וקטורי וחיפוש מילות מפתח במקביל, ומיזוג התוצאות לדירוג אחד משולב. מתוך Vector Search, הערכת ביצועים, Hybrid Search ומגמות עתידיות.) — כמעט אף מערכת אמיתית לא רוצה "רק" את הפריטים הדומים ביותר וקטורית; לרוב רוצים "פריטים דומים, אבל רק כאלה שבמלאי", או "רק מהחודש האחרון". חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. משולב עם סינון קשיח לפי שדות מבני נקרא filtered/hybrid search, וזו דרישה מעשית כמעט תמיד — נרחיב עליה בפרק העוסק בהערכת ביצועים בהמשך הנושא.
עלות תפעולית — שירות מנוהל (managed) חוסך זמן הקמה ותחזוקה במחיר תלות בספק חיצוני ותשלום מתמשך; פתרון self-hosted נותן שליטה מלאה במחיר עומס תפעולי על הצוות. אין תשובה נכונה אחת — זו החלטה הנדסית תלוית-הקשר, לא רק שאלה של "מי הכי מהיר".
שאלות נפוצות
האם pgvector מספיק לפרודקשן?
לרוב המערכות בהיקף של עד מיליוני וקטורים — כן. הוא תומך באינדקסים HNSW ו-IVFFlat, ומאפשר לשלב חיפוש וקטורי עם JOIN, טרנזקציות ותנאי WHERE באותה שאילתה. מסד וקטורי ייעודי מתחיל להשתלם כשהקנה מידה, דרישות ה-latency או העומס התפעולי של הרחבת Postgres עצמו הופכים לבעיה.
איך עוברים ממסד וקטורי אחד לאחר בלי ליצור embeddings מחדש?
הוקטורים עצמם ניידים: הם רק מערכים של מספרים, וכל מסד מקבל אותם. מייצאים אותם יחד עם המזהים והמטא-דאטה וטוענים אותם ליעד, והאינדקס עצמו (הגרף או התאים) נבנה מחדש שם. לכן כדאי לשמור עותק של הוקטורים ושל הטקסט המקורי גם מחוץ למסד הוקטורי.
למה סינון לפי מטא-דאטה מסובך באינדקס ANN?
אם מסננים אחרי החיפוש (post-filtering), ייתכן שרוב ה-top-k יסוננו החוצה ויוחזרו פחות תוצאות מהנדרש. אם מסננים לפני החיפוש (pre-filtering) עם מסנן נוקשה מאוד, האינדקס עלול לאבד את המבנה שהופך אותו למהיר. מסדים מודרניים משלבים את הסינון בתוך החיפוש עצמו, וכדאי לבדוק איך המסד שבחרתם מטפל בזה לפני שמתחייבים אליו.