חיפוש מדויק מול חיפוש מקורב (kNN vs ANN)
חיפוש מדויק: Brute-Force k-Nearest Neighbors
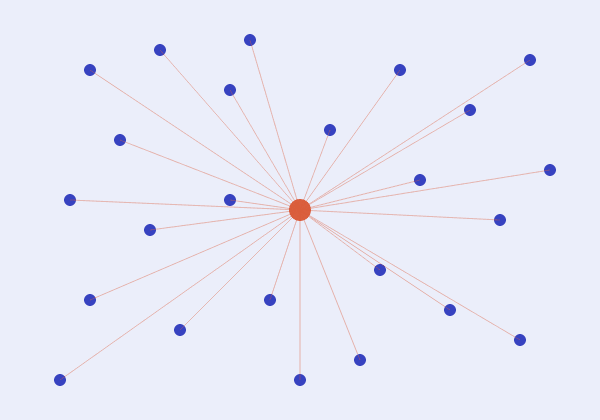
הדרך הפשוטה והמדויקת ביותר למצוא את k הפריטים הקרובים ביותר לשאילתה היא לחשב את מרחק (או דמיון) השאילתה מול כל וקטור בבסיס הנתונים, בלי יוצא מן הכלל, ולמיין את התוצאות. השיטה הזו נקראת brute-force exact k-Nearest Neighbors, והיא מדויקת לחלוטין מבחינה מתמטית — היא תמיד מוצאת את השכנים הקרובים ביותר האמיתיים, ללא פשרות.
המחיר הוא בסיבוכיות: עבור n וקטורים בממד d, כל שאילתה בודדת דורשת O(n·d) פעולות — חישוב מרחק אחד לכל וקטור, וכל חישוב כזה תלוי בממד. הסיבוכיות הזו ליניארית בגודל בסיס הנתונים: הכפלת מספר הווקטורים מכפילה את זמן השאילתה. עבור אלפי או עשרות אלפי וקטורים זה עדיין ישים; עבור מיליוני או מיליארדי וקטורים, בעומס של שאילתות רבות בשנייה ובדרישת latency נמוך, זה כבר לא מעשי.
חיפוש מקורב: Approximate Nearest Neighbor (ANN)
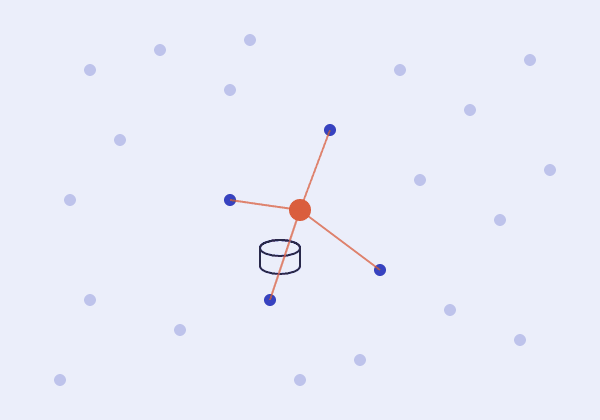
הרעיון המרכזי של ANN: לוותר על הבטחת דיוק מוחלט (מציאת השכן הקרוב ביותר האמיתי, בוודאות) בתמורה למהירות גבוהה משמעותית — לרוב שיפור של סדרי גודל בזמן שאילתה, במחיר סיכוי קטן (לרוב ניתן לכיוון) לפספס חלק מהשכנים האמיתיים.
מבחינה מבנית, שיטות ANN כמעט תמיד בונות אינדקס מראש — מבנה נתונים מיוחד שנבנה פעם אחת (offline) ומאפשר לענות על שאילתות רבות מהר בהרבה מסריקה מלאה בכל פעם, במקום לחשב מרחק לכל וקטור מחדש בכל שאילתה. זה בדיוק ה"אינדקס" שהוזכר בפרק המבוא לנושא — הפרקים הבאים עוסקים במבני האינדקס הנפוצים בפועל.
איך מודדים איכות של חיפוש מקורב: Recall@k
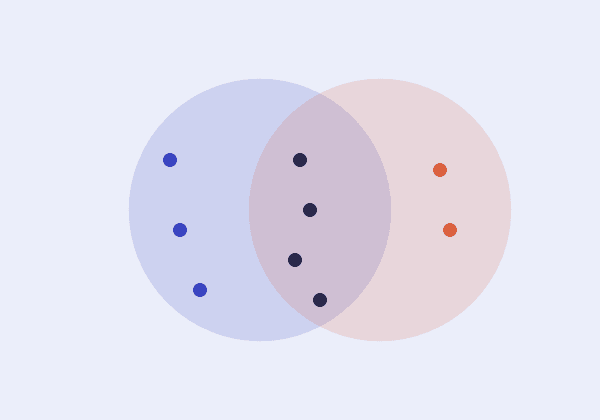
recall@k הוא המדד הסטנדרטי להערכת איכות שיטת ANNחיפוש שמוותר על הבטחת דיוק מוחלט בתמורה למהירות גבוהה בסדרי גודל, בעזרת אינדקס שנבנה מראש. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN).: מתוך k השכנים הקרובים ביותר האמיתיים (שמתקבלים מ-exact search על אותה שאילתה), איזה אחוז מהם שיטת ה-ANN אכן החזירה בתוצאותיה. לדוגמה, recall@10 של 0.95 אומר שבממוצע, 9.5 מתוך 10 השכנים האמיתיים הקרובים ביותר אכן הופיעו בתוצאות ה-ANN.
בפועל בודקים recall@k על מדגם שאילתות, משווים את תוצאות ה-ANN מול תוצאות ה-exact search כ"אמת מידה" (ground truth), וממוצעים. המדד הזה יחזור בפרק העוסק בהערכת ביצועים בהמשך הנושא — הוא הכלי המרכזי להשוואה בין אינדקסים ובין הגדרות פרמטרים שונות של אותו אינדקס.
מתי בכלל צריך ANN?
חיפוש מדויק (exact) עדיין הבחירה הנכונה כאשר בסיס הנתונים קטן יחסית (עד כמה עשרות אלפי וקטורים, כאשר גם סריקה מלאה מהירה מספיק בפועל), או כאשר יש דרישה עסקית מוחלטת ל-100% recall — למשל התאמות משפטיות או רפואיות שבהן פספוס תוצאה אסור.
ברוב המקרים בפרודקשן בקנה מידה — מנועי חיפוש, מערכות RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG., מערכות המלצה — הכמות היא מיליוני עד מיליארדי וקטורים, וANN הוא לא רק אופציה אלא הכרח מעשי כדי לשמור על latency סביר. הפרקים הבאים עוסקים בשיטות ה-ANNחיפוש שמוותר על הבטחת דיוק מוחלט בתמורה למהירות גבוהה בסדרי גודל, בעזרת אינדקס שנבנה מראש. מתוך Vector Search, חיפוש מדויק מול חיפוש מקורב (kNN vs ANN). הנפוצות ביותר בתעשייה.
שאלות נפוצות
מה הערך הנכון של k?
זה תלוי בשימוש. ב-RAG נפוץ לאחזר בין 3 ל-10 קטעים — מספיק כדי לכסות את התשובה בלי למלא את ה-context window ברעש. כשיש אחרי החיפוש שלב דירוג מחדש (reranking), מאחזרים k גדול יותר, למשל 50, ומצמצמים אחר כך.
אפשר להריץ חיפוש מדויק על GPU ולוותר על ANN?
עד גבול מסוים, כן. חיפוש brute-force הוא בעצם כפל מטריצות, ו-GPU מבצע אותו מהר מאוד, כך שגם מיליוני וקטורים יכולים להיות ישימים. אבל הסיבוכיות נשארת O(n·d) — העלות ממשיכה לגדול ליניארית עם הדאטה, ובמיליארדי וקטורים או בעומס שאילתות גבוה ANN חוזר להיות הכרחי.
איזה recall נחשב טוב מספיק?
אין מספר אחד, אבל מערכות פרודקשן מכוונות לרוב ל-recall@10 של 0.9 ומעלה. ב-RAG פספוס של שכן אחד מתוך עשרה פוגע מעט, כי השכן שתפס את מקומו לרוב כמעט זהה לו. ביישומים שבהם כל פספוס יקר, כמו במקרים המשפטיים והרפואיים מהפרק, מכוונים גבוה יותר או חוזרים לחיפוש מדויק.