המתמטיקה של דמיון בין וקטורים
מכפלה סקלרית (Dot Product)
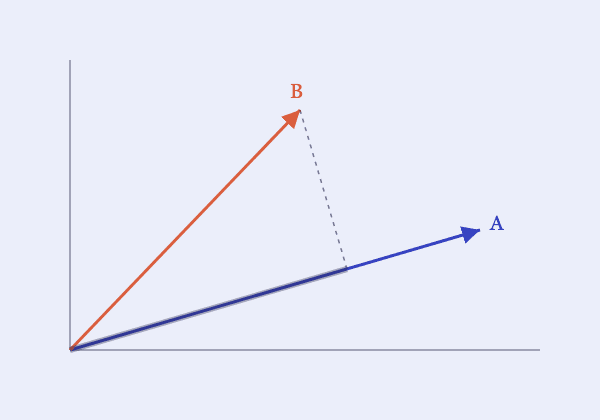
המכפלה הסקלרית בין שני וקטורים A ו-B באורך n מוגדרת כסכום מכפלות הרכיבים המקבילים: A·B = a₁b₁ + a₂b₂ + ... + aₙbₙ = Σ aᵢbᵢ. זו הפעולה הבסיסית ביותר שממנה נגזרים כל שאר מדדי הדמיון בפרק הזה.
אינטואיטיבית, המכפלה הסקלרית גדולה כאשר שני הוקטורים "מצביעים" לאותו כיוון וגם ארוכים (בעלי ערכים גדולים), קטנה או שלילית כאשר הם מצביעים לכיוונים מנוגדים, ואפסית כאשר הם מאונכים זה לזה. היא מערבבת יחד שני דברים שונים — כיוון וגודל — וזו בדיוק הסיבה שנצטרך מדדים נוספים שמפרידים ביניהם.
נורמת וקטור (אורך וקטור)
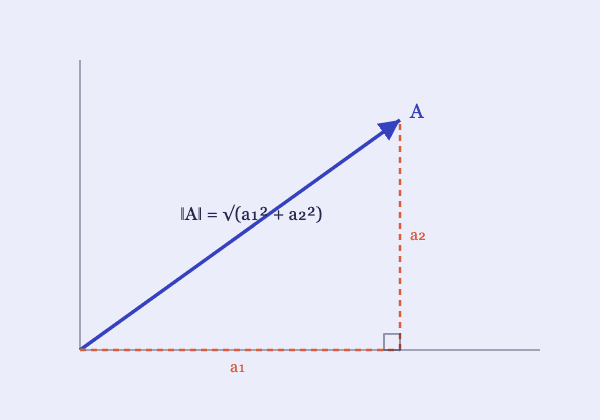
הנורמה (או האורך) של וקטור A, מסומנת ‖A‖, מוגדרת כשורש סכום ריבועי הרכיבים שלו: ‖A‖ = √(a₁² + a₂² + ... + aₙ²) = √(Σ aᵢ²). זו הכללה ישירה של משפט פיתגורס למרחב רב-ממדי.
וקטור מנורמל (נקרא גם "וקטור יחידה") הוא וקטור שהנורמה שלו שווה בדיוק 1. כל וקטור שאינו וקטור האפס אפשר להפוך לוקטור מנורמל, ופעולה זו נקראת נרמול: מחלקים כל רכיב של הוקטור בנורמה שלו, כלומר A / ‖A‖.
דוגמה: לוקטור A = (3, 4) יש נורמה ‖A‖ = √(9 + 16) = 5. מחלקים כל רכיב ב-5 ומקבלים (0.6, 0.8). בדיקה: 0.6² + 0.8² = 0.36 + 0.64 = 1, כלומר האורך החדש הוא 1 בדיוק.
מה נשמר ומה הולך לאיבוד? הכיוון נשמר בדיוק, והאורך נזרק. הוקטור (6, 8) מצביע לאותו כיוון כמו (3, 4) אבל ארוך פי שניים, ואחרי נרמול גם הוא הופך ל-(0.6, 0.8). שני הוקטורים, הקצר והארוך, נעשים זהים. זה בדיוק מה שאנחנו רוצים כשמשווים משמעות: הכיוון מייצג את התוכן, והאורך הגולמי לא אמור להשפיע על התוצאה.
למה זה חשוב בחיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי.? כשכל הוקטורים מנורמלים, כמה ממדי הדמיון שנכיר בהמשך הפרק מתלכדים זה עם זה והחישוב נעשה פשוט וזול יותר. בנוסף, מודלי embeddingייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. רבים מחזירים וקטורים מנורמלים מראש, ולכן המונח "וקטורים מנורמלים" יחזור שוב ושוב.
דמיון קוסינוס (Cosine Similarity)
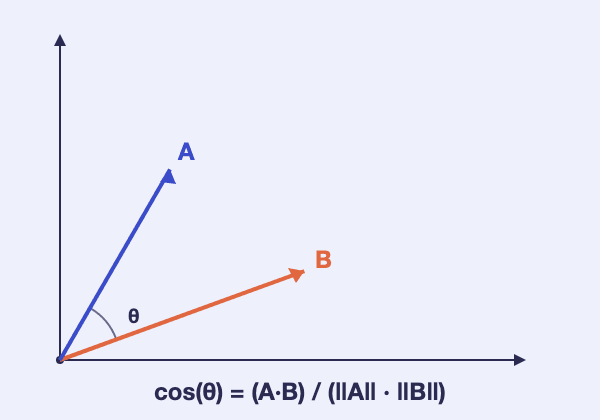
דמיון קוסינוס בין שני וקטורים מוגדר כמכפלה הסקלריתסכום מכפלות הרכיבים המקבילים של שני וקטורים; גדולה כשהם מצביעים לאותו כיוון וגם ארוכים. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים. שלהם, מחולקת במכפלת הנורמות שלהם: cos(θ) = (A·B) / (‖A‖·‖B‖). התוצאה היא בעצם קוסינוס הזווית θ בין שני הוקטורים במרחב.
החלוקה בנורמות היא הצעד הקריטי: היא מבטלת את השפעת האורך של כל וקטור, ומשאירה מדד שתלוי אך ורק בכיוון. זו הסיבה שדמיון קוסינוס הוא מדד כה נפוץ ל-embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. — שני מסמכים יכולים לעסוק באותו רעיון בדיוק, אחד בתמציתיות ואחד בהרחבה, ולקבל embeddings בעלי "אורך" שונה; מה שבאמת אמור לקבוע דמיון סמנטי הוא הכיוון שלהם במרחב, לא האורך.
הטווח התיאורטי של דמיון קוסינוס הוא בין 1- (כיוונים מנוגדים לגמרי) ל-1 (אותו כיוון בדיוק), כאשר 0 מציין אורתוגונליות (אין קשר כיווני). בפועל, embeddings של רוב המודלים הנפוצים נוטים להצטופף בטווח חיובי צר יחסית — כך שההשוואה המשמעותית היא לרוב בין ציוני הדמיון של מועמדים שונים ביחס זה לזה, ופחות מול הטווח המלא התיאורטי.
מרחק אוקלידי (Euclidean / L2 Distance)
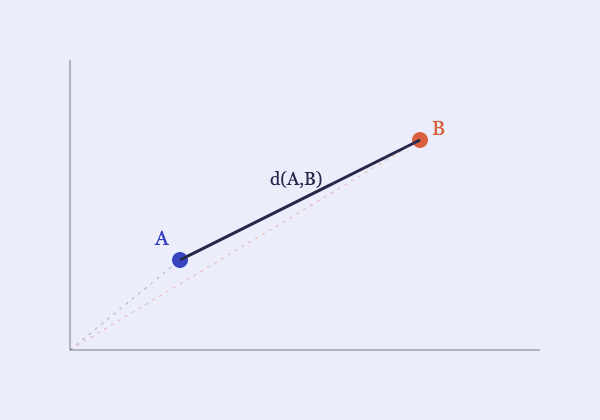
מרחק אוקלידי בין שני וקטורים מוגדר כאורך וקטור ההפרש ביניהם: d(A,B) = ‖A−B‖ = √((a₁−b₁)² + (a₂−b₂)² + ... + (aₙ−bₙ)²) = √(Σ (aᵢ−bᵢ)²). בניגוד לדמיון קוסינוסהמכפלה הסקלרית של שני וקטורים מחולקת במכפלת הנורמות שלהם: מדד שתלוי רק בכיוון, לא באורך. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים., הוא כן רגיש לגודל: שני וקטורים באותו כיוון בדיוק אך באורכים שונים ייחשבו רחוקים זה מזה במרחק אוקלידי, גם אם דמיון הקוסינוס ביניהם הוא 1 (זהה לחלוטין).
עובדה מעשית חשובה מקשרת בין שני המדדים: עבור וקטורים מנורמליםוקטור שהנורמה (האורך) שלו שווה בדיוק 1. מקבלים אותו כשמחלקים כל רכיב בנורמה: הכיוון נשמר, האורך נזרק. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים. (באורך 1, כפי שהוסבר בסעיף על נורמת וקטור), הסדר של תוצאות לפי מרחק אוקלידי (מהקטן לגדול) זהה לחלוטין לסדר לפי דמיון קוסינוס (מהגדול לקטן) — מתמטית, d² = 2 − 2·cos(θ) כאשר שני הוקטורים מנורמלים, כך שמרחק אוקלידי קטן יותר תמיד מתאים לדמיון קוסינוס גדול יותר. זו הסיבה שמערכות רבות מנרמלות את כל הוקטורים מראש, ואז יכולות להשתמש במימוש היעיל ביותר שיש להן — אוקלידי או קוסינוס — ולקבל את אותה דירוג תוצאות בדיוק.
מדד נוסף שמופיע בפועל, בעיקר במערכות מסוימות שבהן הגודל עצמו נושא משמעות (למשל embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. ממושקלים לפי פופולריות) הוא שימוש במכפלה הסקלריתסכום מכפלות הרכיבים המקבילים של שני וקטורים; גדולה כשהם מצביעים לאותו כיוון וגם ארוכים. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים. הגולמית, ללא נרמול, כמדד דמיון בפני עצמו — פחות נפוץ, אך שווה הכרה.
דוגמה מספרית מלאה
ניקח שני וקטורים דו-ממדיים לצורך המחשה: A = (3, 4) ו-B = (4, 3).
מכפלה סקלריתסכום מכפלות הרכיבים המקבילים של שני וקטורים; גדולה כשהם מצביעים לאותו כיוון וגם ארוכים. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים.: A·B = 3·4 + 4·3 = 12 + 12 = 24.
נורמות: ‖A‖ = √(3² + 4²) = √25 = 5, וכן ‖B‖ = √(4² + 3²) = √25 = 5.
דמיון קוסינוסהמכפלה הסקלרית של שני וקטורים מחולקת במכפלת הנורמות שלהם: מדד שתלוי רק בכיוון, לא באורך. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים.: cos(θ) = 24 / (5·5) = 24/25 = 0.96 — קרוב מאוד ל-1, כלומר שני הוקטורים כמעט חופפים בכיוון שלהם.
מרחק אוקלידיאורך וקטור ההפרש בין שני וקטורים; בניגוד לדמיון קוסינוס, הוא רגיש גם לגודל שלהם. מתוך Vector Search, המתמטיקה של דמיון בין וקטורים.: d(A,B) = √((3−4)² + (4−3)²) = √(1 + 1) = √2 ≈ 1.41.
ועכשיו עם נרמול: A מנורמל = (0.6, 0.8) ו-B מנורמל = (0.8, 0.6). המכפלה הסקלרית שלהם היא 0.6·0.8 + 0.8·0.6 = 0.96, בדיוק דמיון הקוסינוס שחישבנו. הנורמות כבר שוות 1, ולכן אין במה לחלק.
function dot(a: number[], b: number[]): number {
  return a.reduce((sum, ai, i) => sum + ai * b[i], 0);
}

function norm(a: number[]): number {
  return Math.sqrt(dot(a, a));
}

function cosineSimilarity(a: number[], b: number[]): number {
  return dot(a, b) / (norm(a) * norm(b));
}

function euclideanDistance(a: number[], b: number[]): number {
  return Math.sqrt(a.reduce((sum, ai, i) => sum + (ai - b[i]) ** 2, 0));
}

function normalize(a: number[]): number[] {
  const n = norm(a);
  return a.map((ai) => ai / n);
}

const A = [3, 4];
const B = [4, 3];

cosineSimilarity(A, B);  // 0.96
euclideanDistance(A, B); // 1.41...

normalize(A);                     // [0.6, 0.8]
dot(normalize(A), normalize(B));  // 0.96, same as cosineSimilarity
שאלות נפוצות
באיזה מדד דמיון כדאי להשתמש בפועל?
במדד שהמודל אומן איתו — לרוב הוא מופיע בתיעוד שלו. מודלים רבים מחזירים וקטורים מנורמלים מראש, ואז דמיון קוסינוס, מכפלה סקלרית ומרחק אוקלידי נותנים בדיוק אותו דירוג, כפי שראינו בפרק. במקרה כזה פשוט בוחרים את המימוש המהיר ביותר, שהוא לרוב המכפלה הסקלרית.
האם ציון דמיון של 0.8 אומר שהטקסטים דומים?
אין סף אוניברסלי. כפי שראינו, embeddings של רוב המודלים מצטופפים בטווח חיובי צר, ובמודלים מסוימים גם טקסטים לא קשורים מקבלים ציון גבוה יחסית. לכן ציון בודד לא אומר הרבה בפני עצמו. אם צריך סף, קובעים אותו אמפירית על דוגמאות מסומנות מהדאטה שלכם ועם אותו מודל.
מה הבעיה בשימוש במכפלה סקלרית בלי נרמול?
וקטור ארוך במיוחד יקבל ציון גבוה מול שאילתות רבות רק בגלל האורך שלו, ולא בגלל שהכיוון שלו קרוב לשאילתה. במודלים שלא תוכננו לכך, התוצאה היא פריטים שצצים בראש התוצאות של שאילתות לא קשורות. השתמשו במכפלה סקלרית גולמית רק כשהגודל נושא משמעות מכוונת, כמו בדוגמת המשקל לפי פופולריות.