מבוא לחיפוש וקטורי
איזו בעיה חיפוש וקטורי פותר?
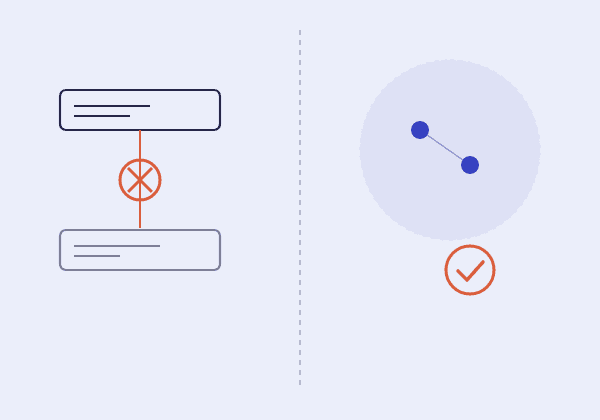
חיפוש מסורתי — כמו חיפוש מילות מפתח במסד נתונים או במנוע חיפוש טקסטואלי — מוצא התאמות לפי מחרוזות: אם השאילתה לא מכילה את אותן מילים בדיוק (או נרדפות שהוגדרו מראש), הוא פשוט לא ימצא את התוצאה, גם אם היא רלוונטית מבחינה עניינית.
חיפוש וקטורי (Vector Search), לעומת זאת, מחפש לפי משמעות ולא לפי מחרוזת: הוא מוצא תוכן שדומה מבחינה סמנטית לשאילתה, גם אם אף מילה משותפת לא מופיעה בשניהם. שאילתה כמו "איך מכינים ארוחה איטלקית קלה לערב עמוס" יכולה למצוא מתכון שכותרתו "פסטה מהירה ל-20 דקות" — אין אף מילה משותפת, אבל המשמעות קרובה מאוד.
העיקרון הבסיסי: כל פיסת תוכן (טקסט, תמונה, קול) מומרת לוקטור מספרים שמייצג את ה"משמעות" שלה, ותוכן בעל משמעות דומה מקבל וקטורים שקרובים זה לזה במרחב המתמטי. חיפוש הופך לבעיה גיאומטרית: מצא את הוקטורים הקרובים ביותר לוקטור השאילתה.
למה זה חשוב עכשיו?
RAG (Retrieval-Augmented Generation) — הדרך המרכזית לתת ל-LLM גישה לידע עדכני או פרטי (מסמכים פנימיים, תיעוד מוצר, בסיס ידע) היא לאחזר את הקטעים הרלוונטיים ביותר באמצעות חיפוש וקטורי, ולהזין אותם ל-context window של המודל לפני שהוא עונה. בלי חיפוש וקטורי יעיל, RAG פשוט לא עובד בקנה מידה.
מערכות המלצה — "מוצרים דומים", "סרטונים שיעניינו אותך" וכדומה מבוססות לרוב על קרבה במרחב וקטורי בין פריטים או בין משתמש למוצר.
חיפוש תמונות/קול לפי תוכן — למשל חיפוש תמונה דומה ויזואלית, או זיהוי קטעי אודיו דומים, ללא תלות בתיוג טקסטואלי מדויק.
דה-דופליקציה סמנטית וזיהוי כפילויות — איתור טקסטים או רשומות שאומרים בעצם את אותו דבר בניסוח שונה, דבר שחיפוש מילות מפתח לא יזהה.
איך זה עובד, ברמת העיקרון
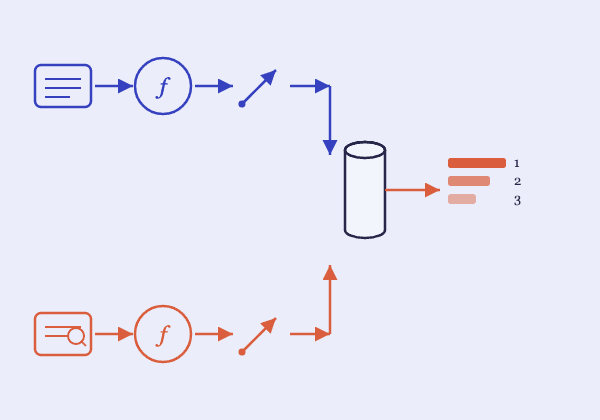
התהליך מתחלק לשני שלבים נפרדים בזמן: שלב אינדוקס (offline, נעשה מראש) ושלב שאילתה (online, נעשה בזמן אמת בכל חיפוש).
בשלב האינדוקס: כל פריט בבסיס הנתונים (מסמך, פסקה, מוצר) עובר במודל embedding שממיר אותו לוקטור, והוקטורים נשמרים במבנה נתונים (אינדקס) שמאפשר חיפוש שכנים קרובים ביעילות — לא רק שמירה גולמית של רשימת וקטורים.
בשלב השאילתה: השאילתה עצמה עוברת באותו מודל embedding ומקבלת וקטור באותו מרחב, האינדקס מוחזר עם ה-k הפריטים שהוקטורים שלהם הקרובים ביותר לוקטור השאילתה (k-Nearest Neighbors), והתוצאות מוחזרות מדורגות לפי מידת הדמיון.
שני התנאים הקריטיים להצלחת התהליך: מודל ה-embedding חייב למקם תוכן דומה קרוב במרחב (זו בעיה של איכות המודל, לא של האינדקס), והאינדקס חייב למצוא את השכנים הקרובים במהירות גם כשיש מיליוני או מיליארדי פריטים (זו בעיה אלגוריתמית — הנושא המרכזי של הפרקים הבאים בנושא).
מה נלמד בהמשך הנושא
בפרק הבא נצלול ל-embeddings עצמם: מה בדיוק הם מייצגים ואיך יוצרים אותם. אחר כך נעבור למתמטיקה שמגדירה "קרוב" ו"דומה" במרחב וקטורי, לאתגר הממדיות הגבוהה, ולאלגוריתמים שהופכים חיפוש שכנים קרובים לישים בקנה מידה עצום — ולבסוף לבניית pipeline בפועל ולשאלות של הערכת ביצועים בעולם האמיתי.