הרשאות ובטיחות — סיכום הנושא
הגנה לעומק (Defense in Depth)
לאורך הנושא ראינו שני סוגים של סיבות לא לסמוך על כך שהמודל "פשוט יתנהג יפה": הוא יכול לטעות — להיתקע בלולאה, להבין לא נכון משימה (פרק 2) — והוא יכול להיות מתומרן, דרך prompt injection (פרק 13). בשני המקרים הפתרון זהה: בטיחות לא נבנית בתוך המודל, אלא בשכבות מסביבו.
כל שכבה מניחה שהשכבה שלפניה עלולה להיכשל. האימון של המודל הוא השכבה הראשונה והחלשה — היא מקטינה סיכון, אבל היא לא גבול. מעליה: מדיניות ה-harness — אישורים והגבלות על פעולות (פרק 5). מעליה: sandbox שהופך פעולות מסוימות לבלתי אפשריות. מעליה: הרשאות מינימליות, שמגבילות מה אפשר להשיג גם כשכל השאר נכשל. ולבסוף לוגים, ניטור ו-evals (פרק 12), שמגלים את מה שכל השכבות פספסו.
Human-in-the-Loop כספקטרום, לא בינארי
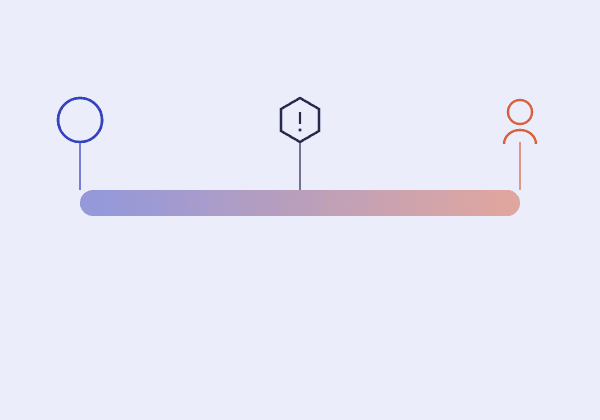
מעורבות אנושית היא לא "יש" או "אין" אלא סקאלה: בקצה אחד אוטונומיה מלאה, בלי לעצור לאישור; בקצה השני אישור על כל פעולה — בטוח, אבל איטי ומעייף; ובאמצע אפשרויות כמו אישור רק על פעולות בלתי הפיכות או כאלה שמוציאות מידע החוצה, או אישור מראש לסוג פעולה מהימן (פרק 5).
יש גם מלכודת: ככל שמבקשים אישור לעיתים קרובות יותר, המשתמש לומד ללחוץ "אשר" בלי לקרוא. אישור שניתן אוטומטית לא מגן על כלום. לכן כדאי לשים נקודות אישור רק איפה שהן באמת חשובות, ולהציג בהן בדיוק מה עומד לקרות. והמיקום על הסקאלה תלוי בהקשר: סוכן שמריץ פקודות על שרת ייצור דורש זהירות אחרת לגמרי מסוכן שרק קורא קבצים לצורך ניתוח.
עקרון ההרשאה המינימלית (Least Privilege)
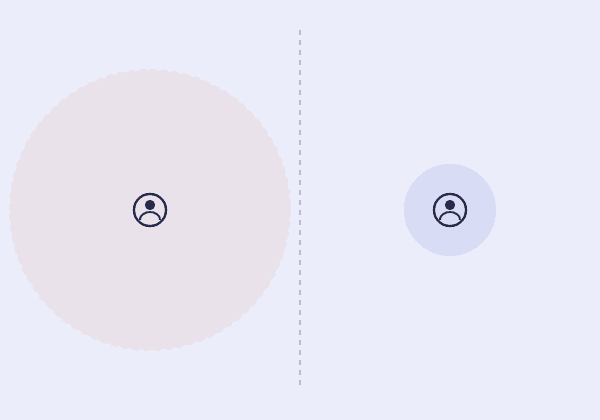
עיקרון ותיק מעולם האבטחה חל כאן ישירות: לתת לכל סוכן רק את ההרשאות שהוא צריך למשימה הנוכחית, ולא גישה רחבה "ליתר ביטחון". סוכן שרק קורא ומנתח קבצים לא צריך הרשאת כתיבה או גישה לרשת, גם אם טכנית קל יותר לתת לו הכול.
במערכות עם subagents וכמה סוכנים (פרקים 4 ו-11) מפתה לתת לכל עובד את אותה גישה רחבה שיש להורה. הגדרת הרשאות נפרדת לכל עובד לפי התפקיד שלו מצמצמת את הנזק אם משהו משתבש, ומונעת מעובד אחד לגעת במשאב של אחר. וזה גם הכלי המעשי לשבירת השילוש הקטלני מפרק 13: כל הרשאה שלא ניתנה היא רגל שחסרה להתקפה.
{
  "agent": "code-review-worker",
  "scope": {
    "read": ["src/api/**"],
    "write": [],
    "network": false
  }
}
מהמודל הגולמי למערכת אגנטית שלמה — סיכום הנושא
התחלנו מ-LLM גולמי שיודע רק להמשיך טקסט. עטפנו אותו בלולאה, וקיבלנו סוכן (פרק 2) — ולמדנו מתי בכלל עדיף workflow עם מסלול קבוע (פרק 3).
משם בנינו את התשתית: subagents שמפצלים עבודה ושומרים על קונטקסט נקי (פרק 4); ה-harness שמבצע בפועל ואוכף גבולות (פרק 5); skills שאורזים נהלי עבודה (פרק 6); tools ו-MCP שמחברים את הסוכן לעולם (פרק 7); ותכנון של כלים שהמודל יודע להשתמש בהם (פרק 8).
למשימות ארוכות ראינו איך מנהלים את הקונטקסט תוך כדי עבודה (פרק 9), איך זוכרים בין sessions (פרק 10), ואיך מארגנים כמה סוכנים יחד (פרק 11). ובסוף — איך מודדים אם כל זה עובד (פרק 12), למה prompt injection הוא הסיכון המרכזי (פרק 13), ואיך בונים הגנה בשכבות.
אף אחת מהשכבות האלה לא מספיקה לבד. יחד, הן מה שהופך מודל שחוזה את המילה הבאה לסוכן שיכול לתכנן, לבצע ולסיים משימה אמיתית — תחת פיקוח שמתאים לרמת הסיכון שלה.