Memory — מה שורד מעבר לשיחה
ברירת המחדל: שום דבר לא נשמר
כברירת מחדל, agent לא זוכר כלום מעבר לשיחה הנוכחית: כשה-session מסתיים, ה-context window שלו נעלם לגמרי — כל מה שנלמד, כל העדפה שהמשתמש ציין, כל החלטה שהתקבלה, פשוט לא קיימים יותר בפעם הבאה שהוא מופעל, גם אם זה היה עשר שניות אחרי.
זה נובע ישירות ממה שנלמד בפרק הקודם: ה-context window הוא כל מה שהמודל "רואה", ואין לו שום דבר "מעבר" לזה מובנה מאליו — הוא לא רשת נוירונים שמתעדכנת בזמן אמת מהשיחה, אלא מודל קבוע שמקבל טקסט טרי בכל פעם.
מה זה בעצם Memory
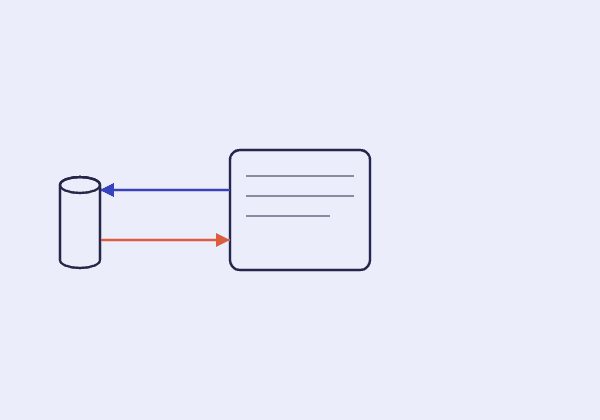
Memory הוא שכבת שמירה חיצונית לגמרי לקונטקסט — קובץ, מסד נתונים, או אינדקס וקטורי — שה-agent יכול לכתוב אליה במפורש ("שמור את זה") ולקרוא ממנה במפורש ("מה כבר ידוע לי?") בתחילת session חדש. זה לא יכולת מובנית של המודל, אלא עוד יכולת שנחשפת אליו כ-tool, בדיוק כמו קריאת קובץ או שאילתת מסד נתונים.
בגלל זה, memory הוא בעצם עניין הנדסי לגמרי: מישהו צריך להחליט מה שווה לשמור, מתי לשמור אותו, ואיך למצוא אותו שוב בפעם הבאה — המודל לא "זוכר" באופן אינהרנטי, הוא רק כותב וקורא מידע חיצוני ביוזמתו (או ביוזמת ה-harness).
שני דפוסים נפוצים: קובץ הערות מול Retrieval
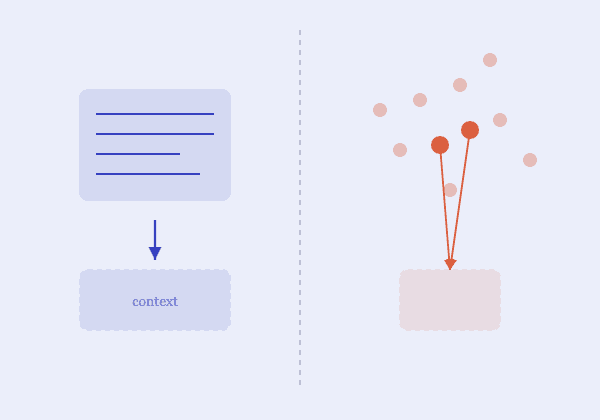
הדפוס הפשוט ביותר: קובץ טקסט (או כמה קבצים לפי נושא) שה-agent מעדכן כשהוא לומד עובדה שכדאי לזכור לפעם הבאה — העדפת סגנון של המשתמש, החלטה ארכיטקטונית שהתקבלה, מבנה פרויקט. הוא נטען במלואו בתחילת כל session חדש, כך שהמידע פשוט "נמצא שם" מההתחלה.
כשנפח המידע הנצבר גדול מדי מכדי לטעון הכול תמיד, עוברים לדפוס retrieval: המידע נשמר כ-embeddings באינדקס וקטורי (בדיוק כפי שנלמד בנושא ה-Vector Search), וה-agent שולף רק את הקטעים הרלוונטיים לשאלה הנוכחית, במקום לטעון את כל הזיכרון בכל פעם. זה בעצם אותו עיקרון RAG שנלמד שם, רק שהמסמכים המאוחזרים הם "זיכרונות" של הסוכן עצמו במקום מסמכים חיצוניים.
זיכרון קצר טווח מול ארוך טווח
כדאי להבחין בין שתי רמות: זיכרון קצר טווח הוא בדיוק ה-context window של ה-session הנוכחי — עשיר בפרטים, אבל נעלם בסיום. זיכרון ארוך טווח הוא כל מה שנכתב במפורש לשכבת ה-memory החיצונית ונועד לשרוד גם אחרי שה-session הנוכחי כבר לא קיים.
המעבר בין השניים תמיד דורש פעולה מכוונת: משהו (המודל, ה-harness, או המשתמש) צריך להחליט במפורש מה מתוך הזיכרון הקצר-טווח העשיר ראוי להצטמצם ולעבור לזיכרון הארוך-טווח — זה לא קורה מעצמו.
דוגמה מלאה: agent שמשתמש בקובץ זיכרון בין שתי שיחות
session א׳: המשתמש מבקש מה-agent לבנות פיצ'ר, ותוך כדי עבודה מציין שהוא מעדיף named exports על פני default exports. ה-agent שומר את ההעדפה הזו בקובץ memory ייעודי, ומסיים את המשימה.
session ב׳, יום למחרת: המשתמש מבקש פיצ'ר חדש ואחר לגמרי. בתחילת ה-session, ה-harness טוען את קובץ ה-memory אל תוך הקונטקסט לפני שהעבודה מתחילה — ה-agent "נזכר" בהעדפה מבלי שהמשתמש יצטרך לחזור ולציין אותה, ופשוט כותב את הקוד החדש בהתאם.
// memory.json - נטען אוטומטית בתחילת כל session
{
  "preferences": [
    "named exports, not default exports"
  ],
  "updated_at": "2026-09-22"
}