Memory — מה שורד מעבר לשיחה
ברירת המחדל: שום דבר לא נשמר
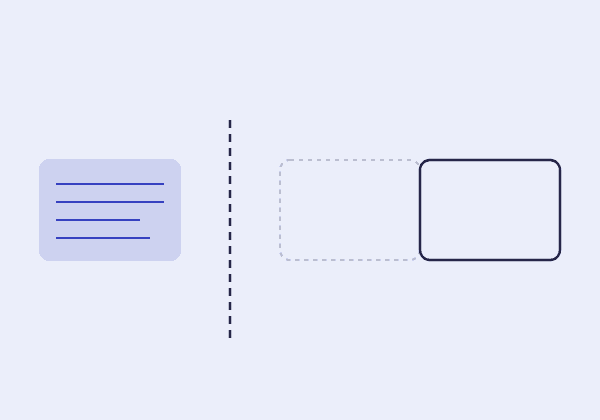
כברירת מחדל, סוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. לא זוכר כלום מעבר לשיחה הנוכחית. כשה-session מסתיים, הקונטקסט שלו נעלם — כל העדפה שהמשתמש ציין וכל החלטה שהתקבלה פשוט לא קיימות בפעם הבאה שהוא מופעל.
זה נובע ישירות מהפרק הקודם: הקונטקסט הוא כל מה שהמודל "רואה". המודל עצמו לא מתעדכן מהשיחה — הוא מודל קבוע שמקבל טקסט טרי בכל קריאה.
מה זה בעצם Memory
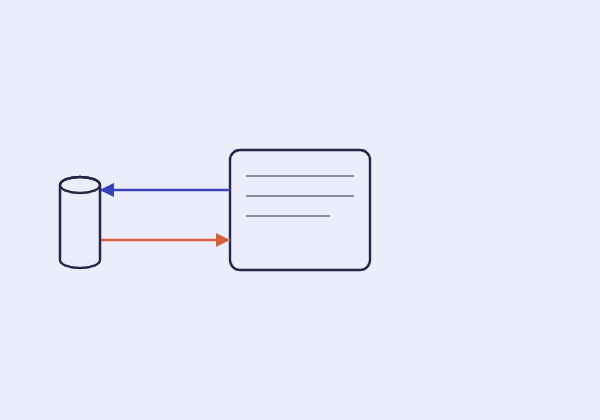
Memory הוא אחסון חיצוני לקונטקסט — קובץ, מסד נתונים או אינדקס וקטורי — שהסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. כותב אליו ומשהו קורא ממנו בתחילת session חדש. הכתיבה נחשפת לסוכן בדרך כלל ככלי ("שמור את זה"), והקריאה נעשית לפעמים ככלי ולפעמים אוטומטית, כשה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. טוען את הזיכרון לקונטקסט לפני שהעבודה מתחילה.
לכן memory הוא בעיה הנדסית, לא יכולת של המודל: מישהו צריך להחליט מה שווה לשמור, מתי, ואיך למצוא את זה שוב. המודל לא "זוכר" — הוא כותב וקורא מידע חיצוני.
שני דפוסים נפוצים: קובץ הערות מול Retrieval
הדפוס הפשוט: קובץ טקסט (או כמה קבצים לפי נושא) שהסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. מעדכן כשהוא לומד משהו ששווה לזכור — העדפת סגנון של המשתמש, החלטה ארכיטקטונית, מבנה הפרויקט. הקובץ נטען במלואו בתחילת כל session, כך שהמידע פשוט נמצא שם מההתחלה.
כשהזיכרון גדל מכדי לטעון את כולו, עוברים ל-retrieval: הזיכרונות נשמרים כ-embeddingsייצוג מספרי קבוע-אורך (וקטור) של פיסת תוכן, שנבנה כך שתכנים בעלי משמעות דומה מקבלים וקטורים קרובים. מתוך Vector Search, Embeddings — ייצוג משמעות כווקטורים. באינדקס וקטורי (כמו בנושא ה-Vector Searchחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי.), והסוכן שולף רק את מה שרלוונטי לשאלה הנוכחית. זה אותו עיקרון RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG., רק שהמסמכים המאוחזרים הם הזיכרונות של הסוכן עצמו.
זיכרון קצר טווח מול ארוך טווח
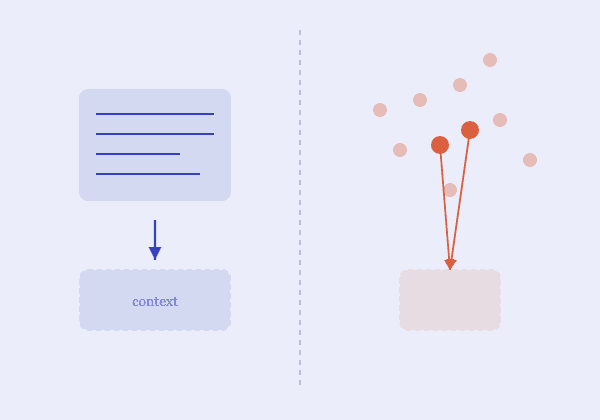
זיכרון קצר טווח הוא הקונטקסט של ה-session הנוכחי: עשיר בפרטים, אבל נעלם בסיום. זיכרון ארוך טווח הוא מה שנכתב במפורש לאחסון החיצוני, כדי לשרוד גם אחרי שה-session נגמר.
המעבר ביניהם תמיד דורש החלטה: משהו — המודל, ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. או המשתמש — צריך לבחור מה מתוך הקונטקסט העשיר ראוי להפוך לזיכרון קבוע. זה לא קורה מעצמו.
תחזוקת זיכרון: לא רק להוסיף
זיכרון שרק מוסיפים אליו מתיישן מהר. העדפה שהמשתמש שינה, החלטה שבוטלה, מבנה פרויקט שהשתנה — אם הרשומה הישנה נשארת, הסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. יפעל לפיה בביטחון מלא. זיכרון שגוי גרוע מזיכרון חסר, כי הסוכן לא יודע שהוא שגוי.
לכן מערכת זיכרון טובה מאפשרת לעדכן ולמחוק רשומות ולא רק להוסיף, שומרת מתי כל רשומה נכתבה, ומעדיפה עובדות מתומצתות על פני העתקה של שיחות שלמות. ויש גם צד אבטחתי: אם תוכן לא אמין (דף אינטרנט, מייל) יכול לגרום לסוכן לכתוב לזיכרון, ההוראה הזדונית תשרוד לכל ה-sessions הבאים — memory poisoningהזרקה שגורמת לסוכן לכתוב הוראה לזיכרון, כך שהיא נטענת מחדש בכל session הבא. מתוך AI Agents, Prompt Injection ואבטחת סוכנים., שנפגוש שוב בפרק 13.
דוגמה מלאה: סוכן שמשתמש בקובץ זיכרון בין שתי שיחות
session א׳: המשתמש מבקש מהסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. לבנות פיצ'ר, ותוך כדי מציין שהוא מעדיף named exports על פני default exports. הסוכן שומר את ההעדפה בקובץ memory.json ומסיים את המשימה.
session ב׳, למחרת: המשתמש מבקש פיצ'ר אחר לגמרי. לפני שהעבודה מתחילה, ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. טוען את memory.json (למטה) לקונטקסט. הסוכן "נזכר" בהעדפה בלי שהמשתמש יצטרך לחזור עליה, וכותב את הקוד החדש בהתאם.
{
  "preferences": [
    {
      "fact": "named exports, not default exports",
      "source": "user",
      "updated_at": "2026-09-22"
    }
  ]
}
שאלות נפוצות
מה ההבדל בין memory לבין RAG על מסמכי הארגון?
המנגנון דומה, וההבדל הוא במקור ובכיוון. ב-RAG המסמכים קיימים מראש ונכתבו על ידי אנשים, והסוכן רק קורא אותם. ב-memory הסוכן עצמו כותב את הרשומות תוך כדי עבודה, ולכן צריך לטפל בשאלות שאין ב-RAG: מה שווה לשמור, מתי לעדכן או למחוק, ואיך מונעים מתוכן לא אמין להיכתב.
איך מונעים מזיכרון של משתמש אחד לדלוף למשתמש אחר?
מפרידים את האחסון לפי משתמש (ולפעמים גם לפי פרויקט) ברמת ה-harness, ולא סומכים על המודל שיתעלם מרשומות שאינן שלו. כל קריאה וכתיבה לזיכרון מסוננת בקוד לפי מזהה המשתמש, כמו כל הרשאה אחרת. זיכרון שמשותף לכמה משתמשים צריך להיות החלטה מפורשת, לא ברירת מחדל.
האם המשתמש צריך לראות ולערוך את מה שהסוכן זוכר עליו?
מומלץ מאוד. זיכרון שגוי גרוע מזיכרון חסר, ומי שיזהה הכי מהר רשומה שגויה או ישנה הוא המשתמש עצמו. ממשק פשוט לצפייה, עריכה ומחיקה של רשומות משפר את איכות הזיכרון, נותן למשתמש שליטה על מידע אישי, ועוזר לזהות כתיבה חשודה שנגרמה מהזרקה.