ניהול קונטקסט בלולאה אגנטית
קונטקסט חלון בעולם האגנטי
בנושא ה-LLM נלמד ש-context window הוא כל מה שהמודל "רואה" ברגע נתון, ושיש לו מגבלת טוקנים קשיחה. בעולם האגנטי המגבלה הזו לא נעלמת — היא רק מקבלת שחקנים נוספים שממלאים אותה: כל תוצאת כלי שחוזרת ללולאה (תוכן קובץ שנקרא, פלט פקודה שהורצה), וכל תקציר שחוזר מ-subagent, מצטרפים לאותו קונטקסט ותופסים בו מקום, בדיוק כמו טקסט שיחה רגיל.
המשמעות: agent שמבצע משימה ארוכה לא רק "משוחח" יותר — הוא גם צובר בהדרגה את כל תוצרי הצדדים של העבודה עצמה בתוך אותו חלון מוגבל, ולכן צריך התייחסות מכוונת לניהול הקונטקסט הזה, לא רק להסתמך על כך שהוא "פשוט יעבוד".
למה לולאה אגנטית ממלאת קונטקסט מהר במיוחד
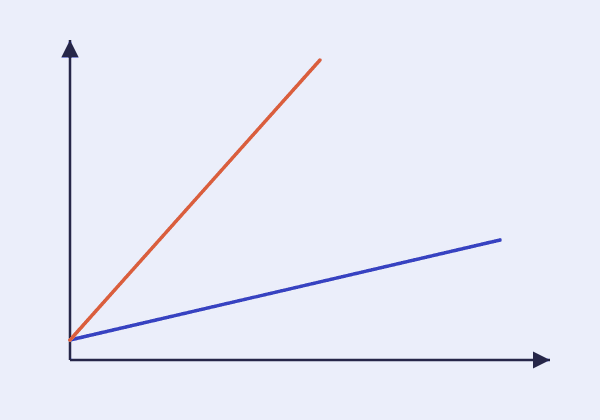
בשיחת צ'אט רגילה הקונטקסט גדל בקצב של הודעה אחת בכל תור. בלולאה אגנטית, כל סיבוב בודד (כפי שנלמד בפרק העוסק ב-Agents) מוסיף גם את בקשת הכלי וגם את תוצאתו — ומשימה שדורשת עשרות סיבובים (סריקת פרויקט שלם, למשל) צוברת עשרות תוספות כאלה, לרוב גדולות בהרבה מהודעת טקסט רגילה של משתמש.
הבעיה מחריפה עוד יותר כשתוצאות ביניים עצמן ארוכות — תוכן קובץ גדול, פלט מפורט של שאילתה — ונשארות בקונטקסט גם אחרי שהמודל כבר "סיים" להשתמש בהן ועבר הלאה לצעד הבא.
טכניקה 1: Summarization ו-Compaction
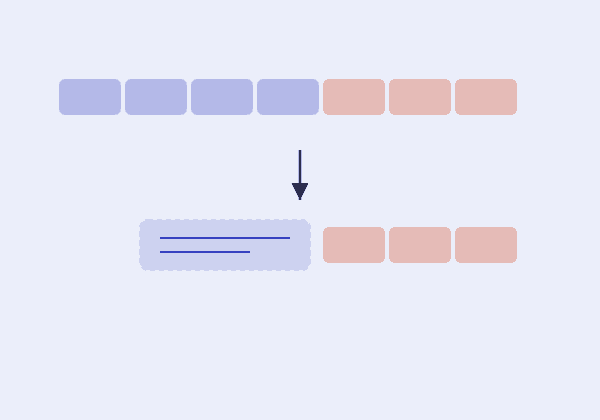
כשהקונטקסט מתקרב למגבלה, טכניקה נפוצה היא compaction: סיכום חלקים ישנים של השיחה/הלולאה למשפט או שניים שמכילים את המהות, במקום לשמור את התמליל המלא של כל סיבוב. כך מתפנה מקום להמשך העבודה, בלי לאבד לגמרי את ההקשר הקודם.
בפועל, compaction לרוב מופעל אוטומטית ע"י ה-harness כשהקונטקסט מתמלא — לא צריך שהמודל "יבקש" את זה בעצמו, בדיוק כפי שראינו לגבי הגנות אחרות שה-harness אוכף באופן עצמאי (פרק ה-Harness).
טכניקה 2: Selective Context ו-Offloading
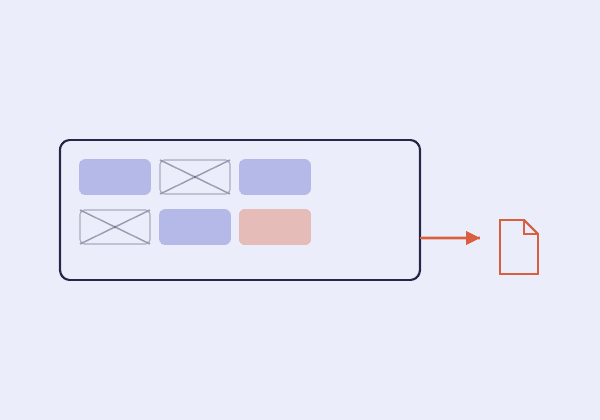
גישה משלימה היא selective context: החלטה מודעת מה עדיין רלוונטי ומה כבר לא, והשארת רק החלק הרלוונטי בקונטקסט — למשל שמירת המסקנה מתוצאת כלי ארוכה, ומחיקת הפלט הגולמי המלא שכבר מיצה את תפקידו.
אפשרות נוספת היא offloading: במקום לשמור פרט בקונטקסט "בשידור חי", כותבים אותו לקובץ חיצוני או מאצילים חלק מהמשימה ל-subagent (כפי שראינו בפרק 3) — כך שהפרטים המלוכלכים נשארים מחוץ לקונטקסט הראשי מלכתחילה, במקום להצטרך לנקות אותם בדיעבד.
function compactIfNeeded(messages: Message[], limit: number): Message[] {
  if (estimateTokens(messages) < limit) {
    return messages; // עדיין יש מקום, אין צורך בפעולה
  }

  const recent = messages.slice(-RECENT_TURNS_TO_KEEP);
  const older = messages.slice(0, -RECENT_TURNS_TO_KEEP);

  return [summarize(older), ...recent];
}
המחיר: מה הולך לאיבוד
כל טכניקת דחיסה כרוכה באותו טרייד-אוף שראינו כבר לגבי תקציר שחוזר מ-subagent: סיכום הוא בהכרח דחוס יותר מהמקור, ולכן פרט ספציפי שהיה חשוב עלול ללכת לאיבוד — ואם המודל יזדקק לו בהמשך, לא תמיד אפשר "לשלוף אותו בחזרה" בלי לחזור על הפעולה שהפיקה אותו מלכתחילה.
ההחלטה כמה לדחוס, מתי, ומה בדיוק לשמור במלואו לעומת לסכם, היא שיקול הנדסי מרכזי בבניית סוכנים למשימות ארוכות — אין תשובה אחת נכונה, אלא איזון בין חיסכון במקום לבין שימור מידע קריטי.