The Harness — מי בפועל מריץ את הסוכן
ה-harness כמתווך בין המודל למציאות
בפרק 1 הגדרנו את העיקרון: המודל מציע, וה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. מחליט. כשהמודל "מוחק קובץ", הוא רק מייצר טקסט שמבקש למחוק — הביצוע כולו בידי ה-harness.
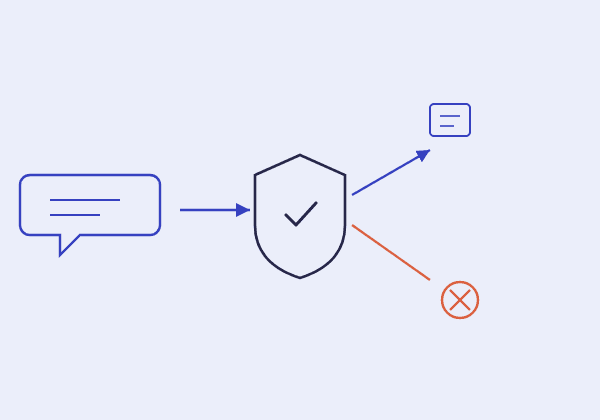
ה-harness מריץ את הלולאה, מפרש כל בקשת פעולה, ומחליט לפי חוקים שהוגדרו מראש אם לבצע אותה מול המערכת האמיתית (קבצים, רשת, מסדי נתונים), לבקש אישור, או לסרב. גם המודל הכי חכם לא יכול לעקוף הגבלה של ה-harness, כי הביצוע פשוט לא עובר דרכו. הפרק הזה עובר על הכלים שעומדים לרשות ה-harness.
הרשאות ו-Approval Gates
הדרך הנפוצה להכניס שליטה אנושית היא approval gate: לפני פעולה רגישה (מחיקת קובץ, שליחת הודעה, הרצת פקודת shell, ביצוע תשלום) ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. עוצר ומבקש אישור מפורש מהמשתמש.
לרוב יש כמה רמות: פעולות בטוחות (קריאת קובץ, חיפוש) רצות אוטומטית; פעולות הרסניות (מחיקה, כתיבה למערכת חיצונית) דורשות אישור בכל פעם; ולפעמים המשתמש יכול לאשר מראש סוג פעולה מסוים כדי לא להישאל עליו שוב ושוב.
Sandboxing — הגבלת מרחב הפעולה
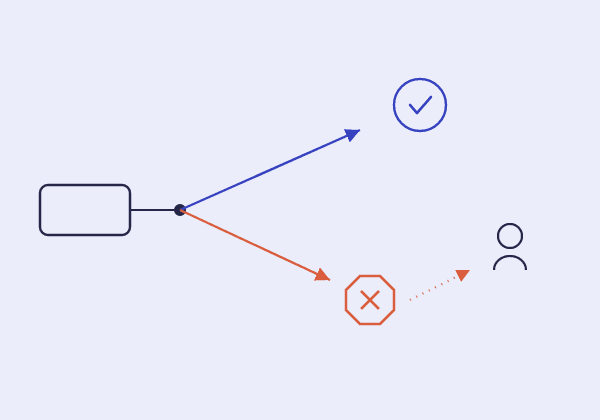
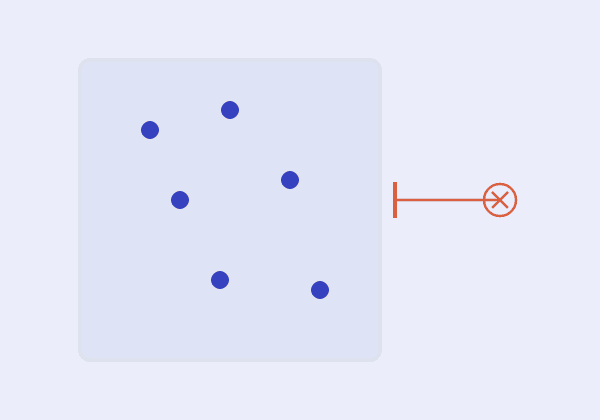
מעבר לאישור ידני, ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. יכול להגביל מראש אילו פעולות בכלל אפשריות: להריץ פקודות רק בתוך תיקייה מסוימת, לחסום גישה לרשת, או להריץ קוד שהמודל כתב בסביבה מבודדת (container או מכונה וירטואלית זמנית) שאין לה גישה למערכת האמיתית.
ההבדל מ-approval gateנקודה שבה ה-harness עוצר לפני פעולה רגישה ומבקש אישור מפורש מהמשתמש. מתוך AI Agents, The Harness — מי בפועל מריץ את הסוכן.: sandboxing לא שואל אף אחד — הוא הופך פעולה לבלתי אפשרית מלכתחילה, גם אם המודל ינסה. שתי הגישות משלימות: sandboxing תוחם את הנזק המקסימלי, ו-approval gates מוסיפים שליטה אנושית על מה שכן מותר.
תקציבים ותצפית: Step Limits, עלות ולוגים
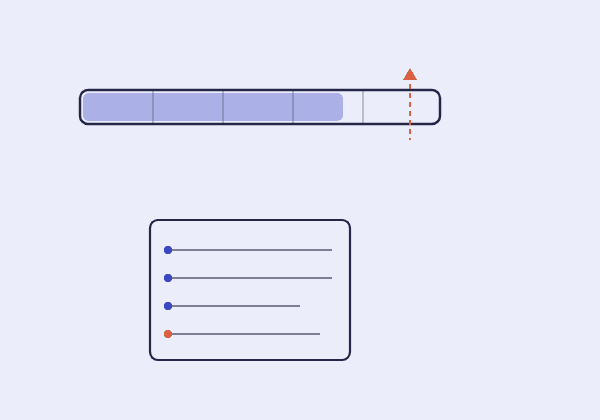
את מגבלת הצעדים, תקציב העלות וזיהוי הלולאות החוזרות כבר פגשנו בפרק 2. כאן חשוב לזכור איפה הם יושבים: ב-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM., כך שהם עוצרים את הסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. גם אם המודל עצמו לא "ביקש" לעצור.
לצד זה, harness רציני שומר לוג מלא של כל פעולה שהמודל ביקש ושל כל החלטה שהתקבלה לגביה. זה לא רק כלי דיבוג — זו רשומת ביקורת (audit trail) שמאפשרת לבדוק בדיעבד מה בדיוק קרה, מי אישר מה, ולמה. בפרק 12 נראה איך אותם לוגים (tracestrace הוא תיעוד מלא של הרצה אחת: כל קריאה למודל, כל קריאת כלי עם הקלט והפלט, טוקנים, זמן ועלות. מתוך AI Agents, הערכת סוכנים (Evals).) משמשים גם להערכת סוכנים.
דוגמה מלאה: ה-harness עוצר פעולה הרסנית
נניח שהמודל, תוך כדי ניקוי קבצים זמניים, מבקש להריץ מחיקה רקורסיבית של תיקייה שלמה. ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. מיירט את הבקשה לפני שהיא מגיעה למערכת ההפעלה ובודק אותה מול החוקים שלו.
קודם כול הנתיב: ה-harness ממיר אותו לנתיב מלא ומנורמל לפני הבדיקה. בלי זה, בקשה כמו src/../../etc "מתחילה ב-src" ועוברת בדיקה נאיבית, למרות שהיא מצביעה אל מחוץ לפרויקט. אם הנתיב נמצא מחוץ לתיקיות המותרות — הבקשה נחסמת.
אם הנתיב תקין, מחיקה רקורסיבית עדיין מסווגת כפעולה הרסנית, ולכן ה-harness מציג למשתמש בדיוק מה המודל ביקש וממתין לאישור. אם המשתמש מסרב, ה-harness מחזיר למודל "נדחה" כתוצאת הכלי, והסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. ממשיך מכאן — למשל עם הצעה זהירה יותר.
import path from "node:path";

const WORKSPACE = "/home/user/project";
const ALLOWED_PATHS = [path.join(WORKSPACE, "src"), path.join(WORKSPACE, "tmp")];
const DESTRUCTIVE_ACTIONS = ["delete_file", "run_shell", "send_email"];

function isInside(target: string, dir: string): boolean {
  const relative = path.relative(dir, target);
  return !relative.startsWith("..") && !path.isAbsolute(relative);
}

function shouldExecute(action: ToolCall): "auto" | "ask" | "deny" {
  if (action.path !== undefined) {
    // מנרמלים קודם: "src/../../etc" הופך ל-"/home/user/etc"
    const resolved = path.resolve(WORKSPACE, action.path);
    if (!ALLOWED_PATHS.some((dir) => isInside(resolved, dir))) {
      return "deny"; // מחוץ לתיקיות המותרות - נחסם לגמרי
    }
  }
  if (DESTRUCTIVE_ACTIONS.includes(action.name)) {
    return "ask"; // דורש אישור אנושי מפורש
  }
  return "auto"; // פעולה בטוחה - מתבצעת מיד
}
שאלות נפוצות
איפה בפועל רץ ה-harness?
זה תלוי במוצר. בכלי תכנות הוא לרוב תוכנה שרצה על המחשב שלכם, ובשירותי ענן הוא רץ על שרת של הספק או שלכם. בכל מקרה, ה-harness הוא קוד רגיל ולא חלק מהמודל: הוא יכול להיות מוצר מוכן, framework, או לולאה שכתבתם בעצמכם.
האם אפשר לתת למודל עצמו להחליט אילו פעולות דורשות אישור?
לא כדאי. אם המודל הוא שמסווג את הפעולה, מודל שטועה או מתומרן יכול פשוט לסווג פעולה הרסנית כבטוחה. הסיווג צריך להיות בקוד של ה-harness, לפי חוקים קבועים על הכלי והפרמטרים שלו — כמו בבדיקת הנתיב בדוגמה. המודל יכול להסביר למה הוא צריך פעולה, אבל לא לקבוע אם היא מותרת.
מה ההבדל בין sandbox לבין הרצה על המחשב שלי עם משתמש מוגבל?
sandbox מבודד את הסוכן מכל מה שלא ניתן לו במפורש: מערכת קבצים נפרדת, רשת חסומה או מסוננת, ובלי גישה לסודות של הסביבה שלכם. הרצה ישירה על המחשב, גם עם משתמש מוגבל, עדיין חושפת קבצים, משתני סביבה וגישה לרשת שקל לשכוח מהם. לכן להרצת קוד שהמודל כתב, sandbox אמיתי (container או VM) הוא ברירת המחדל הבטוחה.