ניהול קונטקסט בלולאה אגנטית
חלון הקונטקסט בעולם האגנטי
בנושא ה-LLMרשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה לחזות מהו הטוקן הבא ברצף טקסט. מתוך LLM, יסודות ה-AI. נלמד ש-context windowכל מה שהמודל "רואה" ברגע נתון: System Prompt, היסטוריית השיחה, קבצים, תוצאות כלים וההודעה הנוכחית. יש לו מגבלת טוקנים. מתוך LLM, יסודות ה-AI. הוא כל מה שהמודל "רואה" ברגע נתון, ושיש לו מגבלת טוקניםהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM. קשיחה. בלולאה אגנטיתהמחזור של סוכן: תצפית, תכנון ופעולה, כשה-harness מבצע את הכלי ומוסיף את התוצאה לקונטקסט לפני הסיבוב הבא. מתוך AI Agents, Agents והלולאה האגנטית. נוספים לו שחקנים חדשים: כל תוצאת כלי (תוכן קובץ, פלט פקודה) וכל תקציר שחוזר מ-subagentסוכן שהסוכן הראשי מפעיל לחלק מוגדר מהמשימה, עם קונטקסט נפרד משלו; מבחינת ההורה זו עוד קריאת כלי. מתוך AI Agents, Subagents — האצלת משימות. נכנסים לאותו חלון ותופסים בו מקום, בדיוק כמו טקסט השיחה.
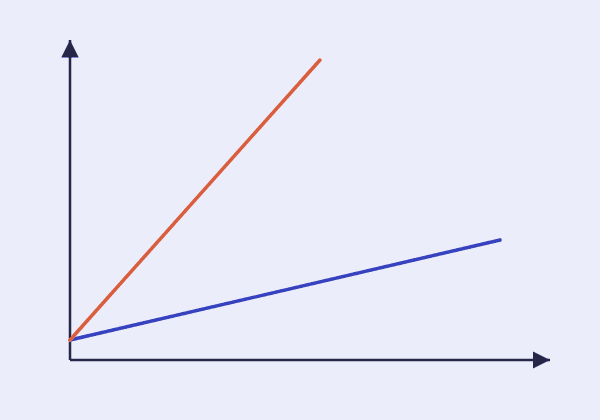
והמגבלה הקשיחה היא לא הבעיה היחידה. גם הרבה לפני שהחלון מתמלא, ככל שהקונטקסט ארוך ועמוס יותר, המודל מתקשה יותר למצוא בו את מה שחשוב ולהשתמש בו — תופעה שנקראת context rot. לכן המטרה היא לא רק "לא לחרוג מהמגבלה", אלא להחזיק בקונטקסט את הסט הקטן ביותר של מידע רלוונטי.
למה לולאה אגנטית ממלאת קונטקסט מהר במיוחד
בשיחת צ'אט הקונטקסט גדל בהודעה אחת בכל תור. בלולאה אגנטיתהמחזור של סוכן: תצפית, תכנון ופעולה, כשה-harness מבצע את הכלי ומוסיף את התוצאה לקונטקסט לפני הסיבוב הבא. מתוך AI Agents, Agents והלולאה האגנטית. כל סיבוב מוסיף גם את בקשת הכלי וגם את התוצאה שלו — ומשימה של עשרות סיבובים (סריקת פרויקט שלם, למשל) צוברת עשרות תוספות כאלה, שרובן ארוכות בהרבה מהודעה של משתמש.
הבעיה מחריפה כשתוצאות הביניים ארוכות — תוכן קובץ גדול, פלט מפורט של שאילתה — ונשארות בקונטקסט גם אחרי שהמודל כבר השתמש בהן ועבר לצעד הבא.
טכניקה 1: Summarization ו-Compaction
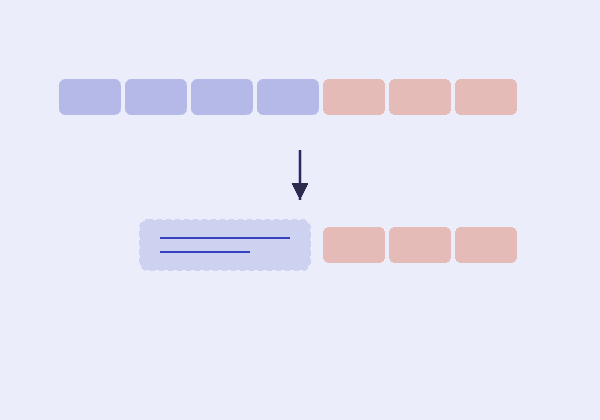
כשהקונטקסט מתקרב למגבלה, טכניקה נפוצה היא compaction: מסכמים את החלק הישן של הלולאה לתקציר קצר שמחזיק את המהות — מה המטרה, מה כבר נעשה, מה הוחלט ומה נשאר — ושומרים את הצעדים האחרונים במלואם. כך מתפנה מקום להמשך העבודה בלי לאבד את ההקשר.
לרוב ה-harnessהתוכנה שמריצה את הלולאה: שולחת את הקונטקסט למודל, מבצעת (או מסרבת לבצע) את מה שביקש, ומחזירה את התוצאה. מתוך AI Agents, מבוא לאקוסיסטם: מה יש מסביב ל-LLM. מפעיל compaction אוטומטית כשהקונטקסט מגיע לסף מסוים; המודל לא צריך לבקש את זה, בדיוק כמו שאר הגבולות שה-harness אוכף (פרק 5).
function compactIfNeeded(messages: Message[], limit: number): Message[] {
  if (estimateTokens(messages) < limit) {
    return messages; // עדיין יש מקום, אין צורך בפעולה
  }

  const recent = messages.slice(-RECENT_TURNS_TO_KEEP);
  const older = messages.slice(0, -RECENT_TURNS_TO_KEEP);

  return [summarize(older), ...recent]; // תקציר של הישן + הצעדים האחרונים במלואם
}
טכניקה 2: Selective Context ו-Offloading
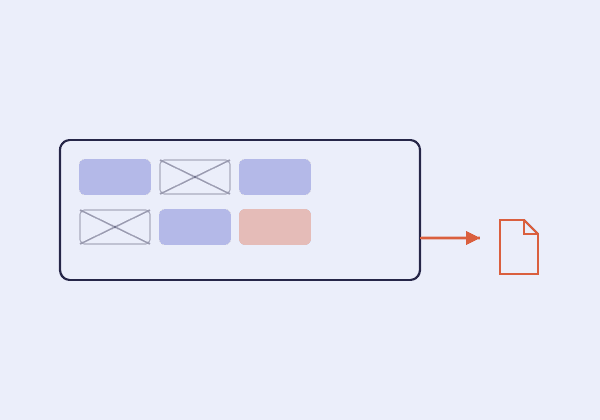
גישה משלימה היא selective context: להשאיר בקונטקסט רק את מה שעדיין רלוונטי. הדוגמה הנפוצה והבטוחה ביותר היא ניקוי תוצאות כלים ישנות — אחרי שהמודל קרא קובץ והסיק ממנו את מה שצריך, אפשר להחליף את התוכן המלא בהערה קצרה ("הקובץ נקרא"), כי אם יזדקק לו שוב הוא יכול פשוט לקרוא אותו מחדש.
אפשרות נוספת היא offloading: במקום להחזיק מידע בקונטקסט, כותבים אותו לקובץ חיצוני — למשל קובץ הערות עם התוכנית וההתקדמות — שהסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. קורא כשצריך; או מאצילים חלק מהמשימה ל-subagentסוכן שהסוכן הראשי מפעיל לחלק מוגדר מהמשימה, עם קונטקסט נפרד משלו; מבחינת ההורה זו עוד קריאת כלי. מתוך AI Agents, Subagents — האצלת משימות. (פרק 4), כך שהפרטים לא נכנסים לקונטקסט הראשי מלכתחילה.
טכניקה 3: Just-in-Time — לא לטעון מראש
הדרך הטובה ביותר לא למלא את הקונטקסט היא לא להכניס אליו מידע לפני שצריך אותו. גישה אחת היא לטעון מראש את כל מה שעשוי להיות רלוונטי — למשל כל הקבצים בפרויקט, או תוצאות חיפוש וקטוריחיפוש לפי משמעות ולא לפי מחרוזת: מוצא תוכן שדומה סמנטית לשאילתה, גם בלי אף מילה משותפת. מתוך Vector Search, מבוא לחיפוש וקטורי. רחב. הגישה השנייה היא just-in-time: הסוכןLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. מקבל רק "מפה" קלה — שמות קבצים, מבנה תיקיות — ומשתמש בכלים כמו חיפוש טקסט וקריאת קובץ כדי לשלוף בדיוק את מה שהוא צריך, ברגע שהוא צריך את זה.
זה בדיוק מה שמתכנת אנושי עושה בקוד לא מוכר: הוא לא קורא את כל הפרויקט, אלא מחפש, פותח את הקובץ הרלוונטי וממשיך משם. המחיר הוא עוד סיבובים בלולאה; הרווח הוא קונטקסט קטן וממוקד. בפועל מערכות רבות משלבות: מעט מידע חשוב נטען מראש (למשל הוראות הפרויקט), והשאר נשלף לפי הצורך.
המחיר: מה הולך לאיבוד
לכל טכניקת דחיסה יש אותו טרייד-אוף כמו לתקציר שחוזר מ-subagentסוכן שהסוכן הראשי מפעיל לחלק מוגדר מהמשימה, עם קונטקסט נפרד משלו; מבחינת ההורה זו עוד קריאת כלי. מתוך AI Agents, Subagents — האצלת משימות.: סיכום דחוס מהמקור, ופרט שהיה חשוב עלול ללכת לאיבוד. אם המודל יזדקק לו בהמשך, לא תמיד אפשר לשחזר אותו בלי לחזור על הפעולה שהפיקה אותו.
יש גם מחיר כספי פחות מובן מאליו. ספקי מודלים מציעים prompt caching: כשתחילת הקונטקסט זהה לקריאה הקודמת, החלק הזה מחויב בזול ומעובד מהר יותר. כל שינוי בתחילת הקונטקסט — כמו compactionסיכום החלק הישן של הלולאה לתקציר קצר, כשהקונטקסט מתקרב למגבלה, תוך שמירת הצעדים האחרונים במלואם. מתוך AI Agents, ניהול קונטקסט בלולאה אגנטית. שמחליף הודעות ישנות בתקציר — שובר את ה-cache, והקריאה הבאה עולה מחיר מלא. לכן כדאי לדחוס לעיתים רחוקות ובבת אחת, ולא לגזום מעט בכל סיבוב.
ההחלטה כמה לדחוס, מתי, ומה לשמור במלואו, היא שיקול הנדסי מרכזי בבניית סוכניםLLM שמופעל בלולאה, עם מטרה וסט כלים, ובכל סיבוב מחליט אם להפעיל כלי נוסף או לסיים ולהחזיר תשובה. מתוך AI Agents, Agents והלולאה האגנטית. למשימות ארוכות — אין תשובה אחת נכונה, רק איזון בין חיסכון במקום לבין שימור מידע קריטי.
שאלות נפוצות
איך יודעים שהקונטקסט עמוס מדי, עוד לפני שמגיעים למגבלה?
סימנים נפוצים: הסוכן שוכח הוראה שקיבל בתחילת המשימה, קורא שוב קבצים שכבר קרא, או סותר החלטות קודמות. ב-traces (פרק 12) אפשר לעקוב אחרי מספר הטוקנים בכל סיבוב ולראות מאיזה שלב האיכות יורדת. כשזה חוזר בעקביות, זה הזמן לנקות תוצאות כלים ישנות או להעביר חלק מהעבודה ל-subagent.
מה צריך להיכנס לתקציר של compaction?
מה שהסוכן לא יוכל לשחזר בקלות: המטרה וההוראות המקוריות של המשתמש, החלטות שהתקבלו והסיבות להן, מה כבר נבדק ונפסל, ומה הצעדים הבאים. תוכן של קבצים אפשר בדרך כלל להשמיט, כי אפשר לקרוא אותו שוב. כדאי לבדוק את פרומפט הסיכום על הרצות אמיתיות: האם הסוכן ממשיך מאותה נקודה, או חוזר על עבודה שכבר עשה?
האם כדאי לתת למודל עצמו כלים לנהל את הקונטקסט שלו?
כן, וזה כיוון נפוץ: כלי לכתיבת הערות לקובץ (offloading) או כלי ששומר תוכנית עבודה עדכנית, כי המודל יודע טוב מכולם מה עוד רלוונטי למשימה. עם זאת, כדאי שה-harness ישמור רשת ביטחון משלו, כמו compaction אוטומטי בסף מסוים, כי המודל לא תמיד ישים לב בזמן שהקונטקסט מתמלא.