The Harness — מי בפועל מריץ את הסוכן
הארנס כמתווך בין המודל למציאות
כפי שהוזכר בקצרה בפרק המבוא לנושא: המודל עצמו יודע רק לחזות טקסט. כשהוא "מבקש" למחוק קובץ או להריץ פקודה, כל מה שהוא באמת עשה הוא לייצר טקסט שמתאר בקשה כזו — הביצוע בפועל נמצא לגמרי בידי תוכנה חיצונית למודל.
ה-Harness הוא בדיוק התוכנה הזו: הוא מריץ את הלולאה האגנטית (שולח פרומפטים, מקבל תשובות), מפרש כל בקשת פעולה שהמודל מחזיר, ומחליט בעצמו — לפי חוקים שהוגדרו מראש ע"י מי שבנה או הגדיר אותו — האם, מתי ואיך לבצע אותה בפועל מול המערכת האמיתית (קבצים, רשת, מסדי נתונים).
ההפרדה הזו קריטית: המודל מציע, ה-harness מחליט. גם המודל הכי חכם ומיושר לא יכול לעקוף הגבלה שה-harness אוכף, כי הביצוע בפועל פשוט לא עובר דרכו.
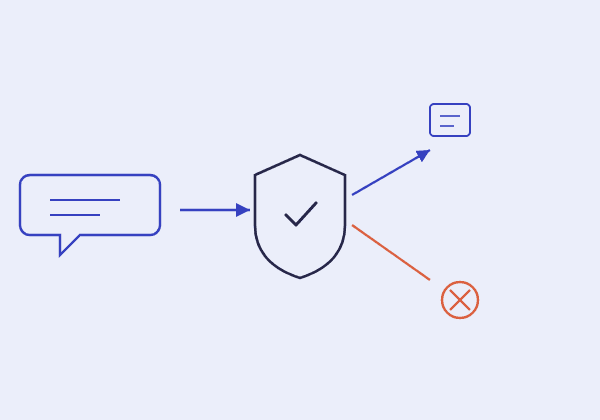
הרשאות ו-Approval Gates
הדרך הנפוצה ביותר להטמיע שליטה אנושית היא approval gate: לפני ביצוע פעולה שהוגדרה כ"רגישה" (מחיקת קובץ, שליחת הודעה, הרצת פקודת shell, ביצוע תשלום), ה-harness עוצר ומבקש אישור מפורש ממשתמש אנושי לפני שהוא ממשיך.
לרוב מוגדרות רמות שונות: פעולות "בטוחות" (קריאת קובץ, חיפוש) מתבצעות אוטומטית בלי לעצור; פעולות "הרסניות" (מחיקה, כתיבה למערכת חיצונית) דורשות אישור בכל פעם; ולעיתים המשתמש יכול מראש להרחיב הרשאות לסוג פעולה מסוים כדי לא להתבקש שוב ושוב על אותו דבר.
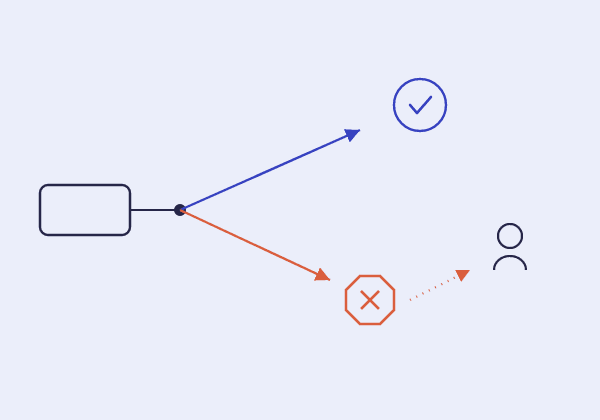
Sandboxing — הגבלת מרחב הפעולה
מעבר לאישור ידני, harness יכול פשוט להגביל מראש אילו פעולות בכלל אפשריות — למשל להריץ פקודות רק בתוך תיקייה מוגדרת, לחסום גישה לרשת לגמרי, או להריץ קוד שנוצר ע"י המודל בסביבה מבודדת (container או מכונה וירטואלית זמנית) שאין לה גישה למערכת האמיתית כלל.
sandboxing הוא הגנה שונה במהותה מ-approval gate: הוא לא שואל את המשתמש — הוא פשוט הופך פעולה מסוימת לבלתי אפשרית מלכתחילה, גם אם המודל "ינסה". שתי הגישות משלימות זו את זו: sandboxing מגביל את הנזק האפשרי המקסימלי, ו-approval gates מוסיפים שכבת שליטה אנושית לפעולות שכן מותרות עקרונית.
תקציבים ותצפית: Step Limits, עלות ולוגים
בפרק הקודם ראינו שהלולאה האגנטית עלולה להיתקע או להימשך יותר מדי — הפתרון הוא ברמת ה-harness: מגבלת מספר סיבובים מקסימלית, תקציב עלות או זמן כולל למשימה, וזיהוי אוטומטי של דפוסי חזרה חשודים שעוצר את הלולאה גם אם המודל עצמו לא "ביקש" לעצור.
לצד זה, harness רציני שומר לוג מלא של כל פעולה שהמודל ביקש ושל כל החלטה שהוא (ה-harness) קיבל לגביה — לא רק לצורך דיבוג, אלא כרשומת ביקורת (audit trail) שמאפשרת לבדוק בדיעבד בדיוק מה קרה, מי אישר מה, ולמה.
דוגמה מלאה: הארנס עוצר פעולה הרסנית
נניח שהמודל, תוך כדי ניקוי קבצים זמניים, מחזיר בקשה להריץ פקודת מחיקה רקורסיבית על תיקייה שלמה. ה-harness מיירט את הבקשה לפני שהיא מגיעה למערכת ההפעלה בכלל, ובודק אותה מול חוקי ההרשאות שהוגדרו לו.
מכיוון שמחיקה רקורסיבית מסווגת כפעולה הרסנית, ה-harness לא מבצע אותה מיד — הוא מציג למשתמש בדיוק מה המודל ביקש לעשות, וממתין לאישור מפורש. רק אם המשתמש מאשר, הפעולה באמת מתבצעת; אחרת, ה-harness מחזיר למודל תשובת "נדחה" כתוצאת הכלי, וה-agent ממשיך את הלולאה מנקודה הזו — למשל ע"י הצעת פעולה זהירה יותר.
function shouldExecute(action: ToolCall): "auto" | "ask" | "deny" {
  if (SANDBOXED_PATHS.some((p) => !action.path?.startsWith(p))) {
    return "deny"; // מחוץ לתיקייה המותרת - נחסם לגמרי
  }
  if (DESTRUCTIVE_ACTIONS.includes(action.name)) {
    return "ask"; // דורש אישור אנושי מפורש
  }
  return "auto"; // פעולה בטוחה - מתבצעת מיד
}