Tools לעומק — הסכמות המלאות
מאיפה ממשיכים
בנושא ה-LLM, בפרק Tool Use / Function Calling, ראינו את הצד של המודל: הוא מקבל רשימת כלים עם סכמות, מחליט לקרוא לאחד מהם, ומקבל את התוצאה. בנושא AI Agents, בפרק תכנון כלים טובים, ראינו איך בוחרים שמות, כותבים תיאורים ומנסחים הודעות שגיאה שהמודל יכול להשתמש בהן. הפרק הזה עוסק בחוזה של הפרוטוקול: מה בדיוק עובר ב-wire, אילו שדות חובה, ומה כל צד מחויב לעשות.
שרת שחושף כלים חייב להצהיר על היכולת tools בתשובת server/discover, ואם הוא יודע להודיע על שינויים ברשימה, גם על listChanged: true. מרגע זה הוא חייב לענות ל-tools/list עם הכלים הזמינים כרגע. הרשימה רשאית להיות ריקה ולהשתנות עם הזמן, אבל לא לפי החיבור ולא כתוצאה מבקשות קודמות (פרק 3). היא כן רשאית להשתנות לפי ההרשאה שמצורפת לבקשה.
ה-spec מוסיף הנחיה ל-host: תמיד צריך (SHOULD) להיות אדם בלולאה, עם אפשרות לסרב להפעלת כלי. ה-host צריך להבהיר ב-UI אילו כלים חשופים למודל, לסמן בבירור מתי כלי מופעל, ולבקש אישור לפעולות. נחזור לזה בפרק 9.
לאורך הפרק נעקוב אחרי כלי אחד, search_issues, מהגילוי ב-tools/list, דרך הקריאה ב-tools/call ועד התוצאה עם structuredContent, כך שהדוגמאות מצטרפות להחלפת הודעות אחת מקצה לקצה.
tools/list — גילוי הכלים
הבקשה פשוטה: method של tools/list, ו-params שמכיל רק את ה-_meta ואולי cursor לדף הבא. התשובה מכילה מערך tools, ואם יש עוד דפים גם nextCursor. ב-2026-07-28 היא חייבת לכלול גם ttlMs ו-cacheScope (בהמשך הפרק).
בדוגמה יש כלי אחד עם כל השדות האפשריים: name, title, description, inputSchema, outputSchema ו-annotations. בסעיפים הבאים נעבור עליהם אחד-אחד.
שרת צריך (SHOULD) להחזיר את הכלים בסדר דטרמיניסטי, כלומר באותו סדר בכל פעם כל עוד הרשימה לא השתנתה. ה-spec נותן שתי סיבות: ה-client יכול לשמור את הרשימה ב-cache בצורה אמינה, והרשימה נכנסת לפרומפט של המודל, כך שסדר יציב משפר את ה-prompt cache hit rate אצל ספק המודל.
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "resultType": "complete",
    "tools": [
      {
        "name": "search_issues",
        "title": "Search Issues",
        "description": "Full-text search over issues. Returns at most 'limit' issues, newest first.",
        "inputSchema": {
          "type": "object",
          "properties": {
            "query": { "type": "string", "minLength": 1 },
            "state": { "type": "string", "enum": ["open", "closed", "all"], "default": "open" },
            "limit": { "type": "integer", "minimum": 1, "maximum": 50 }
          },
          "required": ["query"],
          "additionalProperties": false
        },
        "outputSchema": {
          "type": "object",
          "properties": {
            "total": { "type": "integer" },
            "issues": {
              "type": "array",
              "items": {
                "type": "object",
                "properties": {
                  "id": { "type": "integer" },
                  "title": { "type": "string" },
                  "state": { "type": "string", "enum": ["open", "closed"] }
                },
                "required": ["id", "title", "state"]
              }
            }
          },
          "required": ["total", "issues"]
        },
        "annotations": { "readOnlyHint": true, "openWorldHint": false }
      }
    ],
    "ttlMs": 300000,
    "cacheScope": "public"
  }
}
האובייקט Tool — שם, כותרת ותיאור
name הוא המזהה הפרוגרמטי של הכלי, וזה מה שהמודל שולח כשהוא קורא לו. ה-spec ממליץ (SHOULD) על אורך של 1 עד 128 תווים, תלוי-רישיות, רק אותיות ASCII, ספרות, קו תחתון, מקף ונקודה, בלי רווחים ובלי פסיקים. דוגמאות תקינות: getUser, DATA_EXPORT_v2, admin.tools.list. השם צריך להיות ייחודי בתוך השרת.
הייחודיות היא רק בתוך שרת אחד. host שמחבר כמה שרתים עלול לקבל שני כלים בשם search, ולכן ה-spec ממליץ לו על אסטרטגיית הבחנה, כמו קידומת לפי מזהה השרת (ראינו סקיצה כזו בפרק 1). שם השרת מ-serverInfo לא מובטח כייחודי, ולכן לא כדאי להסתמך עליו לשם כך. עדיף מזהה שה-host עצמו נותן לכל שרת בקונפיגורציה.
title הוא שם לתצוגה ב-UI. סדר העדיפויות לתצוגה הוא title, אחר כך annotations.title, ורק אם שניהם חסרים, name. description הוא התיאור שהמודל קורא, וה-schema מגדיר אותו כרמז (hint) למודל. כל מה שנלמד בפרק תכנון כלים טובים חל עליו: מתי להשתמש בכלי, מה הוא מחזיר ומה המגבלות.
שדות אופציונליים נוספים הם icons, סמלים לתצוגה (אותם כללי אבטחה של אייקונים מפרק 2: רק https או data, בלי credentials), ו-_meta למטא-דאטה חופשית של השרת.
inputSchema ו-outputSchema
inputSchema היא JSON Schema שמתארת את הארגומנטים. ארגומנטים של כלי הם תמיד אובייקט JSON, ולכן בשורש חייב להיות type: object. מעבר לזה, ב-2026-07-28 מותרת כל מילת מפתח של JSON Schema 2020-12: oneOf, anyOf, allOf, not, if/then/else, $ref ו-$defs, enum, format ועוד. בלי שדה $schema, הדיאלקט הוא 2020-12. עם $schema אפשר להצהיר על דיאלקט אחר, כמו draft-07, אבל מימוש חייב לתמוך לפחות ב-2020-12.
לכלי בלי פרמטרים, ה-spec ממליץ על type: object יחד עם additionalProperties: false, שמקבל רק אובייקט ריק. האפשרות type: object בלבד מקבלת כל אובייקט. inputSchema לא יכולה להיות null.
שני כללי אבטחה לכל מי שמאמת מול הסכמות האלה. $ref שמצביע על URI ברשת לא יכול (MUST NOT) להיטען אוטומטית. מצב שטוען $ref חיצוני רשאי להתקיים רק כ-opt-in, כבוי כברירת מחדל, ועדיף עם רשימת hosts מותרים. ומילות הרכבה כמו anyOf ו-oneOf יכולות להפוך אימות ליקר מאוד, ולכן צריך (SHOULD) להגביל עומק, מספר תת-סכמות או זמן אימות. אחרת סכמה זדונית הופכת ל-DoS נגד ה-validator.
outputSchema היא אופציונלית ומתארת את המבנה של structuredContent. בניגוד ל-inputSchema, היא יכולה להיות כל סכמה, למשל מערך. כשכלי מצהיר על outputSchema, השרת חייב (MUST) להחזיר structuredContent שתואם לה, וה-client צריך (SHOULD) לאמת אותו. בדוגמה של search_issues, outputSchema מבטיחה ל-client שדות total ו-issues עם טיפוסים ידועים, כך שקוד ה-host יכול לעבוד עם התוצאה בלי לפענח טקסט.
tools/call — הקריאה
כשהמודל מחליט לקרוא לכלי, ה-host שולח tools/call עם name ו-arguments. arguments הוא אובייקט שאמור לעמוד ב-inputSchema. בדוגמה, ה-_meta כולל progressToken, כך שהשרת רשאי לשלוח עדכוני התקדמות בזמן החיפוש (פרק 4).
ה-spec ממליץ ל-client (SHOULD) להציג למשתמש את הארגומנטים לפני הקריאה. זה לא רק עניין של שקיפות: ארגומנטים הם ערוץ שדרכו מידע יוצא מהשיחה אל השרת, ומודל שהושפע מהזרקה יכול לנסות להדליף דרכם מידע רגיש.
tools/call יכולה לקבל גם תשובה מסוג input_required, כשהשרת צריך מידע נוסף מהמשתמש לפני שהוא יכול לסיים. במקרה כזה ה-client שולח את הקריאה שוב עם inputResponses, ואולי requestState. ה-id של הניסיון החוזר חייב להיות שונה מה-id המקורי. את כל המנגנון נראה בפרק 7.
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "search_issues",
    "arguments": { "query": "login safari", "state": "all", "limit": 2 },
    "_meta": {
      "io.modelcontextprotocol/protocolVersion": "2026-07-28",
      "io.modelcontextprotocol/clientCapabilities": {},
      "progressToken": "call-2"
    }
  }
}
התוצאה: content ו-structuredContent
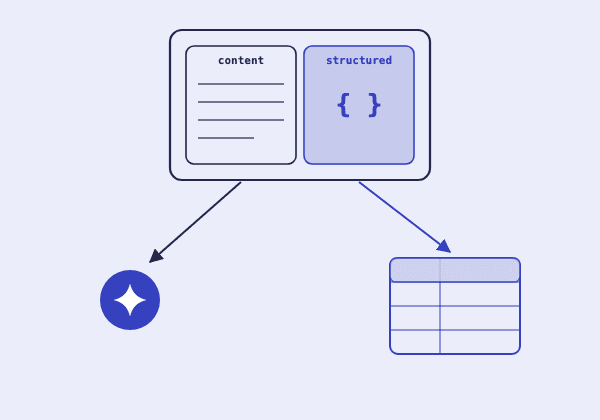
CallToolResult מכיל content, מערך של content blocks. זו התוצאה הלא-מובנית, שמיועדת בעיקר למודל. הוא יכול להכיל גם structuredContent, ערך JSON מובנה שתואם ל-outputSchema, ו-isError, שאם הוא חסר נחשב false.
ב-2026-07-28, structuredContent יכול להיות כל ערך JSON: אובייקט, מערך, מחרוזת, מספר, boolean או null. לשם תאימות לאחור, כלי שמחזיר structuredContent צריך (SHOULD) להחזיר גם את ה-JSON המסודר בתוך text block. בדוגמה, ה-text block הראשון מכיל בדיוק את מה שיש ב-structuredContent. ה-text block השני הוא תקציר קריא.
שימו לב להבחנה שה-spec מדגיש: structuredContent הוא נתונים שהשרת מייצר, ואין לו קשר ל-structured outputs של LLM (יצירה מוגבלת לסכמה). ה-host מחליט מה לעשות עם כל חלק. אפשר להעביר למודל את ה-content, להשתמש ב-structuredContent בקוד (למשל כדי לרנדר טבלה ב-UI), או את שניהם.
{
  "jsonrpc": "2.0",
  "id": 2,
  "result": {
    "resultType": "complete",
    "content": [
      {
        "type": "text",
        "text": "{\"total\":14,\"issues\":[{\"id\":812,\"title\":\"Login fails on Safari 17\",\"state\":\"open\"},{\"id\":655,\"title\":\"Safari login loop after SSO\",\"state\":\"closed\"}]}"
      },
      {
        "type": "text",
        "text": "Found 14 issues; showing the 2 newest: #812 (open), #655 (closed)."
      }
    ],
    "structuredContent": {
      "total": 14,
      "issues": [
        { "id": 812, "title": "Login fails on Safari 17", "state": "open" },
        { "id": 655, "title": "Safari login loop after SSO", "state": "closed" }
      ]
    },
    "isError": false
  }
}
סוגי content blocks
יש חמישה סוגים של content blocks. text: שדה text. image: data בקידוד base64 ו-mimeType. audio: אותו מבנה כמו image, עם mimeType של אודיו. resource_link: קישור ל-resource עם uri, name, ו-description ו-mimeType אופציונליים. ה-client יכול לקרוא אותו ב-resources/read, והוא לא בהכרח מופיע ב-resources/list. resource: resource מוטמע, אובייקט resource עם uri, mimeType ו-text או blob.
resource_link ו-resource פותרים בעיות שונות. קישור שומר על תוצאה קטנה ומשאיר ל-host להחליט אם לטעון את התוכן, למשל כלי חיפוש קבצים שמחזיר עשרים קישורים ולא עשרים קבצים מלאים. resource מוטמע מתאים כשהתוכן קטן ורלוונטי ישירות. שרת שמטמיע resources צריך (SHOULD) לממש גם את היכולת resources.
כל סוגי ה-blocks תומכים ב-annotations: audience (user, assistant או שניהם), priority (בין 0 ל-1) ו-lastModified. host יכול להשתמש בהם כדי להחליט מה נכנס לקונטקסט של המודל ומה מוצג רק למשתמש. בדוגמה, צילום המסך מיועד למשתמש בלבד.
{
  "resultType": "complete",
  "content": [
    { "type": "text", "text": "Issue #812 has 3 attachments. The screenshot is shown to you; the log is linked." },
    {
      "type": "image",
      "data": "iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVR42mNkYPhfDwAChwGA60e6kgAAAABJRU5ErkJggg==",
      "mimeType": "image/png",
      "annotations": { "audience": ["user"], "priority": 0.9 }
    },
    {
      "type": "resource_link",
      "uri": "issues://812/attachments/console.log",
      "name": "console.log",
      "mimeType": "text/plain"
    }
  ]
}
שגיאות: פרוטוקול מול ביצוע, בפירוט
בפרק 2 ראינו את שני ערוצי השגיאה. עכשיו אפשר לדייק מה הולך לאן לפי ה-spec. שגיאות פרוטוקול (JSON-RPC error): כלי לא מוכר (-32602), בקשה שלא עומדת בסכמה של CallToolRequest, ותקלות שרת. שגיאות ביצוע (isError: true): כשל של API חיצוני, שגיאות אימות של קלט (תאריך בפורמט שגוי, ערך מחוץ לטווח) ושגיאות של לוגיקה עסקית.
הנימוק מופיע בהערה בסכמה עצמה: שגיאה שמקורה בכלי צריכה לחזור בתוך ה-result עם isError, כי אחרת המודל לא יראה שהייתה שגיאה ולא יוכל לתקן את עצמו. ה-client צריך (SHOULD) להעביר שגיאות ביצוע למודל, ורשאי להעביר גם שגיאות פרוטוקול, אם כי הסיכוי שהן יעזרו קטן יותר.
הודעת שגיאת ביצוע טובה היא actionable: היא אומרת מה קרה ומה אפשר לעשות. בדוגמה, ה-API החיצוני לא ענה, וההודעה מציעה למודל לנסות שוב עם limit קטן יותר. אותו עיקרון חל על handle שפג תוקפו (פרק 3): isError עם הסבר, כדי שהמודל ייצור handle חדש.
{
  "jsonrpc": "2.0",
  "id": 3,
  "result": {
    "resultType": "complete",
    "content": [
      {
        "type": "text",
        "text": "Issue tracker API timed out after 10s. Retry with a smaller 'limit' (e.g. 10) or a more specific 'query'."
      }
    ],
    "isError": true
  }
}
Tool annotations — רמזים על התנהגות
annotations הן רמזים על ההתנהגות של הכלי, שמיועדים ל-host ולא למודל. readOnlyHint: הכלי לא משנה את הסביבה (ברירת מחדל false). destructiveHint: הכלי עלול לבצע שינויים הרסניים, ולא רק מוסיפים (ברירת מחדל true). idempotentHint: קריאה חוזרת עם אותם ארגומנטים לא משנה שום דבר נוסף (ברירת מחדל false). openWorldHint: הכלי עובד מול עולם פתוח של ישויות חיצוניות, כמו חיפוש ברשת, לעומת עולם סגור כמו זיכרון מקומי (ברירת מחדל true). ל-destructiveHint ול-idempotentHint יש משמעות רק כש-readOnlyHint הוא false.
שימו לב לכיוון של ברירות המחדל. כלי בלי annotations בכלל נחשב כלי שמשנה את הסביבה, עלול להרוס, לא idempotent ופתוח לעולם, כלומר המקרה הזהיר ביותר. host שמחליט מתי לבקש אישור יכול לבקש אישור לכל כלי שאינו מסומן במפורש readOnlyHint: true.
הכלל החשוב: client חייב (MUST) להתייחס ל-annotations כלא-אמינות, אלא אם הן מגיעות משרת אמין. שרת זדוני יכול לסמן כלי שמוחק נתונים כ-readOnlyHint: true. לכן annotations טובות לשיפור UX (למשל לדלג על אישור לכלי קריאה בשרת פנימי מוכר), אבל לא כמנגנון אבטחה. idempotentHint רלוונטי במיוחד בגלל פרק 4: אחרי stream שנקטע, ה-client שולח את הבקשה שוב, וזה בטוח רק לכלי idempotent.
{
  "name": "close_issue",
  "title": "Close Issue",
  "description": "Closes an issue. Closing an already-closed issue is a no-op.",
  "inputSchema": {
    "type": "object",
    "properties": { "id": { "type": "integer" } },
    "required": ["id"],
    "additionalProperties": false
  },
  "annotations": {
    "readOnlyHint": false,
    "destructiveHint": false,
    "idempotentHint": true,
    "openWorldHint": false
  }
}
x-mcp-header — פרמטר שהופך לכותרת HTTP
בפרק 4 ראינו ש-Streamable HTTP משקף את method ואת שם הכלי לכותרות. x-mcp-header מרחיב את זה לפרמטרים של הכלי: השרת מוסיף את המאפיין x-mcp-header לסכמה של פרמטר בתוך inputSchema, והערך שלו קובע את שם הכותרת, Mcp-Param-{name}. בדוגמה, קריאה עם region של us-west1 תישלח עם הכותרת Mcp-Param-Region: us-west1, ו-load balancer יכול לנתב לפיה לאזור הנכון בלי לפענח את הגוף.
האילוצים: הערך לא ריק, תואם לתחביר של שם כותרת HTTP, ייחודי בתוך הסכמה (בלי תלות ברישיות), ומותר רק על פרמטר פרימיטיבי (string, integer או boolean, לא number). הפרמטר חייב להיות נגיש סטטית מהשורש דרך שרשרת של properties בלבד, בלי items, oneOf או $ref בדרך. ערכים שאינם ASCII בטוח מקודדים ב-Base64 בפורמט =?base64?...?= שראינו בפרק 4.
client של Streamable HTTP חייב לתמוך בזה, וחייב לדחות כלי שה-x-mcp-header שלו לא תקין. דחייה פירושה להוציא את הכלי מרשימת הכלים (ולרשום אזהרה בלוג), כדי שכלי פגום אחד לא ישבית את השאר. client של stdio רשאי להתעלם מ-x-mcp-header לגמרי. ושרתים לא אמורים לסמן כך סיסמאות, מפתחות, tokens או מידע אישי, כי כותרות גלויות לכל רכיב ביניים.
{
  "name": "execute_sql",
  "description": "Execute a read-only SQL query in the given region",
  "inputSchema": {
    "type": "object",
    "properties": {
      "region": {
        "type": "string",
        "description": "The region to execute the query in",
        "x-mcp-header": "Region"
      },
      "query": { "type": "string", "description": "The SQL query to execute" }
    },
    "required": ["region", "query"]
  }
}
Pagination, caching ושינויים ברשימה
Pagination: tools/list, prompts/list, resources/list ו-resources/templates/list תומכים ב-pagination מבוסס cursor. גודל הדף נקבע בשרת. cursor הוא token אטום: ה-client לא מפענח אותו, לא משנה אותו ולא מסיק ממנו דבר מלבד אם הוא קיים. אפילו מחרוזת ריקה היא cursor תקין ולא סוף הרשימה. nextCursor חסר פירושו סוף הרשימה. cursor לא תקין מחזיר -32602.
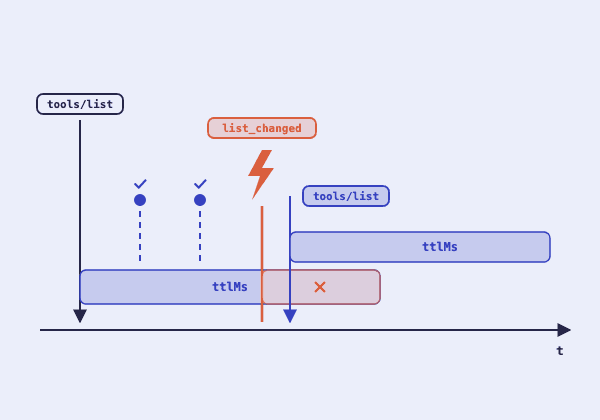
Caching: server/discover, שלוש רשימות ה-list, resources/templates/list ו-resources/read חייבים לכלול ttlMs ו-cacheScope בכל תשובה complete. ttlMs הוא רמז לטריות במילישניות, כמו max-age של HTTP. 0 פירושו שהתשובה כבר לא טרייה, וערך חסר או שלילי מטופל כמו 0. זה לא מרווח polling: ה-client בודק טריות כשהוא צריך את הנתונים, ומביא מחדש רק אם הם לא טריים. cacheScope public מתיר לכל cache משותף לשמור את התשובה ולהגיש אותה לכל משתמש. private מגביל את ה-cache להקשר ההרשאה שממנו התשובה הגיעה, למשל access token אחר מחייב cache אחר.
מפתח ה-cache הוא ה-method יחד עם הפרמטרים שמשפיעים על התוצאה (למשל cursor או uri). תשובות לבקשות שנשלחו שוב עם inputResponses או requestState לא נשמרות ב-cache. כל דף ב-pagination נשמר בנפרד עם ttlMs משלו, אבל cacheScope חייב להיות זהה לכל הדפים של אותה רשימה.
listChanged ו-TTL משלימים זה את זה. אם ה-client פתח subscriptions/listen עם toolsListChanged: true (פרק 4), ההודעה notifications/tools/list_changed מבטלת מיד את הרשימה השמורה, גם אם ה-TTL עוד לא פג. ה-client מביא אותה מחדש, כי ההודעה לא כוללת את הרשימה החדשה. הדוגמה היא ההודעה כפי שהיא מגיעה על stream של subscription שנפתח עם id 30.
{
  "jsonrpc": "2.0",
  "method": "notifications/tools/list_changed",
  "params": {
    "_meta": { "io.modelcontextprotocol/subscriptionId": 30 }
  }
}
בגרסה הקודמת, 2025-11-25
בגרסה הקודמת של הפרוטוקול, 2025-11-25, ה-tools עבדו כמעט אותו דבר, עם כמה הבדלים ב-wire. לתשובות לא היו resultType, ttlMs ו-cacheScope, ולכן client שעובד מול שרת כזה צריך להניח ttlMs של 0 ולהסתמך על ההיוריסטיקות שלו ועל הודעות שינוי.
structuredContent היה מוגבל לאובייקט JSON. בסכמה של 2025-11-25, גם inputSchema וגם outputSchema הוגדרו כאובייקט עם type: object בשורש, ורק properties ו-required לצידו. לכן outputSchema של מערך, למשל, לא הייתה חוקית. ב-2026-07-28 הסכמות יכולות להכיל כל מילת מפתח של 2020-12, ו-structuredContent יכול להיות כל ערך JSON. שרת שצריך לעבוד גם מול clients ישנים יעשה טוב להמשיך להחזיר אובייקט.
notifications/tools/list_changed נשלחה בתוך ה-session, בלי subscription מפורש: ב-stdio על אותו ערוץ, וב-HTTP על ה-stream של GET, ובלי subscriptionId. ו-x-mcp-header עם כותרות ה-Mcp-Method ו-Mcp-Name לא היו קיימים.
סקיצה: אימות ארגומנטים ו-structuredContent
הקוד מממש validator קטן לתת-קבוצה של JSON Schema (type, properties, required, additionalProperties, items, enum) ומשתמש בו בשני הצדדים. בשרת, checkArguments הופכת ארגומנטים לא תקינים לשגיאת ביצוע עם isError, כך שהמודל רואה בדיוק איזה שדה שגוי ויכול לתקן. ב-client, checkStructured בודקת ש-structuredContent תואם ל-outputSchema, כפי שה-spec ממליץ.
בפרודקשן אל תכתבו validator בעצמכם. השתמשו בספרייה שתומכת ב-JSON Schema 2020-12 המלא, כמו Ajv (במחלקה Ajv2020), והגדירו אותה לפי כללי האבטחה של הפרק: בלי טעינה של $ref מהרשת, ועם גבולות לעומק ולזמן. בדקו את התיעוד של הספרייה לגבי ההגדרות המדויקות.
הדוגמה בתחתית מריצה את search_issues מהפרק: ארגומנטים עם state לא חוקי ושדה לא מוכר מחזירים isError עם שתי הודעות, ו-structuredContent שחסר בו total נתפס בצד ה-client.
type JsonSchema = {
  type?: "object" | "array" | "string" | "number" | "integer" | "boolean" | "null";
  properties?: Record<string, JsonSchema>;
  required?: string[];
  additionalProperties?: boolean;
  items?: JsonSchema;
  enum?: unknown[];
};

function typeOf(v: unknown): string {
  if (v === null) return "null";
  if (Array.isArray(v)) return "array";
  if (typeof v === "number") return Number.isInteger(v) ? "integer" : "number";
  return typeof v;
}

function validate(schema: JsonSchema, value: unknown, path = "$"): string[] {
  const t = typeOf(value);
  if (schema.type && schema.type !== t && !(schema.type === "number" && t === "integer")) {
    return [`${path}: expected ${schema.type}, got ${t}`];
  }
  const errors: string[] = [];
  if (schema.enum && !schema.enum.includes(value)) {
    errors.push(`${path}: must be one of ${JSON.stringify(schema.enum)}`);
  }
  if (t === "object") {
    const obj = value as Record<string, unknown>;
    for (const key of schema.required ?? []) {
      if (!(key in obj)) errors.push(`${path}.${key}: required`);
    }
    for (const [key, v] of Object.entries(obj)) {
      const sub = schema.properties?.[key];
      if (sub) errors.push(...validate(sub, v, `${path}.${key}`));
      else if (schema.additionalProperties === false) errors.push(`${path}.${key}: not allowed`);
    }
  }
  if (t === "array" && schema.items) {
    const items = schema.items;
    (value as unknown[]).forEach((v, i) => errors.push(...validate(items, v, `${path}[${i}]`)));
  }
  return errors;
}

// שרת: ארגומנטים לא תקינים הם שגיאת ביצוע, כדי שהמודל יוכל לתקן
function checkArguments(tool: { inputSchema: JsonSchema }, args: unknown) {
  const errors = validate(tool.inputSchema, args ?? {});
  if (errors.length === 0) return null;
  return {
    resultType: "complete",
    content: [{ type: "text", text: `Invalid arguments: ${errors.join("; ")}` }],
    isError: true,
  };
}

// client: structuredContent חייב להתאים ל-outputSchema
function checkStructured(tool: { outputSchema?: JsonSchema }, result: { structuredContent?: unknown }): string[] {
  if (!tool.outputSchema) return [];
  if (!("structuredContent" in result)) return ["$: missing structuredContent although outputSchema is declared"];
  return validate(tool.outputSchema, result.structuredContent);
}

const searchIssues: { inputSchema: JsonSchema; outputSchema: JsonSchema } = {
  inputSchema: {
    type: "object",
    properties: {
      query: { type: "string" },
      state: { type: "string", enum: ["open", "closed", "all"] },
      limit: { type: "integer" },
    },
    required: ["query"],
    additionalProperties: false,
  },
  outputSchema: {
    type: "object",
    properties: { total: { type: "integer" }, issues: { type: "array", items: { type: "object" } } },
    required: ["total", "issues"],
  },
};

console.log(checkArguments(searchIssues, { query: "login", state: "pending", sort: "new" }));
console.log(checkStructured(searchIssues, { structuredContent: { issues: [] } }));