מבוא ל-MCP וארכיטקטורה
מאיפה ממשיכים — ומה הנושא הזה מוסיף
כבר ראינו בנושא AI Agents, בפרק Tools ו-MCP, את התמונה הכללית: MCP (Model Context Protocol) הופך את בעיית ה-N×M, שבה כל אפליקציה כותבת אינטגרציה נפרדת לכל כלי, לבעיית N+M. יש צד server שחושף יכולות וצד client שצורך אותן, ושרת יכול לרוץ מקומית דרך stdio או מרחוק ב-HTTP. הנושא הזה יורד רמה אחת למטה, אל ה-wire עצמו.
המטרה: שבסוף הנושא תוכלו לקרוא כל הודעת MCP ולהבין כל שדה בה, לכתוב שרת MCP מאפס, ולהוסיף תמיכה ב-MCP לאפליקציה משלכם. לכן נראה כאן את ה-JSON המלא של כל בקשה ותשובה, את קודי השגיאה ואת כללי ה-MUST/SHOULD של ה-specification.
חשוב להבין מה MCP לא מחליף. בנושא ה-LLM, בפרק Tool Use / Function Calling, ראינו שהמודל עצמו מחליט לקרוא לכלי, והקוד שלכם מבצע אותו ומחזיר תוצאה. המנגנון הזה נשאר בדיוק כפי שהוא: MCP לא משנה את ה-API של ספק המודל ולא את האופן שבו המודל רואה כלים.
מה ש-MCP מתקנן הוא שני דברים שקורים מסביב למנגנון הזה: מאיפה מגיעות הגדרות הכלים (במקום לכתוב אותן בקוד האפליקציה, שואלים שרת), ואיך הקריאה עצמה מגיעה למי שמבצע אותה. מבחינת ה-LLM, כלי שהגיע משרת MCP הוא כלי רגיל לגמרי. כל העבודה של MCP קורית בין האפליקציה לשרת, מחוץ לשיחה עם המודל.
שלושת התפקידים: Host, Client ו-Server
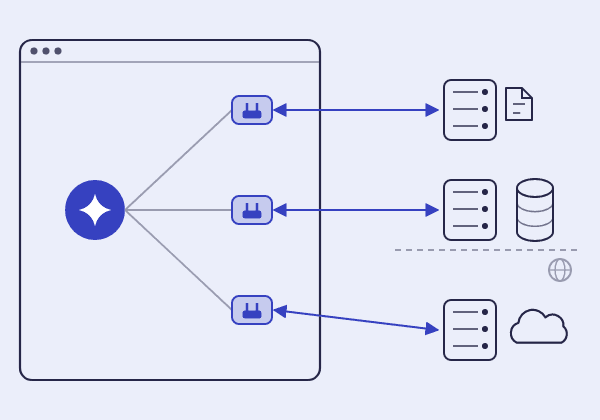
Host הוא אפליקציית ה-LLM עצמה: עורך קוד עם סוכן, אפליקציית צ'אט, או ה-harness שבניתם. ה-host מחזיק את השיחה, מדבר עם המודל, מציג UI ואחראי על הסכמת המשתמש (consent). הוא מחליט לאילו שרתים להתחבר, אילו כלים לחשוף למודל ומתי לבקש אישור לפני הפעלת כלי.
Client הוא רכיב בתוך ה-host שמנהל חיבור לשרת אחד בדיוק, ביחס 1:1. ה-client מצרף לכל בקשה את גרסת הפרוטוקול ואת היכולות שלו (פרק 3), מנתב הודעות לשני הכיוונים, מנהל subscriptions ושומר על הגבול בין שרת לשרת.
Server הוא תוכנה שחושפת יכולות דרך ה-primitives של MCP: tools, resources ו-prompts. שרת יכול להיות תהליך מקומי (גישה למערכת הקבצים או ל-git) או שירות מרוחק (API של מערכת ענן). הוא מתמקד ביכולת אחת מוגדרת היטב, ולא יודע דבר על המודל או על שאר השרתים.
למה host ו-client הם שני דברים נפרדים? כי אפליקציה אחת מתחברת בדרך כלל לכמה שרתים במקביל: מערכת קבצים, מסד נתונים, מערכת ניהול משימות. כל חיבור צריך transport, הרשאות ו-lifecycle משלו. ה-host יוצר client נפרד לכל שרת ומאחד את היכולות של כולם לרשימת כלים אחת שהמודל רואה.
הקוד למטה הוא סקיצה רעיונית של המבנה הזה, לא API של SDK מסוים. שימו לב לקידומת שם השרת שה-host מוסיף לשם הכלי: שני שרתים יכולים לחשוף כלי בשם search, וה-host צריך להבחין ביניהם. בפרק 9 נבנה את הצד הזה במלואו.
type ToolDefinition = { name: string; description?: string; inputSchema: object };
type ToolResult = { content: unknown[]; isError?: boolean };

interface McpClient {
  listTools(): Promise<ToolDefinition[]>;
  callTool(name: string, args: unknown): Promise<ToolResult>;
}

class Host {
  // client אחד לכל שרת: יחס 1:1
  private clients = new Map<string, McpClient>();

  connect(serverName: string, client: McpClient) {
    this.clients.set(serverName, client);
  }

  // ה-host מאחד את הכלים של כל השרתים לרשימה אחת עבור המודל
  async toolsForModel(): Promise<ToolDefinition[]> {
    const all: ToolDefinition[] = [];
    for (const [server, client] of this.clients) {
      for (const tool of await client.listTools()) {
        all.push({ ...tool, name: `${server}__${tool.name}` });
      }
    }
    return all;
  }
}
עקרונות התכנון: בידוד ופשטות בצד השרת
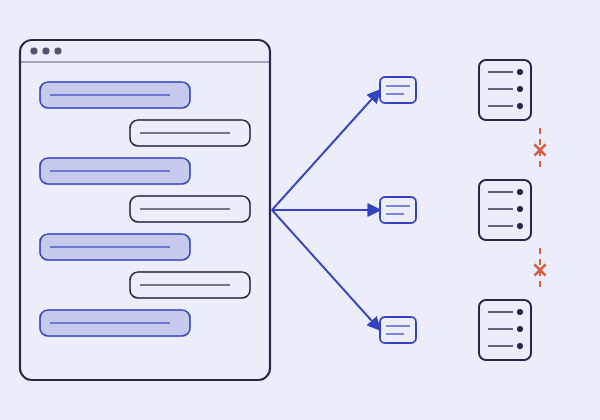
ה-spec מנסח ארבעה עקרונות תכנון שמסבירים הרבה מההחלטות שנראה בהמשך. הראשון: שרתים צריכים להיות קלים מאוד לבנייה. כמעט כל המורכבות (ניהול השיחה, תזמור בין שרתים, UI, אישורים) יושבת ב-host. שרת MCP טיפוסי הוא כמה עשרות שורות קוד שממפות בקשות לפונקציות, וזה מכוון: כך נוצר אקוסיסטם של הרבה שרתים שאנשים שונים כותבים, מול מספר קטן יחסית של hosts.
השני: שרתים צריכים להיות composable. כל שרת מספק יכולת ממוקדת בבידוד, ואפשר לחבר כמה שרתים יחד בלי שיכירו זה את זה.
השלישי הוא החשוב ביותר מבחינת אבטחה: שרת לא אמור לקרוא את כל השיחה, וגם לא לראות לתוך שרתים אחרים. הוא מקבל רק את מה שנדרש לבקשה הספציפית, כמו שם הכלי והארגומנטים. היסטוריית השיחה המלאה נשארת ב-host, וכל אינטראקציה בין שרתים עוברת דרך ה-host ובשליטתו. שרת שמטפל ב-GitHub לא יכול לקרוא את מה ששרת מסד הנתונים החזיר, אלא אם ה-host בחר להעביר את זה בעצמו.
הרביעי: יכולות נוספות מתווספות בהדרגה. הפרוטוקול מגדיר ליבה מינימלית, וכל השאר נחשף כ-capabilities שכל צד מצהיר עליהן. שרת שחושף רק tools לא צריך לממש resources, ו-client שאין לו UI לשאלות למשתמש לא מצהיר על elicitation. בפרק 3 נראה איך ההצהרה הזו עובדת בפועל.
ההשראה: Language Server Protocol
ה-spec מציין במפורש ש-MCP שואב השראה מ-LSP (Language Server Protocol). לפני LSP, כל עורך קוד היה צריך לממש מחדש השלמה אוטומטית, מעבר להגדרה והצגת שגיאות לכל שפת תכנות, שוב בעיית N×M. LSP הגדיר פרוטוקול אחד בין עורך לבין שרת שפה, ומאז שרת שפה אחד משרת כל עורך שתומך ב-LSP.
MCP לקח מ-LSP כמה החלטות מהותיות: JSON-RPC 2.0 כפורמט ההודעות, הפרדה בין אפליקציה מארחת לבין שרת ייעודי שמתמחה בתחום אחד, הרצת שרתים מקומיים כתהליכי-משנה שמדברים דרך stdin/stdout, ומנגנון capabilities שבו כל צד מצהיר מה הוא יודע לעשות.
ההבדל הוא במי שצורך את המידע. ב-LSP הצרכן הוא עורך קוד שמציג מידע למתכנת. ב-MCP הצרכן הסופי הוא מודל שפה, ולכן יש ב-MCP דברים שאין ב-LSP: תיאורים בשפה טבעית שהמודל קורא (description), הבחנה בין מה שהמודל מפעיל לבין מה שהמשתמש בוחר, ודגש חזק על הסכמת המשתמש, כי מודל יכול להחליט להפעיל פעולה שהמשתמש לא התכוון אליה.
מפת ה-Primitives: מי שולט במה
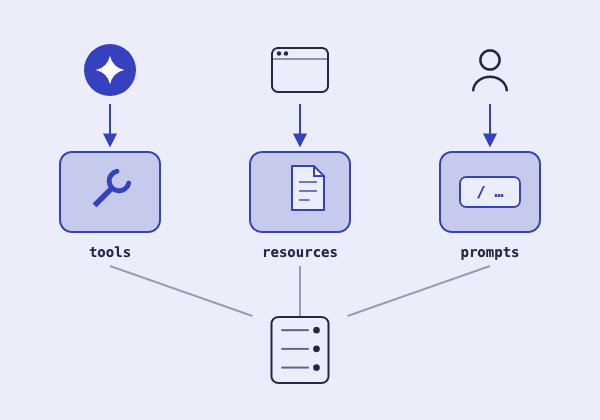
לשרת יש שלושה primitives, וההבדל ביניהם הוא לא רק בסוג המידע אלא בשאלה מי מחליט להשתמש בו. ה-spec מגדיר את זה כהיררכיית שליטה (control hierarchy).
Tools הם בשליטת המודל (model-controlled): פונקציות שהמודל מחליט לבד מתי להפעיל, כמו שליחת בקשת POST ל-API או כתיבת קובץ. זה ה-primitive המוכר ביותר, והוא הנושא של פרק 5.
Resources הם בשליטת האפליקציה (application-controlled): מידע שה-host מצרף לקונטקסט לפי ההחלטה שלו, כמו תוכן של קובץ או היסטוריית git. המודל לא קורא ל-resource; ה-host, או המשתמש דרך ה-UI, בוחר מה לצרף. Prompts הם בשליטת המשתמש (user-controlled): תבניות שהמשתמש מפעיל במפורש, בדרך כלל כ-slash command או פריט בתפריט. שניהם הנושא של פרק 6.
בכיוון ההפוך יש client features, יכולות שה-client מציע לשרת. ב-2026-07-28 היכולת הפעילה היא Elicitation: שרת שצריך מידע נוסף מהמשתמש באמצע בקשה, למשל אישור או שדה חסר, יכול לבקש אותו דרך ה-client. שתי יכולות נוספות הוגדרו כ-deprecated בגרסה הזו: Sampling, שבה שרת מבקש מה-host להריץ את ה-LLM בשבילו, ו-Roots, שבה ה-client מודיע לשרת על תיקיות העבודה. נפגוש את כולן בפרק 7.
ההבחנה הזו חשובה כשבונים host: tools נכנסים לרשימת הכלים שנשלחת למודל, resources מוצגים בבורר קבצים או מצורפים אוטומטית, ו-prompts מופיעים בתפריט הפקודות. אותו שרת יכול לחשוף את שלושתם, וכל אחד מהם מגיע למקום אחר ב-UI.
מה MCP הוא לא
MCP הוא לא framework לסוכנים. אין בו לולאה אגנטית, ניהול זיכרון או תזמור. הוא לא מחליט מתי לקרוא לכלי ולא שולח דבר למודל. כל זה נשאר באחריות ה-host.
MCP הוא גם לא API של מודל שפה. אין בפרוטוקול הודעת משתמש או תשובת מודל של צ'אט. ה-host ממשיך לדבר עם ספק המודל ב-API של הספק, ו-MCP משמש רק כדי לגלות יכולות של שרתים ולהפעיל אותן.
והוא לא רק פורמט transport. ה-spec מגדיר סמנטיקה: מה המשמעות של כל method, אילו שדות הם חובה, מה מותר לשרת לעשות כשה-client לא הצהיר על יכולת, ואילו דרישות אבטחה חלות על כל צד.
איפה frameworks כמו LangChain נכנסים לתמונה? בנושא LangChain, בפרק Tools, ראינו איך מגדירים כלים ישירות בקוד של ה-agent. framework כזה יושב בצד ה-host: הוא מריץ את הלולאה ומדבר עם המודל. כשמחברים אליו שרת MCP, בדרך כלל דרך adapter, הכלים של השרת הופכים לכלים רגילים של ה-agent. כלומר MCP ו-framework לא מתחרים: ה-framework הוא הצרכן, ו-MCP הוא הדרך שבה הוא מקבל כלים שמישהו אחר כתב.
גרסאות הפרוטוקול: 2026-07-28 מול 2025-11-25
גרסאות של ה-spec מזוהות במחרוזת תאריך בפורמט YYYY-MM-DD. הגרסה העדכנית היא 2026-07-28, והיא הבסיס של הנושא הזה. הגרסה הקודמת, 2025-11-25, עדיין נפוצה מאוד בשרתים, ב-clients ובמדריכים שתמצאו ברשת.
הגרסה 2026-07-28 שינתה את הפרוטוקול באופן מהותי. היא הפכה אותו ל-stateless: אין יותר לחיצת יד פותחת (initialize) ואין session ברמת הפרוטוקול. כל בקשה נושאת בעצמה את הגרסה ואת היכולות של ה-client. נוספה בקשה חדשה, server/discover, שבה שרת מפרסם באילו גרסאות ויכולות הוא תומך. ובקשות שהשרת יזם כלפי ה-client, למשל כדי לשאול את המשתמש שאלה, הוחלפו בדפוס Multi Round-Trip Requests (MRTR): השרת מחזיר תשובת ביניים שאומרת שחסר לו מידע, וה-client שולח את הבקשה המקורית שוב, הפעם עם המידע.
הסיבה העיקרית ל-statelessness היא סקייל. שרת שאין לו session יכול לרוץ מאחורי load balancer, בכמה עותקים או כ-serverless function, וכל בקשה יכולה להגיע לכל עותק. מצב שחייב לשרוד בין קריאות מועבר במפורש, כמזהה שהשרת מנפיק ומקבל בחזרה כארגומנט.
איך הנושא מתמודד עם שתי הגרסאות: אנחנו מלמדים את 2026-07-28 כפרוטוקול הראשי. בכל מקום שבו פורמט ההודעות שונה ב-2025-11-25 תופיע פסקה מפורשת שמתחילה ב-"בגרסה הקודמת, 2025-11-25" ומראה איך זה נראה שם. כך תוכלו לעבוד גם מול שרתים ו-clients ישנים יותר, שיישארו בשטח עוד זמן רב.
ה-spec מתפתח מהר. לפני שמממשים משהו, כדאי לבדוק את הגרסה הנוכחית ב-modelcontextprotocol.io/specification, כולל ה-changelog של כל גרסה, שמפרט בדיוק מה השתנה.
מפת הדרכים של הנושא
פרק 2, JSON-RPC 2.0: מבנה ההודעה הבסיסי (request, result, error ו-notification), השדה _meta, השדה resultType וקודי השגיאה. כל דוגמת JSON בהמשך בנויה על המעטפת הזו.
פרק 3, Lifecycle, גרסאות ו-Capabilities: איך client ושרת מסכימים על גרסה ויכולות בלי handshake, server/discover, ואיך נראה ה-initialize של הגרסה הקודמת. פרק 4, Transports: stdio ו-Streamable HTTP, subscriptions, ביטול בקשות והודעות התקדמות.
פרק 5, Tools לעומק: הסכמות המלאות של tools/list ו-tools/call, inputSchema ו-outputSchema, structuredContent וטיפול בשגיאות. פרק 6, Resources ו-Prompts: URIs ו-templates, תוכן טקסט ובינארי, prompts/get ו-completion.
פרק 7, Client Features ו-MRTR: elicitation והדפוס החדש של בקשות מרובות סבבים. פרק 8: בניית שרת MCP ב-TypeScript עם ה-SDK הרשמי, מקצה לקצה.
פרק 9, הצד השני: מה אפליקציה צריכה לבנות כדי לתמוך בשרתי MCP. פרק 10: Authorization עם OAuth, מודל האיומים, ה-extensions של הפרוטוקול וסיכום הנושא.