Authorization, אבטחה ו-Extensions — סיכום הנושא
מתי יש Authorization ב-MCP
Authorization ב-MCP הוא אופציונלי, ומוגדר רק ל-HTTP. שרת HTTP צריך (SHOULD) לעמוד במפרט. שרת stdio לא אמור להשתמש בו (SHOULD NOT), ובמקום זה מקבל credentials מהסביבה, כפי שראינו בפרקים 4 ו-8. הסיבה פשוטה: שרת stdio רץ על המחשב של המשתמש, בתהליך שה-host הפעיל, ואין שם צד שלישי שצריך להוכיח לו זהות.
המפרט בנוי על OAuth 2.1 ועל כמה RFCs, והתפקידים מוגדרים כך: שרת MCP מוגן הוא resource server. ה-client הוא OAuth client שפועל בשם המשתמש. ה-authorization server הוא זה שמדבר עם המשתמש ומנפיק tokens. הוא יכול לרוץ יחד עם שרת ה-MCP או להיות מערכת נפרדת, כמו ה-IdP של הארגון.
בסעיפים הבאים נעבור על הזרימה צעד אחר צעד, לפי המפרט של 2026-07-28. ה-SDK הרשמי מממש את רובה בצד ה-client, ומספק בצד השרת כלים כמו requireBearerAuth ו-buildOAuthProtectedResourceMetadata. עדיין כדאי להבין כל שלב, כי כל שלב הוא גם הגנה מפני התקפה מסוימת.
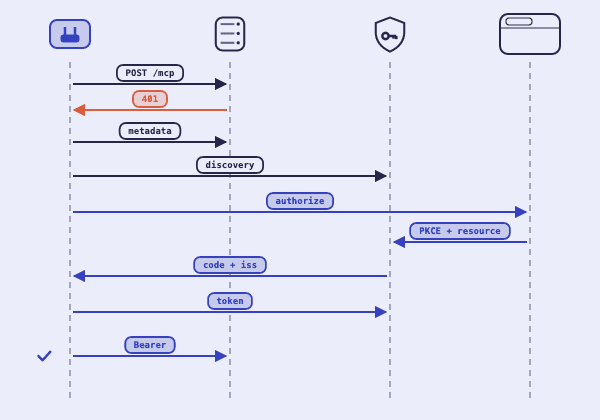
שלב 1: תשובת 401
ה-client שולח בקשה בלי token ומקבל 401 Unauthorized. בכותרת WWW-Authenticate השרת מציין resource_metadata, הכתובת של מסמך ה-Protected Resource Metadata שלו (RFC 9728). הוא צריך (SHOULD) לציין גם scope, ההרשאות שנדרשות לבקשה הזו.
אם אין resource_metadata בכותרת, ה-client חייב לנסות כתובות well-known לפי הסדר: קודם בנתיב של ה-endpoint, למשל /.well-known/oauth-protected-resource/mcp, ואחר כך בשורש, /.well-known/oauth-protected-resource.
בחירת scopes לפי המפרט: אם ב-401 יש scope, משתמשים בו. אחרת משתמשים בכל ה-scopes_supported שבמסמך ה-metadata, או בלי scope בכלל אם אין כאלה. זה עיקרון ה-least privilege: ה-client מבקש רק את מה שנדרש עכשיו, ומוסיף הרשאות בהמשך כשצריך (step-up, בהמשך הפרק).
POST /mcp HTTP/1.1
Host: notes.example.com
Content-Type: application/json
MCP-Protocol-Version: 2026-07-28
Mcp-Method: tools/call
Mcp-Name: search_notes

HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer resource_metadata="https://notes.example.com/.well-known/oauth-protected-resource/mcp",
                         scope="notes:read"
Protected Resource Metadata
מסמך ה-Protected Resource Metadata הוא JSON שהשרת מגיש. שרת MCP חייב לממש אותו, והמסמך חייב לכלול authorization_servers עם לפחות שרת הרשאות אחד. resource הוא ה-canonical URI של השרת, אותו מזהה שה-tokens יונפקו עבורו. scopes_supported הם ה-scopes הבסיסיים שהשרת מכיר.
אם רשומים כמה authorization servers, כל אחד מהם עצמאי, ו-client חייב לשמור רישום ו-tokens נפרדים לכל אחד. אסור להניח ש-credentials של אחד יתקבלו אצל אחר.
ה-canonical URI הוא הכתובת הספציפית ביותר של השרת, בלי fragment, ורצוי בלי / בסוף: https://notes.example.com/mcp. הוא חשוב, כי בשלב 4 הוא נשלח בפרמטר resource, ובשלב 5 השרת בודק שה-token הונפק בדיוק עבורו.
{
  "resource": "https://notes.example.com/mcp",
  "authorization_servers": [
    "https://auth.example.com"
  ],
  "scopes_supported": [
    "notes:read",
    "notes:write"
  ],
  "bearer_methods_supported": [
    "header"
  ]
}
שלב 2: גילוי ה-Authorization Server
מתוך authorization_servers, ה-client מביא את ה-metadata של שרת ההרשאות. הוא חייב לתמוך גם ב-OAuth Authorization Server Metadata (RFC 8414) וגם ב-OpenID Connect Discovery, ולנסות כתובות לפי סדר קבוע. ל-issuer עם נתיב, כמו https://auth.example.com/tenant1, הסדר הוא: oauth-authorization-server עם הכנסת הנתיב, openid-configuration עם הכנסת הנתיב, ואז openid-configuration בסוף הנתיב.
שתי בדיקות חובה על המסמך. הראשונה: ה-issuer במסמך חייב להיות זהה ל-issuer שממנו נבנתה הכתובת, אחרת לא משתמשים במסמך. זה חוסם שרת שמתחזה ל-issuer אחר. השנייה: code_challenge_methods_supported חייב להופיע. אם הוא חסר, השרת לא תומך ב-PKCE, וה-client חייב לסרב להמשיך. כשיש תמיכה, משתמשים ב-S256.
שדות נוספים שה-client מחפש: client_id_metadata_document_supported, שקובע איך יירשם (בשלב הבא), ו-authorization_response_iss_parameter_supported, שקובע איך יאמת את התשובה.
{
  "issuer": "https://auth.example.com",
  "authorization_endpoint": "https://auth.example.com/authorize",
  "token_endpoint": "https://auth.example.com/token",
  "response_types_supported": [
    "code"
  ],
  "grant_types_supported": [
    "authorization_code",
    "refresh_token"
  ],
  "code_challenge_methods_supported": [
    "S256"
  ],
  "client_id_metadata_document_supported": true,
  "authorization_response_iss_parameter_supported": true
}
שלב 3: רישום ה-client
לפני בקשת ההרשאה ה-client צריך client_id. יש שלוש דרכים, בסדר העדיפות של המפרט: קודם pre-registration, פרטים שהוגדרו מראש עבור שרת ההרשאות הזה. אחר כך Client ID Metadata Documents (CIMD), אם השרת מצהיר על client_id_metadata_document_supported. אחר כך Dynamic Client Registration (RFC 7591), אם יש registration_endpoint. ואם אין אף אחת, מבקשים מהמשתמש להזין את הפרטים.
ב-CIMD, ה-client_id הוא בעצמו כתובת HTTPS עם נתיב, שמצביעה על מסמך JSON עם פרטי ה-client. המסמך חייב לכלול client_id זהה לכתובת, client_name ו-redirect_uris. שרת ההרשאות מביא את המסמך, בודק שה-client_id תואם בדיוק, ומוודא שה-redirect_uri בבקשה מופיע ברשימה. זה פותר את המצב הנפוץ ב-MCP, שבו client ושרת לא הכירו קודם, בלי רישום מראש.
Dynamic Client Registration הוגדר deprecated ב-2026-07-28, ונשאר רק לתאימות עם שרתי הרשאות שלא תומכים ב-CIMD. client שמשתמש בו חייב לציין application_type (native לאפליקציות מקומיות ו-CLI, web לאפליקציות web מרוחקות). credentials שהתקבלו מרישום, או שהוגדרו מראש, חייבים להישמר לפי ה-issuer, ואסור להשתמש בהם מול שרת הרשאות אחר. client_id של CIMD, לעומת זאת, נייד בין שרתי הרשאות.
{
  "client_id": "https://app.example.com/oauth/client-metadata.json",
  "client_name": "Example MCP Client",
  "client_uri": "https://app.example.com",
  "redirect_uris": [
    "http://127.0.0.1:3000/callback",
    "http://localhost:3000/callback"
  ],
  "grant_types": [
    "authorization_code"
  ],
  "response_types": [
    "code"
  ],
  "token_endpoint_auth_method": "none"
}
שלב 4: בקשת הרשאה ו-token
ה-client מייצר זוג PKCE: code_verifier אקראי, ו-code_challenge שהוא ה-SHA-256 שלו בקידוד base64url. הוא שומר את ה-verifier, את ה-state ואת ה-issuer הצפוי, ופותח בדפדפן את ה-authorization endpoint עם client_id, redirect_uri, scope, state, code_challenge, code_challenge_method=S256, ו-resource.
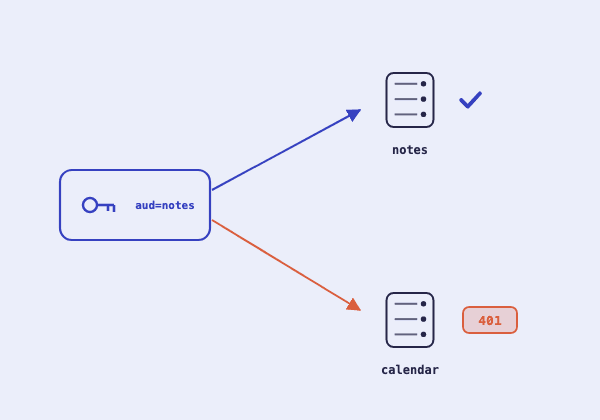
resource הוא החלק הייחודי ל-MCP (RFC 8707). הוא חייב להופיע גם בבקשת ההרשאה וגם בבקשת ה-token, עם ה-canonical URI של השרת, גם אם שרת ההרשאות לא תומך בו. כך ה-token נקשר לשרת MCP אחד. token שהונפק ל-notes-server לא יתקבל בשרת לוח שנה, גם אם אותו משתמש ואותו שרת הרשאות.
אחרי שהמשתמש מאשר, הדפדפן חוזר ל-redirect_uri עם code, state ו-iss. ה-client חייב לאמת את iss (RFC 9207) לפני שהוא שולח את ה-code לשום מקום: אם iss מופיע, הוא חייב להיות זהה ל-issuer שנשמר, בהשוואת מחרוזות פשוטה. אם השרת מצהיר על authorization_response_iss_parameter_supported ו-iss חסר, התשובה נדחית. זה חוסם mix-up attacks, שבהם שרת הרשאות זדוני מנסה לקבל code שהונפק על ידי שרת אחר. גם state נבדק. לבסוף ה-client שולח POST ל-token endpoint עם ה-code, ה-code_verifier וה-resource, ומקבל access token, ולפעמים גם refresh token.
GET /authorize?response_type=code
    &client_id=https%3A%2F%2Fapp.example.com%2Foauth%2Fclient-metadata.json
    &redirect_uri=http%3A%2F%2F127.0.0.1%3A3000%2Fcallback
    &scope=notes%3Aread
    &state=af0ifjsldkj
    &code_challenge=E9Melhoa2OwvFrEMTJguCHaoeK1t8URWbuGJSstw-cM
    &code_challenge_method=S256
    &resource=https%3A%2F%2Fnotes.example.com%2Fmcp HTTP/1.1
Host: auth.example.com

HTTP/1.1 302 Found
Location: http://127.0.0.1:3000/callback?code=SplxlOBeZQQYbYS6WxSbIA&state=af0ifjsldkj&iss=https%3A%2F%2Fauth.example.com

POST /token HTTP/1.1
Host: auth.example.com
Content-Type: application/x-www-form-urlencoded

grant_type=authorization_code&code=SplxlOBeZQQYbYS6WxSbIA
&redirect_uri=http%3A%2F%2F127.0.0.1%3A3000%2Fcallback
&client_id=https%3A%2F%2Fapp.example.com%2Foauth%2Fclient-metadata.json
&code_verifier=dBjftJeZ4CVP-mB92K27uhbUJU1p1r_wW1gFWFOEjXk
&resource=https%3A%2F%2Fnotes.example.com%2Fmcp
שלב 5: שימוש ב-token ובדיקתו בשרת
ה-client שולח את ה-token בכותרת Authorization: Bearer בכל בקשת HTTP, ואף פעם לא ב-query string. ואסור לו לשלוח לשרת token שלא הונפק על ידי שרת ההרשאות של אותו שרת.
השרת חייב לאמת כל token: חתימה (או introspection), issuer, תוקף, והכי חשוב, audience. ה-token חייב להיות מונפק במיוחד עבורו. token לא תקין או שפג תוקפו מקבל 401. token תקין בלי ההרשאות הדרושות מקבל 403 עם error של insufficient_scope, ה-scope הנדרש ו-resource_metadata. ה-client אז מבצע step-up: מבקש token חדש עם האיחוד של ה-scopes הקודמים והחדשים, כדי לא לאבד הרשאות, עם מגבלה על מספר הניסיונות.
הסקיצה מממשת את הבדיקה בצד השרת, והרצנו אותה על שבעה tokens לדוגמה: בלי כותרת, תקין, audience של שרת אחר, issuer זר, פג תוקף, חסר scope ו-token שבור. כל אחד קיבל את הסטטוס ואת ה-WWW-Authenticate הנכונים. ה-verifyJwt כאן הוא stub שלא בודק חתימה. בפרודקשן השתמשו בספריית JWT שמאמתת מול ה-JWKS של ה-issuer, או ב-requireBearerAuth של ה-SDK עם verifier משלכם. ל-refresh tokens: ה-client שומר אותם בצורה מאובטחת, ושרת ההרשאות צריך להנפיק access tokens קצרי חיים ולסובב refresh tokens של public clients.
const RESOURCE = "https://notes.example.com/mcp"; // ה-canonical URI של השרת הזה
const ISSUER = "https://auth.example.com";
const METADATA_URL = "https://notes.example.com/.well-known/oauth-protected-resource/mcp";

interface Claims { iss: string; aud: string | string[]; exp: number; sub: string; scope?: string }

// stub להדגמה בלבד: מפענח את ה-payload בלי לבדוק חתימה.
// בפרודקשן משתמשים בספריית JWT שמאמתת חתימה מול ה-JWKS של ה-issuer, או ב-introspection
function verifyJwt(token: string): Claims {
  const payload = token.split(".")[1];
  return JSON.parse(Buffer.from(payload, "base64url").toString("utf8"));
}

type AuthResult =
  | { ok: true; sub: string; scopes: string[] }
  | { ok: false; status: 401 | 403; wwwAuthenticate: string };

function challenge(status: 401 | 403, params: Record<string, string>): AuthResult {
  const all = { ...params, resource_metadata: METADATA_URL };
  const header = "Bearer " + Object.entries(all).map(([k, v]) => `${k}="${v}"`).join(", ");
  return { ok: false, status, wwwAuthenticate: header };
}

export function checkBearer(authorization: string | undefined, requiredScopes: string[], now = Date.now() / 1000): AuthResult {
  const match = /^Bearer (\S+)$/.exec(authorization ?? "");
  if (!match) return challenge(401, { scope: requiredScopes.join(" ") });

  let claims: Claims;
  try {
    claims = verifyJwt(match[1]);
  } catch {
    return challenge(401, { error: "invalid_token" });
  }
  const audiences = Array.isArray(claims.aud) ? claims.aud : [claims.aud];
  if (claims.iss !== ISSUER) return challenge(401, { error: "invalid_token", error_description: "unexpected issuer" });
  // בדיקת audience: token שהונפק לשירות אחר לא מתקבל כאן (RFC 8707)
  if (!audiences.includes(RESOURCE)) return challenge(401, { error: "invalid_token", error_description: "token was not issued for this server" });
  if (claims.exp <= now) return challenge(401, { error: "invalid_token", error_description: "token expired" });

  const scopes = (claims.scope ?? "").split(" ").filter(Boolean);
  if (requiredScopes.some((s) => !scopes.includes(s))) {
    return challenge(403, { error: "insufficient_scope", scope: requiredScopes.join(" ") });
  }
  return { ok: true, sub: claims.sub, scopes };
}
Token passthrough ו-confused deputy
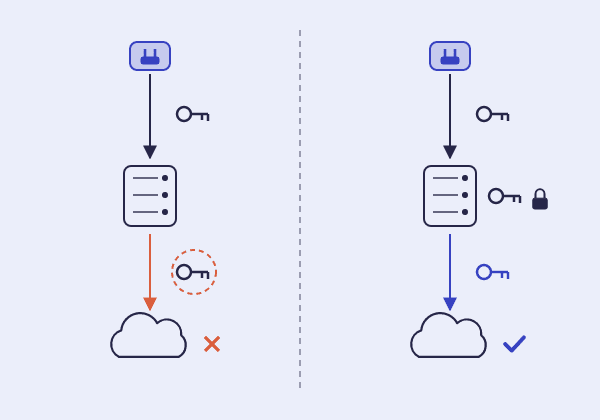
Token passthrough פירושו ששרת MCP מקבל token מה-client ומעביר אותו הלאה ל-API אחר. המפרט אוסר את זה במפורש: שרת לא יכול לקבל tokens שלא הונפקו עבורו, ולא יכול להעביר את ה-token שקיבל ל-API שמעליו. אם השרת צריך לקרוא ל-API חיצוני, הוא OAuth client בפני עצמו ומשתמש ב-token נפרד שהונפק לו על ידי שרת ההרשאות של אותו API. זה בדיוק התרחיש של elicitation במצב url מפרק 7, וה-tokens האלה נשמרים אצל השרת ולא עוברים ל-client.
למה זה כל כך חשוב? token שעובר הלאה עוקף את בקרות הגישה של השרת, מטשטש את ה-audit (ה-API רואה את המשתמש ולא את השרת), ופותח דרך לתוקף שהשיג token לשירות אחד להשתמש בו בשירות אחר. בדיקת audience בשרת והפרמטר resource ב-client הם שני הצדדים של אותה הגנה.
Confused deputy הוא מצב שבו שרת MCP שמשמש proxy ל-API של צד שלישי, עם client_id סטטי אחד מול אותו API, מנוצל כדי לקבל הרשאות בשם משתמש בלי שהמשתמש הסכים. תוקף יכול לנצל את ההסכמה שהמשתמש כבר נתן בעבר ל-client_id הסטטי, כדי לקבל code שיישלח אליו. ההגנה לפי המפרט: proxy כזה חייב לקבל הסכמה מהמשתמש לכל client שנרשם דינמית לפני שהוא מעביר אותו לשרת ההרשאות של הצד השלישי.
מודל האיומים: כלים שמשקרים
כבר ראינו בנושא AI Agents, בפרק Prompt Injection ואבטחת סוכנים, שתיאורי כלים משרת MCP נכנסים לקונטקסט, ושרת זדוני יכול להחביא בהם הוראות. זה tool poisoning: ההוראות משפיעות על השיחה גם אם הכלי עצמו אף פעם לא מופעל. עכשיו, כשאנחנו מכירים את ה-wire, אפשר לדייק איפה זה קורה. ה-description, ה-title, התיאורים שבתוך ה-inputSchema וה-instructions של server/discover הם כולם טקסט שהמודל קורא.
Rug pull: השרת חושף כלי תמים, המשתמש מאשר אותו, ומאוחר יותר השרת משנה את ההגדרה ושולח notifications/tools/list_changed. אם האישור נשמר לפי שם הכלי בלבד, הגרסה החדשה עוברת בלי שאלה. ההגנה בצד ה-host: לשמור hash של ההגדרה שאושרה, ולבקש אישור מחדש כשהיא משתנה. תיאור שמשתנה בלי סיבה ברורה הוא סימן אזהרה.
Shadowing: שרת אחד חושף כלי עם שם או תיאור שנועדו למשוך את המודל במקום כלי לגיטימי של שרת אחר, או מוסיף לתיאור הוראות על איך להשתמש בכלים של שרתים אחרים. namespacing לפי שרת (פרק 9), הצגת מקור כל כלי למשתמש, ואישור לפי זוג של שרת וכלי מצמצמים את זה.
הזרקה עקיפה, הרשאות ושרתים מקומיים
הזרקה עקיפה לא דורשת שרת זדוני. גם שרת לגיטימי מחזיר תוכן שמישהו אחר כתב: issue, מייל או דף wiki, בתוך תוצאת כלי, resource או הודעה של prompt. כל תוכן כזה הוא קלט לא אמין, וה-host לא יכול להבחין בו בין מידע להוראה. ההגנה החזקה ביותר, כמו שראינו בנושא AI Agents בפרק הרשאות ובטיחות, היא הגבלת יכולות: אישור לפעולות רגישות, והפרדה בין כלים שקוראים תוכן חיצוני לבין כלים שיכולים לשלוח מידע החוצה.
שרתים עם יותר מדי הרשאות: שרת שמחזיק token עם הרשאות מלאות, כשהוא צריך רק קריאה, הופך כל הזרקה לנזק גדול. least privilege חל על ה-credentials של השרת, על ה-scopes שה-client מבקש, ועל הכלים שה-host מאשר.
שרתים מקומיים: שרת stdio הוא קוד שרץ עם ההרשאות של המשתמש, ולכן התקנה שלו היא החלטת אבטחה, כמו כל תלות. מקור מהימן, גרסה נעולה, ובדיקה של מה שהפקודה בקונפיגורציה באמת מריצה. שרת HTTP מקומי חשוף ל-DNS rebinding: בדיקת Origin וכותרת Host, והאזנה ל-127.0.0.1 בלבד (פרקים 4 ו-8).
העקרונות של ה-spec מסכמים את כל זה: הסכמה ושליטה של המשתמש בכל גישה למידע ובכל פעולה, פרטיות, כלומר שלא מעבירים מידע של משתמש לשרת בלי הסכמה, ובטיחות כלים. כלים הם הרצת קוד שרירותי, ו-annotations הן לא-אמינות אלא אם השרת אמין. ה-spec עצמו מציין שהפרוטוקול לא יכול לאכוף את העקרונות האלה, והם באחריות מי שמממש.
Extensions: Tasks
Extensions הן יכולות אופציונליות מחוץ לליבה, ששני הצדדים מצהירים עליהן בשדה extensions של ה-capabilities (פרק 3). הן תמיד כבויות כברירת מחדל. הרשמיות משתמשות ב-prefix של io.modelcontextprotocol/, ואם רק צד אחד תומך, הוא חוזר להתנהגות הליבה או דוחה את הבקשה.
Tasks (io.modelcontextprotocol/tasks) פותר פעולות ארוכות: pipeline של CI, עיבוד batch או אישור של אדם. במקום להחזיק חיבור פתוח, השרת מחזיר בתשובה ל-tools/call תוצאה עם resultType של task, ובה taskId, סטטוס התחלתי, ttlMs ו-pollIntervalMs. ה-client שואל על הסטטוס ב-tasks/get עד שהוא מגיע לסטטוס סופי. הסטטוסים הם working, input_required, completed, failed ו-cancelled. ב-completed, ה-result מכיל את מה שהבקשה המקורית הייתה מחזירה.
כשהמשימה במצב input_required, התשובה ל-tasks/get כוללת inputRequests, וה-client עונה ב-tasks/update. tasks/cancel מבקש ביטול, אבל הביטול הוא שיתופי ולא מובטח. שרת יכול גם לשלוח notifications/tasks דרך subscriptions/listen, במקום polling. ה-taskId הוא handle עמיד: client שקרס יכול להמשיך לשאול עליו אחרי שהוא עולה מחדש. זה היישום הרשמי של רעיון ה-handles מפרק 3.
Extensions: MCP Apps, Skills ו-Auth
MCP Apps (io.modelcontextprotocol/ui) מאפשר לכלי להחזיר ממשק אינטראקטיבי במקום טקסט: גרף, טופס או נגן. הכלי מצביע ב-_meta.ui.resourceUri על resource מסוג ui:// שמכיל HTML. ה-host מרנדר אותו ב-iframe מבודד בתוך השיחה, והאפליקציה מדברת עם ה-host ב-postMessage, בניב של JSON-RPC עם methods שמתחילים ב-ui/. היא יכולה לבקש מה-host לקרוא לכלים, בכפוף למדיניות שלו. שרת כזה צריך להחזיר גם טקסט משמעותי, בשביל clients שלא תומכים בהרחבה.
Skills over MCP (io.modelcontextprotocol/skills) מחבר את ה-skills שראינו בנושא AI Agents, בפרק Skills, ל-MCP. שרת מגיש תיקיות skill עם SKILL.md וקבצים נלווים. skills/list ו-skills/get מחזירים את ה-frontmatter ורשימת קבצים עם SHA-256 וגודל, והתוכן עצמו נקרא ב-resources/read. ה-host חייב לאמת כל קובץ מול ה-digest, לקשור אישור של המשתמש לרשימת הקבצים המדויקת (כל שינוי מבטל אותו), ולהתייחס לתוכן כלא אמין.
הרחבות ה-Auth משלימות את ה-OAuth של הליבה בשני מקרים. OAuth Client Credentials מיועד ל-machine-to-machine, כמו שירות רקע או pipeline של CI בלי משתמש. Enterprise-Managed Authorization נועד לארגונים, כך שעובדים ניגשים לשרתי MCP דרך ה-IdP של הארגון, והמדיניות נאכפת במקום אחד. הדוגמה היא תשובת server/discover של שרת שמצהיר על שלוש הרחבות.
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "resultType": "complete",
    "supportedVersions": [
      "2026-07-28"
    ],
    "capabilities": {
      "tools": {},
      "resources": {},
      "extensions": {
        "io.modelcontextprotocol/tasks": {},
        "io.modelcontextprotocol/ui": {},
        "io.modelcontextprotocol/skills": {
          "directoryRead": false
        }
      }
    },
    "ttlMs": 3600000,
    "cacheScope": "public"
  }
}
סיכום הנושא
התחלנו מהשאלה מה MCP מתקנן, ומה הוא לא: host, client ו-server, primitives לפי מי ששולט בהם, ו-JSON-RPC כשכבת הבסיס (פרקים 1 ו-2). משם ירדנו ל-wire. בגרסה 2026-07-28 הפרוטוקול stateless, והגרסה והיכולות עוברות ב-_meta של כל בקשה. server/discover מחליף את ה-initialize. stdio הוא שורה לכל הודעה, ו-Streamable HTTP הוא POST לכל הודעה, עם כותרות שמשקפות את הגוף ו-subscriptions ארוכי טווח (פרקים 3 ו-4).
אחר כך עברנו על הסכמות של שלושת ה-primitives. tools עם inputSchema, outputSchema, structuredContent והבחנה בין שגיאת פרוטוקול לשגיאת ביצוע. resources עם URIs ו-templates. prompts עם completion. ו-MRTR, הדפוס שבו שרת מבקש מידע נוסף בלי להחזיק מצב, עם elicitation במצבי form ו-url (פרקים 5 עד 7).
ואז בנינו את שני הצדדים. שרת שלם עם ה-SDK, שרץ ב-stdio וב-HTTP ומשרת גם clients ישנים (פרק 8), ו-host שמחבר כמה שרתים ללולאה אגנטית אחת, עם namespacing, תרגום תוצאות, אישורים וניהול קונטקסט (פרק 9). והפרק הזה הוסיף את מה שהופך את כל זה לבטוח לפריסה: OAuth עם tokens שקשורים לשרת אחד, מודל איומים שמתחיל בהנחה שכל טקסט משרת הוא קלט לא אמין, ו-extensions שמרחיבים את הפרוטוקול בלי לשבור אותו.
ה-spec ימשיך להשתנות, כמו שהשתנה בין 2025-11-25 ל-2026-07-28. מה שנשאר יציב הוא המבנה: הודעות JSON-RPC עם מעטפה ברורה, capabilities שכל צד מצהיר עליהן, host שמחזיק את השליטה ואת ההסכמה, ושרתים פשוטים וממוקדים. מי שמבין את המבנה הזה יכול לקרוא כל גרסה חדשה של ה-spec, לזהות מה השתנה, ולהמשיך לבנות.