יסודות ה-AI
מה זה Generative AI?
מודל שפה גדול מאומן על כמויות עצומות של טקסט מהאינטרנט, ספרים, קוד ומאמרים מדעיים — הוא לומד דפוסים, תחביר, לוגיקה ועוד, ולא רק "משנן" מידע.
בניגוד למנוע חיפוש, ה-AI לא מאחזר תשובה קיימת אלא מייצר תגובה חדשה בכל פעם, מבוססת על הבנה של שפה והקשר.
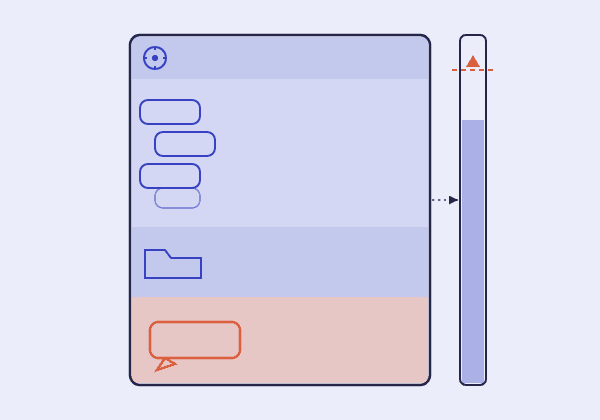
הוא גם מגיב בהקשר: זוכר את כל השיחה בתוך ה-context windowכל מה שהמודל "רואה" ברגע נתון: System Prompt, היסטוריית השיחה, קבצים, תוצאות כלים וההודעה הנוכחית. יש לו מגבלת טוקנים. מתוך LLM, יסודות ה-AI. שלו, כך שאפשר לתת לו הוראות, דוגמאות ורקע, והוא יתאים את התשובה בהתאם.
מה זה LLM (Large Language Model)?
LLM הוא רשת נוירונים ענקית, עם מיליארדי פרמטרים, שאומנה למשימה פשוטה למראה: לחזות מהי המילה (או ה-token) הבאה ברצף טקסט.
מתוך המשימה הפשוטה הזו צומחת יכולת שמאפשרת לו לסיים משפטים, לענות על שאלות ולכתוב קוד — הכל למעשה תחזית סטטיסטית של הטקסט הבא, ברמת דיוק גבוהה.
דוגמאות מוכרות: GPT-4, Claude, Gemini, Llama.
Context Window — הזיכרון של ה-AI
ה-context window הוא כל מה שה-AI "רואה" ברגע נתון: System Prompt (הוראה שמגדירה איך הוא אמור לענות), היסטוריית השיחה, קבצים או קוד רלוונטיים, תוצאות כלים, ולבסוף ה-User Message — הבקשה או השאלה בפועל.
יש ל-context window מגבלת טוקניםהיחידה הקטנה ביותר שממנה בנוי הטקסט מבחינת המודל: מילה שלמה, חלק ממילה, תו בודד או סימן פיסוק. מתוך LLM, איך בונים, מאמנים ומודדים LLM.. חריגה ממנה פוגעת ביכולת של המודל "לראות" את תחילת השיחה, וכל קריאה חדשה עולה כסף — ככל שה-context ארוך יותר, כך התשובה יקרה יותר.
לניהול חכם של context קיימות טכניקות כמו summarization (סיכום שיחה קודמת), RAGRetrieval-Augmented Generation: שליפת מידע רלוונטי מהמקורות שלכם והכנסתו לקונטקסט, כי LLM יודע רק את מה שהיה בנתוני האימון שלו. מתוך RAG, מבוא ל-RAG. (שליפת מידע רלוונטי לפי הצורך), selective contextלהשאיר בקונטקסט רק את מה שעדיין רלוונטי, ולכתוב את השאר לקובץ חיצוני שהסוכן קורא כשצריך. מתוך AI Agents, ניהול קונטקסט בלולאה אגנטית. (בחירה מה בכלל נכנס) ו-compression.
איך קוראים ל-API של AI מקוד?
קריאה ל-API של מודל שפה כוללת כמה שלבים קבועים: API Key (מפתח שמזהה אתכם), בחירת Model, בניית מערך messages (system + user + assistant), קבלת Response עם usage stats, וטיפול בשגיאות — rate limits, timeouts, retries.
// npm install @anthropic-ai/sdk
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.ANTHROPIC_API_KEY,
});

const response = await client.messages.create({
  model: 'claude-sonnet-5',
  max_tokens: 1024,
  messages: [{ role: 'user', content: 'כתוב לי פונקציית מיון' }],
});

console.log(response.content[0].text);
יסודות Prompt Engineering
System Prompt הוא ה"אישיות" של ה-AI: הוא מגדיר תפקיד, טון, מגבלות ופורמט תשובות, ונטען פעם אחת בתחילת השיחה.
Few-Shot Examples — מתן דוגמאות של input→output. ה-AI לומד את הפורמט הרצוי ומחקה אותו; לרוב 3-5 דוגמאות מספיקות.
Chain of Thought — בקשה מה-AI "לחשוב בשלבים" מייצרת reasoning מפורש, שמשפר דיוק בבעיות לוגיות ומתמטיות.
מבנה XML / JSON — בקשת פלט מובנהסכימה שמתארת את צורת התשובה הסופית, כך שה-agent מחזיר אובייקט שתואם לה ולא רק טקסט חופשי. מתוך LangChain, Structured Output. (למשל <answer>, <reasoning>, <code>) מקלה על parsing ומשפרת עקביות בתשובות.
טיפ מרכזי: "Be specific, not clever" — הוראות ברורות ומפורטות עדיפות על ניסיון להיות יצירתיים עם ה-prompt.
Tool Use / Function Calling
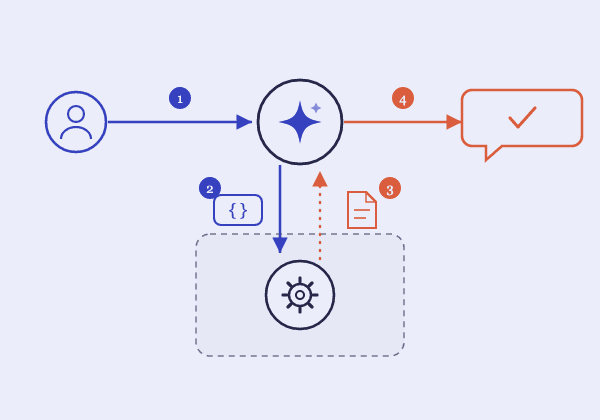
Tool use מאפשר ל-AI להפעיל פונקציות אמיתיות בקוד שלכם: המשתמש שולח הודעה, ה-AI מחליט — לא הקוד שלכם! — האם ומתי לקרוא לכלי, מקבל את התוצאה בחזרה כ-context, ומייצר תשובה סופית על בסיס התוצאה.
tools: [{
  name: 'get_weather',
  description: 'מזג אוויר לפי עיר',
  input_schema: {
    type: 'object',
    properties: {
      city: { type: 'string' }
    }
  }
}]
מה אפשר לעשות עם AI בפיתוח?
Code Generation — יצירת קוד, פונקציות, unit tests ו-boilerplate, בחיסכון משמעותי בזמן פיתוח.
Code Review — איתור באגים, בעיות אבטחה, ביצועים ועמידה ב-best practices.
Documentation — יצירת docstrings, README ו-API docs אוטומטית מהקוד.
Debugging — ניתוח stack traces, הצעת פתרונות והבנת הודעות שגיאה מורכבות.
Data Transformation — עיבוד CSV/JSON, המרת פורמטים וניקוי נתונים.
Natural Language to SQL — שאילתות SQL מטקסט חופשי, ללא צורך בידע SQL מוקדם.
שאלות נפוצות
למה אותו prompt מחזיר תשובה שונה בכל פעם?
כי המודל לא שולף תשובה שמורה אלא מייצר אותה מחדש: בכל צעד הוא מחשב הסתברות לכל טוקן אפשרי ודוגם מתוכן. הפרמטר temperature קובע כמה אקראית הדגימה — ערך נמוך נותן תשובות עקביות יותר, וערך גבוה נותן יותר גיוון. גם בערך 0 התשובות לא תמיד זהות לגמרי, ולכן לא כדאי לבנות קוד שמניח פלט קבוע.
האם המודל זוכר את השיחות הקודמות שלי?
לא מעצמו. המשקלים של המודל לא משתנים בזמן שימוש, וכל מה שהוא "זוכר" הוא מה שנמצא ב-context window של הקריאה הנוכחית. אפליקציות שנראות כאילו הן זוכרות שומרות את המידע בעצמן ומכניסות אותו שוב ל-context. האם הספק משתמש בשיחות כדי לאמן מודלים עתידיים זו שאלה של מדיניות, ואת התשובה מוצאים בתנאי השימוש שלו.
למה המודל לפעמים ממציא עובדות בביטחון מלא?
כי הוא חוזה את הטקסט הסביר ביותר, ולא בודק עובדות מול מאגר. כשאין לו את המידע, תשובה שנשמעת נכונה עדיין יכולה להיות הסבירה ביותר סטטיסטית. התופעה נקראת hallucination. מצמצמים אותה כשמכניסים את המידע הנדרש ל-context (למשל עם RAG), מבקשים מהמודל לומר במפורש כשהוא לא יודע, ומאמתים תשובות קריטיות.